Introducción
Este manual está pensado para cualquier persona que quiera entender cómo funcionan las bases de datos, sin importar si nunca escribió una línea de código. Vamos a aprender de a poco, con ejemplos del mundo real y diagramas que hacen más fácil entender las ideas.
A lo largo de estas páginas vas a descubrir:
-
Como está organizado el mundo de las bases de datos y quienes trabajan en el
-
Que es una base de datos y para qué sirve
-
Como se organiza la información en tablas
-
Como hacer preguntas (consultas) a la base de datos con SQL
No necesitas saber programación para entender este manual. Solo ganas de aprender.
Capítulo 1 - El ecosistema de las bases de datos
Antes de hablar de tablas y consultas, conviene entender el panorama completo: quienes interactúan con una base de datos, como se conectan a ella, y que es el software que la hace funcionar. Sin este contexto, el SQL queda flotando sin un lugar donde aterrizarlo.
El camino de una consulta: arquitectura cliente-servidor
Las bases de datos no existen solas. Siempre hay un conjunto de capas entre el usuario y los datos guardados en disco. Este modelo se llama arquitectura cliente-servidor y es la base de cómo funcionan prácticamente todos los sistemas informáticos modernos.
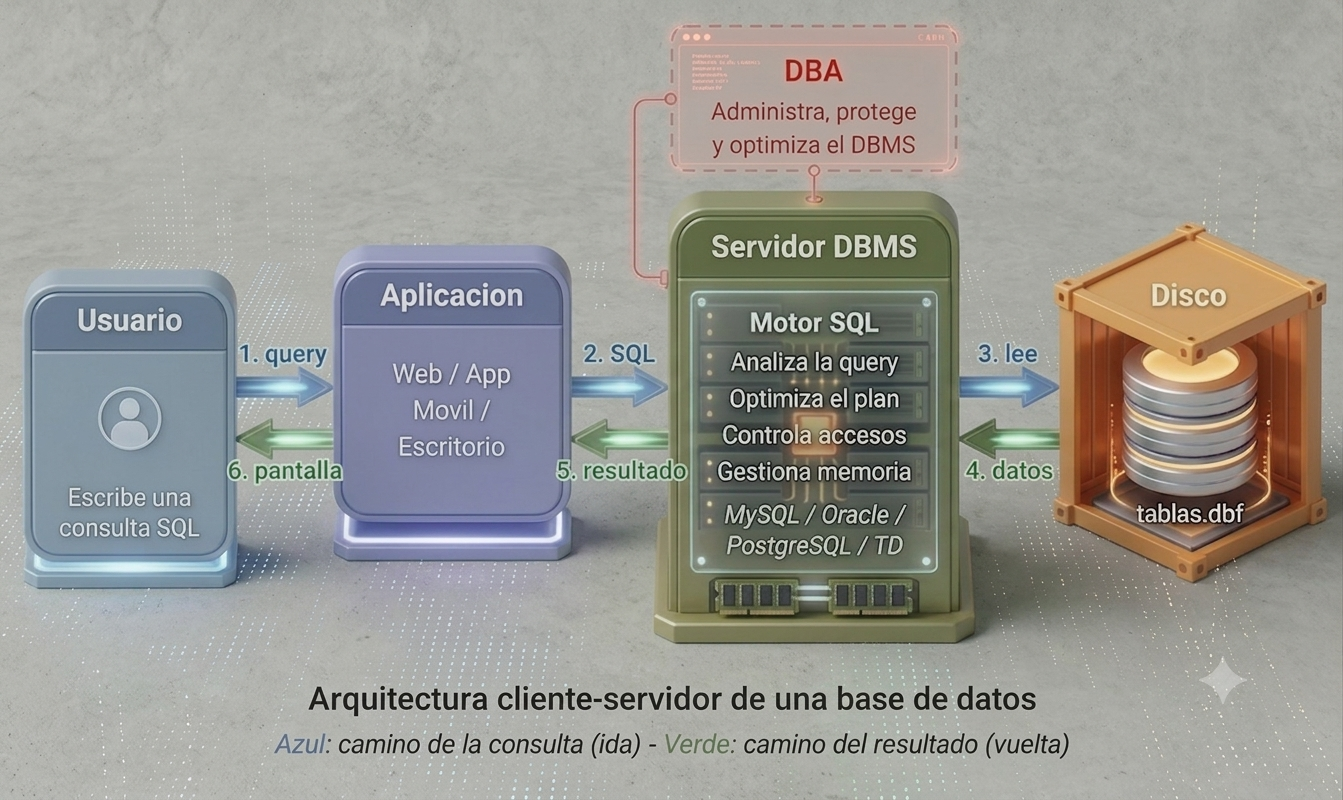
El camino completo de una consulta: desde el usuario hasta el disco y de vuelta
El recorrido completo de una consulta tiene seis pasos:
-
1. El usuario escribe o hace clic en algo que genera una consulta SQL.
-
2. La aplicación (web, móvil o escritorio) toma esa acción y construye la instrucción SQL correspondiente.
-
3. La aplicación envía el SQL al servidor DBMS a través de la red.
-
4. El motor analiza la consulta, la optimiza y lee los datos del disco.
-
5. El servidor devuelve el resultado a la aplicación.
-
6. La aplicación muestra los datos en pantalla al usuario.
Todo este ciclo, en una base de datos bien configurada, ocurre en milisegundos. Por ejemplo, cuando buscas un producto en Mercado Libre, este proceso completo sucede antes de que termines de leer la página.
El usuario final casi nunca escribe SQL directamente. Lo que hace el SQL siempre esta oculto detrás de botones, formularios y pantallas. El SQL lo escribe el desarrollador cuando programa la aplicación.
El DBMS: el motor que lo hace posible
DBMS significa Database Management System, o Sistema de Gestión de Bases de Datos. Es el software que se instala en el servidor y que hace de intermediario entre todas las aplicaciones y los datos guardados en disco.
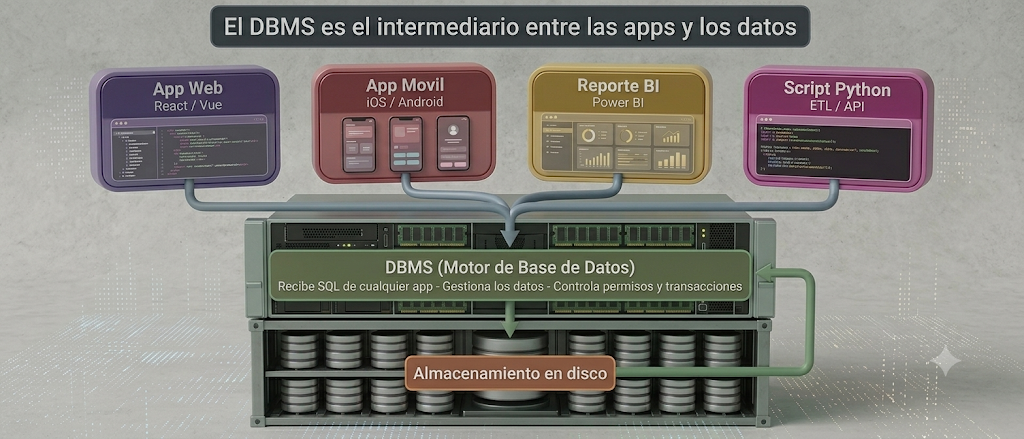
El DBMS recibe SQL de cualquier aplicación y gestiona el acceso a los datos
El DBMS se encarga de muchas cosas a la vez:
-
Recibir consultas SQL de múltiples aplicaciones simultáneamente.
-
Verificar que el usuario tenga permisos para hacer lo que pide.
-
Optimizar el plan de ejecución para que la consulta sea lo más rápida posible.
-
Gestionar las transacciones garantizando que los datos sean siempre consistentes.
-
Administrar la memoria y el disco para el almacenamiento eficiente.
Los DBMS relacionales más conocidos en la industria son:
| DBMS | Empresa | Uso típico |
| Oracle Database | Oracle Corp. | Grandes empresas, bancos, telecomunicaciones |
| Microsoft SQL Server | Microsoft | Empresas medianas/grandes, ecosistema Windows |
| PostgreSQL | Open Source | Startups, aplicaciones web, uso académico |
| MySQL / MariaDB | Oracle / OSS | Aplicaciones web, WordPress, e-commerce |
| Teradata | Teradata Corp. | Data warehouses, analítica masiva |
| SQLite | Open Source | Apps móviles, desarrollo local, prototipos |
Todos estos DBMS entienden SQL estándar, pero cada uno tiene sus propias extensiones y particularidades. Lo que aprendas en este manual aplica a todos ellos con mínimas diferencias de sintaxis.
Los roles: quienes trabajan con bases de datos
En el mundo de las bases de datos no hay un solo tipo de profesional. Cada rol tiene responsabilidades distintas y requiere un nivel diferente de conocimiento técnico.
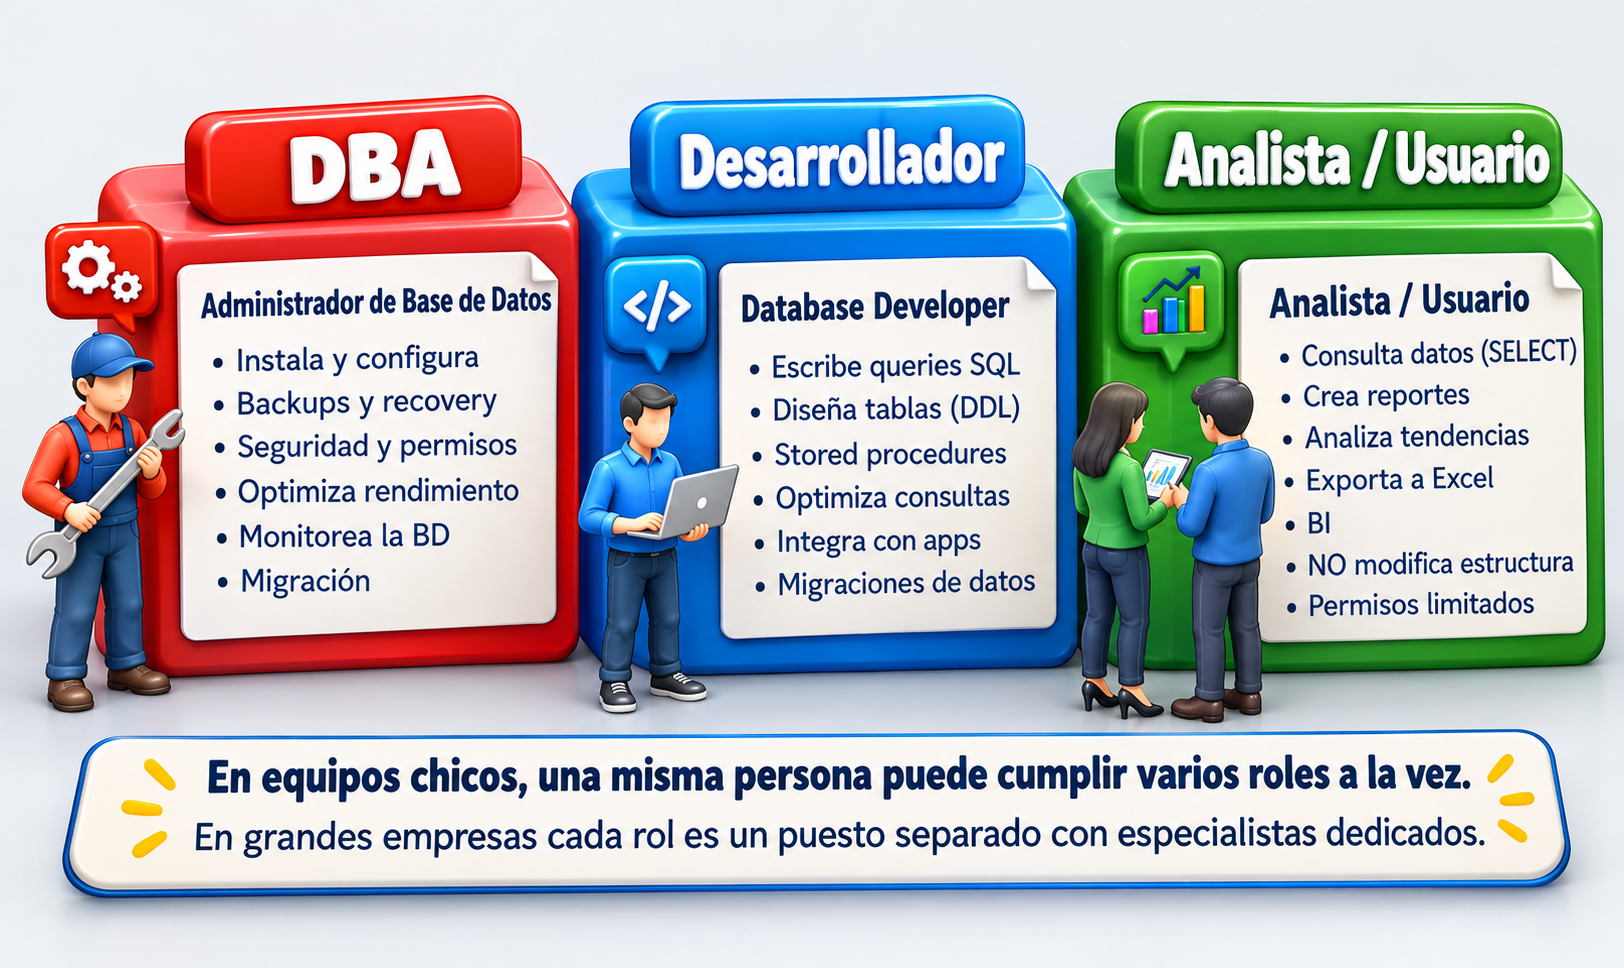
Los tres roles principales que conviven en el ecosistema de bases de datos
El DBA - Database Administrator
El DBA es el guardián de la base de datos. Su trabajo no es escribir queries del día a día sino asegurarse de que el sistema funcione siempre, que los datos estén seguros, y que todo responda rápido.
Un DBA es el profesional responsable de instalar, configurar, administrar, proteger y optimizar el motor de base de datos y toda la infraestructura que lo rodea.
Las responsabilidades concretas de un DBA incluyen:
-
instalación y configuración del servidor de base de datos y sus parámetros.
-
Backups y recuperación: automatizar respaldos diarios y saber cómo restaurarlos ante un desastre.
-
Seguridad: crear usuarios, asignar permisos, auditar accesos y proteger contra ataques.
-
Monitoreo y rendimiento: detectar consultas lentas, optimizar índices, ajustar memoria.
-
Migraciones: mover datos entre versiones, servidores o motores distintos.
-
Alta disponibilidad: configurar servidores de réplica para que, si uno cae, otro tome el control.
Un DBA en una empresa grande puede tener decenas o cientos de bases de datos bajo su responsabilidad. En una startup, el mismo desarrollador puede hacer de DBA además de escribir el código de la aplicación.
El Desarrollador de Base de Datos
El desarrollador trabaja con la estructura lógica de los datos: diseña las tablas, escribe las consultas SQL que usa la aplicación, crea vistas y procedimientos almacenados. Es quien traduce los requerimientos del negocio en estructuras y queries.
El Analista / Usuario Final
El analista o usuario de negocio consulta los datos para tomar decisiones. Puede saber SQL básico para hacer reportes, o puede usar herramientas de Business Intelligence que generan el SQL por él. En general no toca la estructura de las tablas ni administra el servidor.
Este manual está pensado para vos, que estas empezando. Sea que quieras ser desarrollador, analista o simplemente entender cómo funciona todo, el SQL es el lenguaje que une los tres roles.
Capítulo 2 – ¿Que es una base de datos?
Ahora que entendemos el ecosistema que rodea a las bases de datos, podemos entrar a lo que es en sí misma.
Una base de datos es un contenedor organizado que guarda tablas y otras estructuras de información relacionadas entre sí.
Cada vez que buscas algo en internet, compras en línea, retiras plata del cajero o reservas un turno médico, una base de datos está trabajando detrás de escena.
Imagínate un archivo físico enorme, con cajones ordenados, donde cada cajoncito contiene un tipo de información: clientes, productos, ventas, empleados. Eso es exactamente lo que hace una base de datos, pero en formato digital y a velocidades increíbles.
En diagramas, las bases de datos siempre se representan como cilindros
Muchas tablas adentro
Dentro de una base de datos no hay una sola tabla, sino muchas. Cada tabla guarda un tipo especifico de información. Por ejemplo, una empresa puede tener:
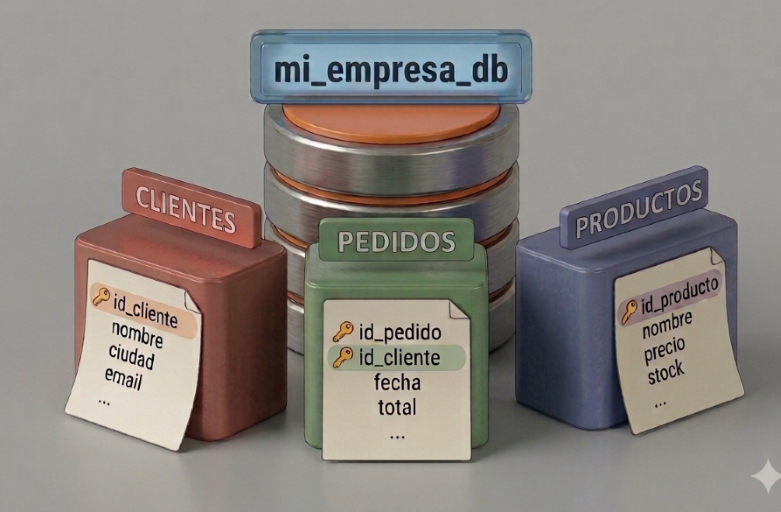
Una base de datos contiene muchas tablas relacionadas entre si
Pensa en la base de datos como un edificio y en las tablas como los departamentos dentro de ese edificio. Cada departamento tiene su propio contenido, pero todos son parte del mismo edificio.
Capítulo 3 - Tablas, filas y columnas
La tabla es la unidad básica de almacenamiento en una base de datos. Toda la información vive dentro de tablas. Y las tablas son como una hoja de cálculo: tienen filas y columnas.
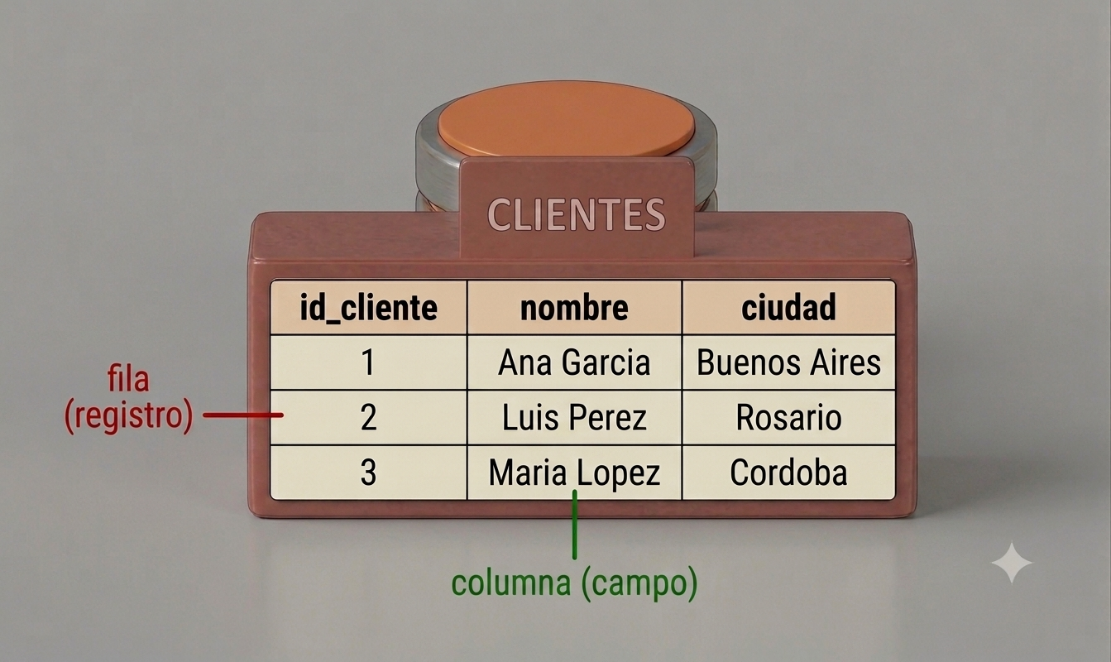
La tabla CLIENTES con sus filas (registros) y columnas (campos)
Las columnas (campos)
Las columnas definen la estructura de la tabla: que tipo de información se va a guardar. En la tabla CLIENTES tenemos las columnas id_cliente, nombre y ciudad. Cada columna tiene un nombre único y un tipo de dato.
Una columna define un atributo o característica de los datos. Todos los registros de la tabla tienen ese campo.
Las filas (registros)
Las filas son los datos reales. Cada fila representa un elemento concreto: un cliente, un producto, una venta. Cada fila es un conjunto de valores, uno por cada columna.
Una fila (o registro) representa una instancia concreta de los datos. Es un conjunto de valores, uno por cada columna.
La clave primaria (Primary Key)
En casi todas las tablas existe una columna especial llamada clave primaria. Esta columna tiene un valor único por cada fila y sirve para identificar cada registro sin confusión posible.
En la tabla CLIENTES, la columna id_cliente es la clave primaria. No puede haber dos clientes con el mismo id_cliente.
La clave primaria es como el DNI de cada fila: no puede repetirse ni estar vacía.
Capítulo 4 - SELECT: haciendo consultas
Ahora que entendemos como está organizada la información, es momento de aprender a pedirla. En SQL, la instrucción que usamos para consultar datos se llama SELECT.
SELECT es la instrucción SQL que le dice a la base de datos que datos queremos ver y de donde sacarlos.
La estructura básica
Todo SELECT tiene al menos dos partes obligatorias:
SELECT nombre_columna
FROM nombre_tabla;-
SELECT indica que columnas queremos ver en el resultado.
-
FROM indica de que tabla viene la información.
Un ejemplo completo
Para ver el nombre y la ciudad de todos los clientes:
SELECT nombre, ciudad
FROM clientes;
Traer todas las columnas con *
Si queres ver todas las columnas de una tabla, podes usar el asterisco (*) en lugar de escribir cada columna una por una:
SELECT *
FROM clientes;Usar SELECT * es practico para explorar una tabla, pero en aplicaciones reales es mejor pedir solo las columnas que necesitas. Hace la consulta más eficiente.
Filtrar con WHERE
Muchas veces no queremos todos los registros, sino solo los que cumplen una condición. Para eso usamos WHERE:
SELECT nombre, ciudad
FROM clientes
WHERE ciudad = 'Buenos Aires';
Esta consulta devuelve solo los clientes cuya ciudad es Buenos Aires.
Podemos usar operadores como =, >, <, >=, <=, <> (distinto) para construir las condiciones.
Resumen del capitulo
| Instrucción | Para que sirve |
| SELECT columna | Elige que columnas mostrar |
| SELECT * | Muestra todas las columnas |
| FROM tabla | Indica de que tabla sacar los datos |
| WHERE condición | Filtra las filas según una condición |
SQL no distingue entre mayúsculas y minúsculas para las palabras reservadas. SELECT es lo mismo que select. Sin embargo, por convención, se escriben en MAYUSCULAS para que sea más fácil leerlo.
Fin del Nivel 1. ¡Seguimos con el Nivel 2!
Nivel 2 — Conceptos Intermedios
ACID · Integridad de Datos · Índices y Rendimiento
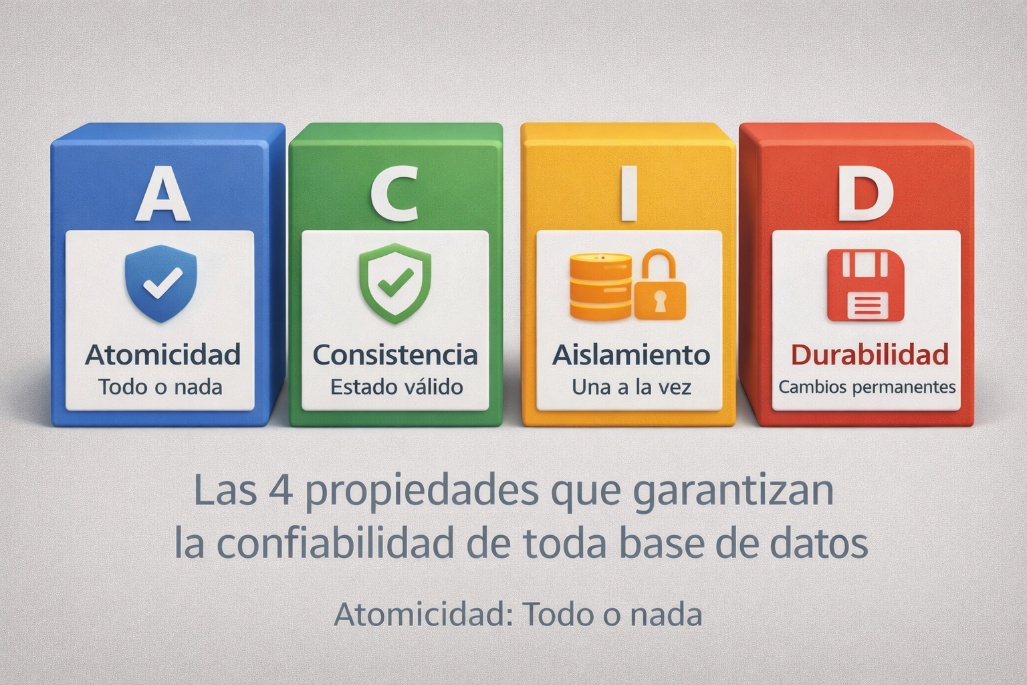
Las 4 propiedades ACID que sostienen toda base de datos confiable
“Basado en Database System Concepts, Silberschatz · Korth · Sudarshan (6a Ed.)”
Introducción al Nivel 2
En el Nivel 1 aprendiste que las bases de datos guardan información en tablas, con filas y columnas, y que el SELECT es la instrucción básica para consultarlas. Ahora es momento de ir un paso más allá y entender como las bases de datos garantizan que los datos son confiables, correctos y rápidos de acceder.
Este manual cubre tres grandes temas:
-
ACID: las 4 propiedades que toda transacción debe cumplir para ser confiable.
-
Integridad de Datos: las reglas que evitan que información inconsistente o invalida entre en la base de datos.
-
Índices: la técnica que hace que las consultas sean rápidas incluso con millones de registros.
Este manual toma como referencia el libro Database System Concepts (6a Ed.) de Abraham Silberschatz, Henry F. Korth y S. Sudarshan, publicado por McGraw-Hill. Es considerado la biblia del área y se usa en universidades de todo el mundo.
Capítulo 1 — Transacciones y propiedades ACID
Antes de hablar de ACID, necesitamos entender que es una transacción.
| Una transacción es una secuencia de operaciones que la base de datos ejecuta como una sola unidad lógica de trabajo. O se ejecuta completa, o no se ejecuta en absoluto. |
|---|
Cuando retiras plata de un cajero automático, cuando pagas en Mercado Libre, cuando reservas un turno médico, detrás de escena una base de datos está ejecutando una transacción. Cada una de estas acciones implica modificar varios registros a la vez y todas deben completarse juntas o fallar juntas.
La pregunta que surge naturalmente es: ¿cómo garantizo que esto siempre sea confiable? La respuesta son las propiedades ACID.
Las 4 propiedades ACID
El acrónimo ACID describe cuatro características que toda transacción debe tener para que una base de datos sea confiable. Fue formalizado por Jim Gray y Andreas Reuter a fines de los años 80, y sigue siendo el estándar de la industria hasta hoy.
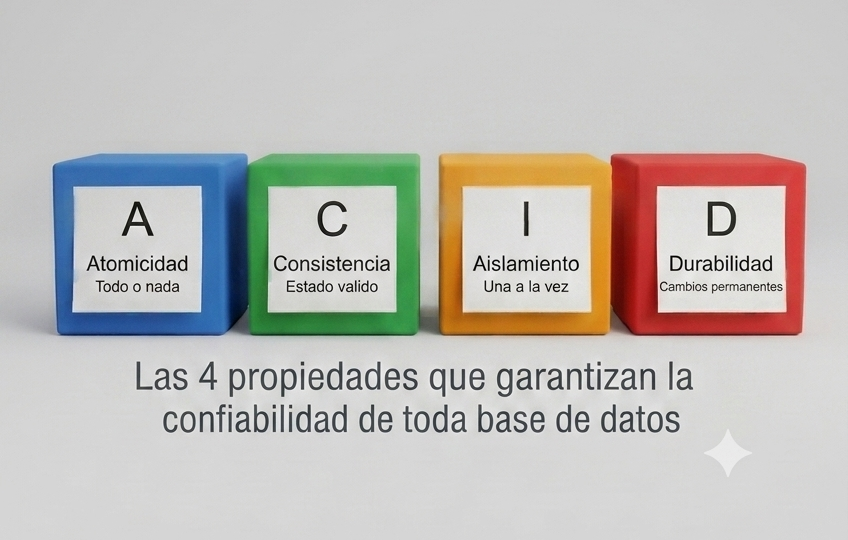
Las cuatro propiedades ACID
A — Atomicidad (Atomicity)
La atomicidad garantiza que una transacción se ejecuta completamente o no se ejecuta en absoluto. No existe un estado intermedio visible para el resto del sistema.
El ejemplo clásico, usado por Silberschatz y también por Bernstein & Newcomer en Principles of Transaction Processing, es una transferencia bancaria:
BEGIN;
UPDATE cuentas SET saldo = saldo - 300 WHERE id = 'A'; -- debita
UPDATE cuentas SET saldo = saldo + 300 WHERE id = 'B'; -- acredita
COMMIT;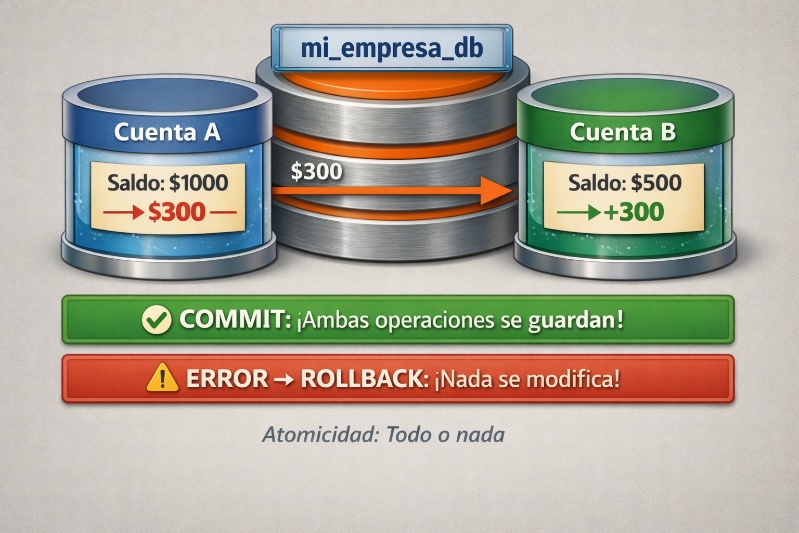
Si el sistema falla entre los dos UPDATE, el ROLLBACK deshace todo
Si el sistema falla después del primer UPDATE y antes del segundo, la cuenta A perdido $300 pero la cuenta B nunca los recibió. Sin atomicidad, ese dinero desaparecería del sistema. La atomicidad previene exactamente eso: si algo falla, la base de datos deshace (rollback) todos los cambios parciales.
La finalización exitosa de una transacción se llama COMMIT. Si algo falla, se ejecuta un ROLLBACK que deja la base de datos exactamente como estaba antes de que empezara la transacción.
Pensa en la atomicidad como un “todo o nada”. Es lo que hace que un sistema de pagos sea confiable: jamás podes perder plata a mitad de una operación.
C — Consistencia (Consistency)
La consistencia garantiza que una transacción lleva la base de datos de un estado valido a otro estado valido. Nunca deja los datos en un estado que viole las reglas definidas.
Por ejemplo, si una regla dice que el saldo de una cuenta bancaria no puede ser negativo, ninguna transacción puede dejar esa condición violada. Si la transacción intentara dejar el saldo en -$50, la base de datos la rechazaría.
Silberschatz define consistencia como que la base de datos satisface todas sus restricciones de integridad en todo momento. Ejemplos de estas restricciones:
-
Todos los valores de clave primaria deben ser únicos.
-
Una referencia entre tablas debe apuntar a un registro que exista (integridad referencial).
-
Un campo definido como NOT NULL nunca puede estar vacío.
-
Un campo edad no puede tener el valor -10.
La consistencia es una responsabilidad compartida entre la base de datos y el programador. El motor garantiza las restricciones técnicas, pero las reglas de negocio más complejas dependen de quien escribe el código de la transacción.
I — Aislamiento (Isolation)
El aislamiento garantiza que las transacciones concurrentes no se interfieren entre sí. Aunque miles de usuarios estén accediendo a la base al mismo tiempo, cada transacción debe comportarse como si fuera la única que se está ejecutando.
El ejemplo canónico de Bernstein & Newcomer ilustra el problema perfectamente:
-- Dos usuarios intentan retirar $100 de la misma cuenta (saldo: $100)
-- Usuario 1: -- Usuario 2:
SELECT saldo FROM cuenta SELECT saldo FROM cuenta
WHERE id = 'X'; -- lee $100 WHERE id = 'X'; -- lee $100
UPDATE cuenta SET saldo = 0 UPDATE cuenta SET saldo = 0
WHERE id = 'X'; WHERE id = 'X';
-- Ambos retiran $100! Saldo final incorrecto.
Sin aislamiento, ambas transacciones leen $100, ambas creen que hay suficiente saldo, y ambas retiran $100. El banco pierde $100 que no correspondía. El aislamiento previene esto asegurando que una transacción no pueda leer datos que otra está modificando al mismo tiempo.
El mecanismo más común para lograr aislamiento son los locks (bloqueos): la primera transacción bloquea el registro, la segunda espera hasta que la primera termine.
D — Durabilidad (Durability)
La durabilidad garantiza que una vez que una transacción se confirma (COMMIT), sus cambios son permanentes, incluso si el sistema falla inmediatamente después.
Según Silberschatz (Database System Concepts, Cap. 14), la durabilidad se logra escribiendo los cambios en un archivo de log (bitácora) en almacenamiento estable antes de confirmar la transacción. Si el sistema se cae, al reiniciar lee ese log y recupera todos los cambios de las transacciones que habían hecho COMMIT.
La durabilidad es el equivalente digital de un contrato firmado. Cuando un cajero te dice “su retiro fue exitoso”, la base de datos garantiza que ese cambio es permanente sin importar lo que le pase al servidor dos segundos después.
ACID no es opcional. Es el contrato de confianza entre la base de datos y las aplicaciones que la usan. Sin estas garantías, sistemas como los bancarios, de salud o de reservas aéreas simplemente no podrían funcionar.
BEGIN, COMMIT y ROLLBACK en la practica
En SQL estándar, una transacción se controla con tres instrucciones:
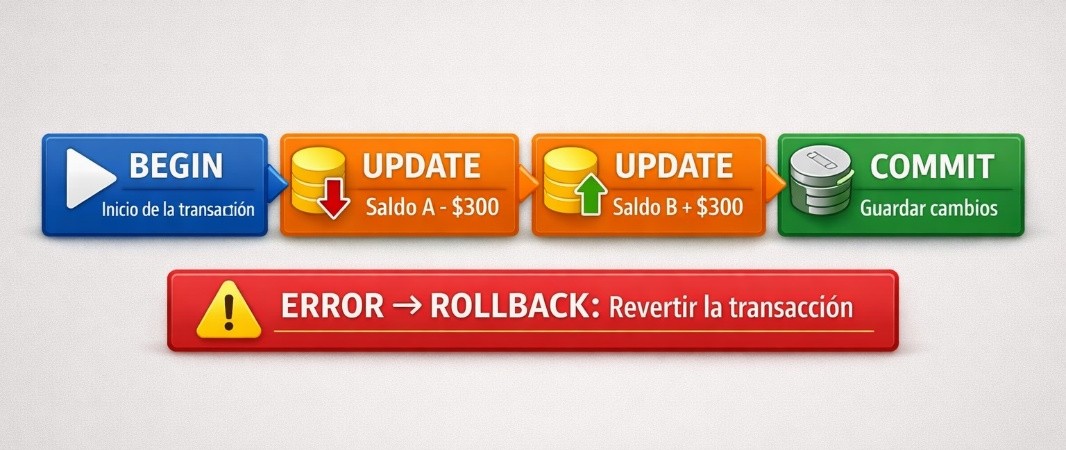
Ciclo de vida de una transacción: BEGIN → operaciones → COMMIT o ROLLBACK
BEGIN; -- Inicia la transacción
UPDATE cuentas SET saldo = saldo - 500 WHERE id_cliente = 1;
INSERT INTO movimientos VALUES (1, -500, NOW());
COMMIT; -- Confirma y guarda todo permanentemente
-- Si hubiera habido un error:
-- ROLLBACK; -- Deshace todo desde el BEGIN| Instrucción | Que hace |
|---|---|
| BEGIN | Marca el inicio de una transacción. Todo lo que sigue es parte de ella. |
| COMMIT | Confirma todos los cambios y los hace permanentes en la base de datos. |
| ROLLBACK | Deshace todos los cambios de la transacción actual. La BD vuelve al estado anterior. |
Capítulo 2 — Integridad de Datos
La integridad de datos es el conjunto de reglas que garantiza que la información almacenada sea correcta, coherente y confiable. Silberschatz la define como el conjunto de restricciones que la base de datos verifica automáticamente para preservar la validez de los datos.
| La integridad de datos es la propiedad que asegura que los datos son exactos, consistentes y validos en todo momento, cumpliendo las reglas definidas por el modelo de datos. |
|---|
Existen tres tipos principales de integridad, cada uno enfocado en un aspecto diferente:
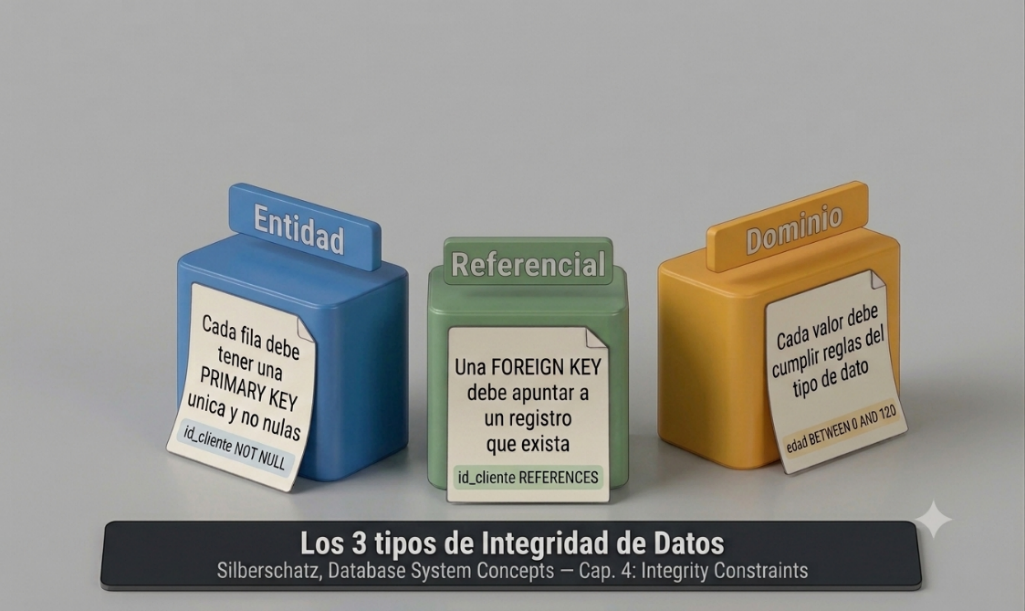
Los tres tipos de integridad segun Silberschatz, Cap. 4
1. Integridad de Entidad
La integridad de entidad establece que cada fila de una tabla debe tener una clave primaria (PRIMARY KEY) con un valor único y no nulo. Esta regla garantiza que cada registro pueda ser identificado de forma inequívoca.
CREATE TABLE clientes (
id_cliente INT PRIMARY KEY, -- único y NOT NULL automáticamente
nombre VARCHAR(100) NOT NULL,
email VARCHAR(150) UNIQUE
);
-- Esto fallaría: id_cliente NULL no está permitido
INSERT INTO clientes (id_cliente, nombre) VALUES (NULL, 'Juan');
-- Esto también fallaría: id_cliente 1 ya existe
INSERT INTO clientes (id_cliente, nombre) VALUES (1, 'Pedro');La PRIMARY KEY implica automáticamente NOT NULL + UNIQUE. No hace falta declararlo por separado.
2. Integridad Referencial
La integridad referencial garantiza que las relaciones entre tablas sean coherentes. Si una tabla tiene una columna que hace referencia a otra tabla (FOREIGN KEY), el valor referenciado debe existir en la tabla de origen.
Ejemplo: la tabla PEDIDOS tiene una columna id_cliente que referencia a la tabla CLIENTES. No puede existir un pedido de un cliente que no existe.
CREATE TABLE pedidos (
id_pedido INT PRIMARY KEY,
id_cliente INT NOT NULL,
total DECIMAL(10,2),
-- Clave foranea: id_cliente debe existir en la tabla clientes
FOREIGN KEY (id_cliente) REFERENCES clientes(id_cliente)
);
-- Esto fallaría si el cliente 99 no existe:
INSERT INTO pedidos (id_pedido, id_cliente, total) VALUES (1, 99, 150.00);Si intentas borrar un cliente que tiene pedidos asociados, la base de datos lo rechaza por defecto. Primero hay que borrar los pedidos, o usar ON DELETE CASCADE para que se borren automáticamente.
3. Integridad de Dominio
La integridad de dominio garantiza que los valores de cada columna sean del tipo y rango correcto. Se define al crear la tabla con tipos de datos, restricciones CHECK, valores por defecto y la constraint NOT NULL.
CREATE TABLE empleados (
id_empleado INT PRIMARY KEY,
nombre VARCHAR(100) NOT NULL,
edad INT CHECK (edad >= 18 AND edad <= 70),
salario DECIMAL(10,2) CHECK (salario > 0),
categoria VARCHAR(20) CHECK (categoria IN ('Junior','Senior','Lead')),
activo CHAR(1) DEFAULT 'S'
);
-- Estos INSERT fallarían:
INSERT INTO empleados VALUES (1, 'Juan', 15, 50000, 'Junior', 'S'); -- edad < 18
INSERT INTO empleados VALUES (2, 'Ana', 30, -100, 'Senior', 'S'); -- salario < 0
INSERT INTO empleados VALUES (3, 'Luis', 25, 60000, 'Intern', 'S'); -- categoría invalida| Tipo de Integridad | Que protege | Herramienta SQL |
|---|---|---|
| Entidad | Unicidad e identificación de cada fila | PRIMARY KEY |
| Referencial | Coherencia entre tablas relacionadas | FOREIGN KEY … REFERENCES |
| Dominio | Validez de los valores en cada columna | CHECK, NOT NULL, DEFAULT, tipos de datos |
Capítulo 3 — Índices y Rendimiento
Hasta ahora vimos como la base de datos organiza y protege los datos. Pero ¿que pasa cuando la tabla tiene un millón de registros y necesitas encontrar uno en particular? Sin un mecanismo especial, la base de datos tendría que leer cada fila una por una. Ahí entran los índices.
| Un índice es una estructura de datos separada que la base de datos mantiene para encontrar registros rápidamente, sin tener que leer toda la tabla. |
|---|
El problema: el full table scan
Cuando ejecutas una consulta como esta:
| SELECT * FROM clientes WHERE apellido = ‘Lopez’; |
|---|
Si no existe un índice sobre la columna apellido, la base de datos tiene que leer absolutamente todas las filas de la tabla para ver cuales tienen apellido = ‘Lopez’. Esto se llama full table scan (escaneo completo de tabla).
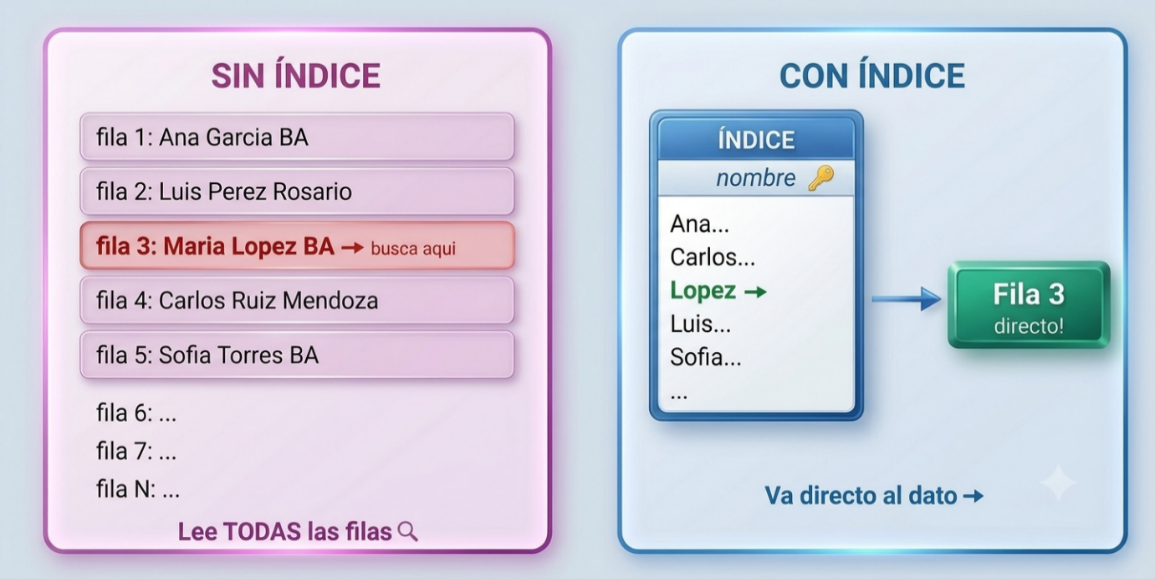
Sin índice: lee todas las filas. Con índice: va directo al dato.
Para tablas chicas esto es tolerable. Pero si la tabla tiene 10 millones de filas, leerlas todas puede tomar segundos o minutos. Con un índice, la misma consulta puede resolverse en milisegundos.
El índice funciona como el índice al final de un libro: en lugar de leer todas las páginas para encontrar una palabra, vas al índice, buscas la palabra alfabéticamente y saltas directo a la página correcta.
Como funciona internamente: el B-Tree
El tipo de índice más común en bases de datos relacionales es el B-Tree (Balanced Tree — árbol balanceado). Silberschatz lo explica en detalle en el Capítulo 11 de Database System Concepts.
La idea central es simple: el índice guarda los valores de la columna indexada en orden, junto con punteros a la posición real de cada fila en la tabla. Para buscar un valor, el motor sigue el árbol de arriba hacia abajo, descartando enormes porciones de datos en cada nivel.
-- búsqueda con B-Tree en una tabla de 1.000.000 de filas:
Sin índice: O(n) → hasta 1.000.000 lecturas
Con índice: O(logN) → solo 3 o 4 lecturas
-- Diferencia de rendimiento: miles de veces más rápido
La eficiencia logarítmica O(log n) significa que, aunque la tabla crezca de 1 millón a 1000 millones de registros, la búsqueda con índice solo necesita unos pocos pasos más. El rendimiento crece de forma predecible y controlada.
Como crear y usar índices en SQL
Crear un índice es muy sencillo. Se usa la instrucción CREATE INDEX:
-- Índice simple sobre una columna
CREATE INDEX idx_clientes_apellido
ON clientes (apellido);
-- Índice sobre varias columnas (índice compuesto)
CREATE INDEX idx_pedidos_fecha_estado
ON pedidos (fecha, estado);
-- Índice único (evita duplicados, como un UNIQUE constraint)
CREATE UNIQUE INDEX idx_clientes_email
ON clientes (email);
Una vez creado el índice, la base de datos lo usa automáticamente cuando ejecutas consultas que filtran por esa columna. No necesitas hacer nada especial en el SELECT.
-- Esta consulta usara automáticamente idx_clientes_apellido:
SELECT * FROM clientes WHERE apellido = 'Garcia';
-- Esta usara idx_pedidos_fecha_estado:
SELECT * FROM pedidos WHERE fecha = '2025-01-01' AND estado = 'pendiente';
La contraparte: índices y escritura
Los índices no son gratis. Mejoran mucho las lecturas, pero tienen un costo en las escrituras. Cada vez que insertas, modificas o borras un registro, la base de datos también tiene que actualizar todos los índices de esa tabla.
| Operacion | Sin índice | Con índice |
|---|---|---|
| SELECT / WHERE | Lento (full scan) | Muy rápido (B-Tree) |
| INSERT | Rápido | Mas lento (actualiza el índice) |
| UPDATE | Lento (busca) + rápido (modifica) | Rápido (busca) + más lento (actualiza índice) |
| DELETE | Lento (busca) | Rápido (busca) + actualiza índice |
No hay que indexar todas las columnas. Demasiados índices hacen lentas las inserciones y ocupan espacio en disco. La regla general: indexa las columnas que aparecen frecuentemente en clausulas WHERE, JOIN, y ORDER BY.
Cuándo crear un índice: reglas practicas
-
Columnas usadas en WHERE frecuentes: si siempre filtras por email o DNI, ponele un índice.
-
Claves foráneas (FOREIGN KEY): casi siempre conviene indexarlas para que los JOINs sean rápidos.
-
Columnas de ORDER BY: si ordenas frecuentemente por una columna, el índice evita que la base de datos tenga que ordenar en cada consulta.
-
No indexar columnas con pocos valores distintos: una columna activa con solo ‘S’ o ‘N’ no se beneficia de un índice, porque la base de datos igual tendría que leer la mitad de las filas.
-
Tablas muy pequeñas: para tablas de menos de 1000 filas, el full scan suele ser igual de rápido y el índice no aporta valor.
Una forma de saber si un índice está siendo usado es con el comando EXPLAIN antes del SELECT. La base de datos te muestra como planea ejecutar la consulta y si usa o no el índice.
-- Ver el plan de ejecución de una consulta:
EXPLAIN SELECT * FROM clientes WHERE apellido = 'Lopez';
-- Si dice 'Index Scan' → usa el índice OK
-- Si dice 'Seq Scan' o 'Full Table Scan' → NO usa el índice ERROR
Resumen del Nivel 2
En este manual vimos tres conceptos fundamentales que hacen a una base de datos confiable y eficiente:
| Concepto | Que garantiza | Palabras clave |
|---|---|---|
| Atomicidad (ACID-A) | Las operaciones son todo o nada | BEGIN, COMMIT, ROLLBACK |
| Consistencia (ACID-C) | Los datos cumplen las reglas del negocio | Constraints, reglas de integridad |
| Aislamiento (ACID-I) | Las transacciones no se interfieren | Locks, serializabilidad |
| Durabilidad (ACID-D) | Los COMMIT son permanentes | Log de transacciones, recovery |
| Integridad de Entidad | Cada fila tiene ID única y no nula | PRIMARY KEY, NOT NULL |
| Integridad Referencial | Las relaciones entre tablas son validas | FOREIGN KEY, REFERENCES |
| Integridad de Dominio | Los valores están dentro del rango correcto | CHECK, tipos de datos, DEFAULT |
| Índices | Las consultas son rápidas en tablas grandes | CREATE INDEX, B-Tree, EXPLAIN |
Con estos conceptos ya tenes una base sólida para entender cómo funciona una base de datos a nivel profesional. El próximo nivel introduce los JOINs para combinar tablas, las funciones de agregación (COUNT, SUM, AVG) y el modelo entidad-relación para diseñar esquemas desde cero.
Fin del Nivel 2 Parte 1 — Seguimos en el Nivel 2: Parte 2
Nivel 2 - Parte 2
Tipos de Datos - NULL - DDL - DML - Agregaciones - Filtros - Vistas
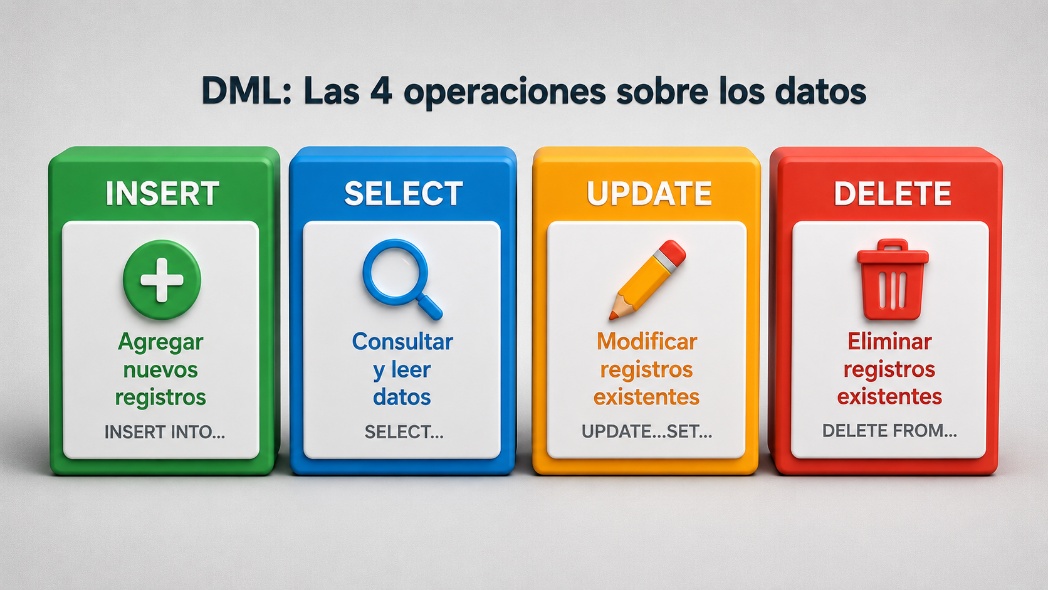
Las cuatro operaciones fundamentales sobre los datos
“Basado en Database System Concepts, Silberschatz - Korth - Sudarshan (6a Ed.)”
Introducción
La Parte 1 del Nivel 2 cubrió ACID, integridad de datos e índices. Esta segunda parte completa el nivel intermedio con los temas que hacen falta para trabajar de forma profesional con una base de datos: como se definen los tipos de cada columna, como se carga y modifica la información, como se agrupa para obtener resúmenes, y como se simplifican las consultas con vistas.
-
Capítulo 1: Tipos de datos y NULL
-
Capítulo 2: DDL completo - CREATE, ALTER y DROP TABLE
-
Capítulo 3: DML - INSERT, UPDATE y DELETE
-
Capitulo 4: ORDER BY, LIMIT y filtros avanzados (LIKE, IN, BETWEEN, IS NULL)
-
Capítulo 5: Funciones de agregación y GROUP BY / HAVING
-
Capítulo 6: Vistas (VIEW)
Capítulo 1 - Tipos de datos y NULL
Tipos de datos
Cuando creamos una tabla, cada columna necesita un tipo de dato. El tipo le dice a la base de datos que clase de información puede almacenarse en esa columna, cuanto espacio reservar, y que operaciones son válidas sobre ella. Según Silberschatz (Cap. 3 - SQL Data Definition), el SQL estándar define un conjunto de tipos básicos que todos los motores implementan.
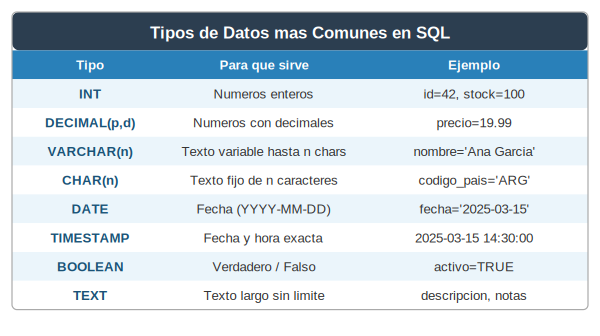
Los tipos de datos más usados en SQL estándar
Tipos numéricos
Para guardar números enteros se usa INT (o INTEGER). Para números con parte decimal, DECIMAL(p,d) donde p es el total de dígitos y d son los decimales. Por ejemplo, DECIMAL(10,2) acepta hasta 10 dígitos con 2 decimales, ideal para precios.
id_producto INT -- 1, 2, 3, 42, -5
precio DECIMAL(10,2) -- 19.99, 1250.00, 0.50
cantidad SMALLINT -- entero pequeño: 0 a 32767
distancia_km FLOAT -- 3.14159, 2.71828 (precisión variable)
Tipos de texto
Para texto de longitud variable se usa VARCHAR(n), donde n es el máximo de caracteres. Si el texto es siempre de la misma longitud fija (como códigos o iniciales), se usa CHAR(n). Para textos muy largos sin límite definido existe TEXT.
nombre VARCHAR(100) -- hasta 100 caracteres, longitud variable
codigo_pais CHAR(3) -- siempre 3 caracteres: 'ARG', 'BRA', 'USA'
descripcion TEXT -- texto largo sin límite predefinidoVARCHAR es más eficiente que CHAR cuando las cadenas tienen longitudes muy variables. CHAR siempre ocupa n bytes aunque el texto sea más corto, mientras que VARCHAR ocupa solo lo necesario.
Tipos de fecha y hora
Las fechas y horas tienen sus propios tipos para poder hacer cálculos (diferencia entre fechas, filtrar por mes, ordenar cronológicamente). Guardarlas como texto es un error clásico de principiantes.
fecha_nacimiento DATE -- '1990-05-23' (solo fecha)
hora_apertura TIME -- '08:30:00' (solo hora)
creado_en TIMESTAMP -- '2025-03-15 14:30:00' (fecha y hora)
-- Con DATE podemos hacer operaciones que con VARCHAR no podemos:
SELECT * FROM clientes WHERE fecha_nacimiento > '2000-01-01';
SELECT DATEDIFF(NOW(), fecha_pedido) AS dias_transcurridos FROM pedidos;
Otros tipos útiles
activo BOOLEAN -- TRUE o FALSE (1 o 0)
foto BLOB -- datos binarios: imágenes, archivos| Tipo | Grupo | Uso tipico |
|---|---|---|
| INT, SMALLINT, BIGINT | Numérico entero | IDs, cantidades, edades |
| DECIMAL(p,d), FLOAT | Numérico decimal | Precios, porcentajes, coordenadas |
| VARCHAR(n) | Texto variable | Nombres, emails, descripciones cortas |
| CHAR(n) | Texto fijo | Códigos, siglas, campos de largo exacto |
| TEXT | Texto libre | Comentarios, notas, HTML, JSON |
| DATE | Fecha | Fechas de nacimiento, vencimientos |
| TIMESTAMP | Fecha y hora | Registros de auditoría, logs, creación |
| BOOLEAN | Lógico | Banderas: activo, visible, pagado |
NULL: el valor desconocido
NULL es uno de los conceptos más malentendidos por los principiantes. NULL no es cero, no es una cadena vacía, no es false. NULL significa que el valor es desconocido o que no aplica para ese registro.
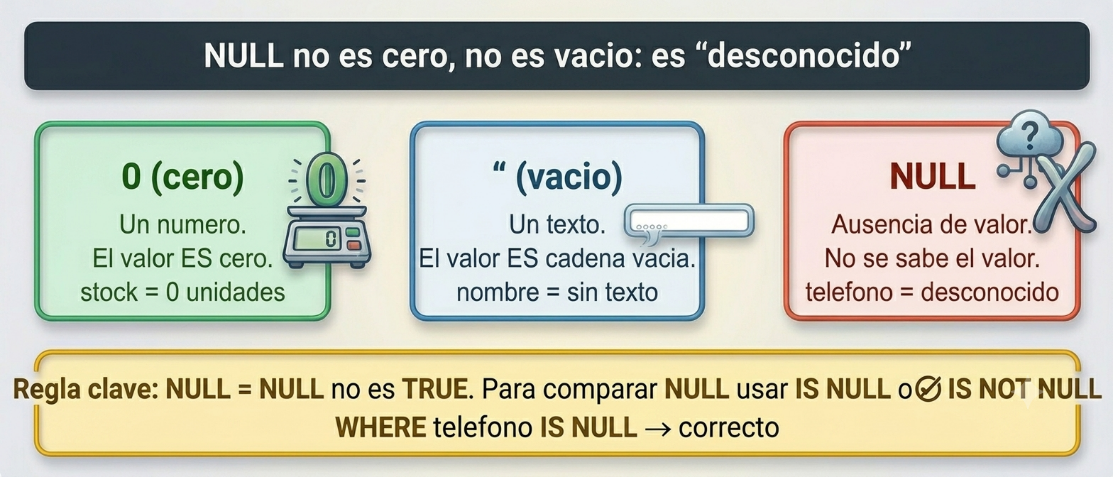
NULL, cero y cadena vacía son tres cosas completamente distintas
La consecuencia más importante de NULL es que no se puede comparar con = (igual). Silberschatz lo explica en el Cap. 3.6: SQL usa una lógica de tres valores (TRUE, FALSE y UNKNOWN). Cualquier comparación con NULL devuelve UNKNOWN, no TRUE ni FALSE.
-- INCORRECTO: esto nunca devuelve filas, aunque haya NULLs
SELECT * FROM clientes WHERE telefono = NULL;
-- CORRECTO: para comparar NULL usar IS NULL o IS NOT NULL
SELECT * FROM clientes WHERE telefono IS NULL;
SELECT * FROM clientes WHERE telefono IS NOT NULL;
-- NULL en operaciones aritméticas siempre da NULL:
SELECT precio * NULL; -- resultado: NULL
SELECT 100 + NULL; -- resultado: NULLOlvidarse de manejar NULL es una fuente común de bugs. Si una columna puede tener valores ausentes, siempre usar IS NULL en lugar de = NULL. Agregar NOT NULL cuando el campo siempre debe tener valor.
Capítulo 2 - DDL: definir la estructura
DDL significa Data Definition Language (Lenguaje de Definición de Datos). Son las instrucciones que definen la estructura de la base de datos: crear tablas, modificarlas y eliminarlas. A diferencia del DML (que trabaja con los datos), el DDL trabaja con la estructura que contiene esos datos.
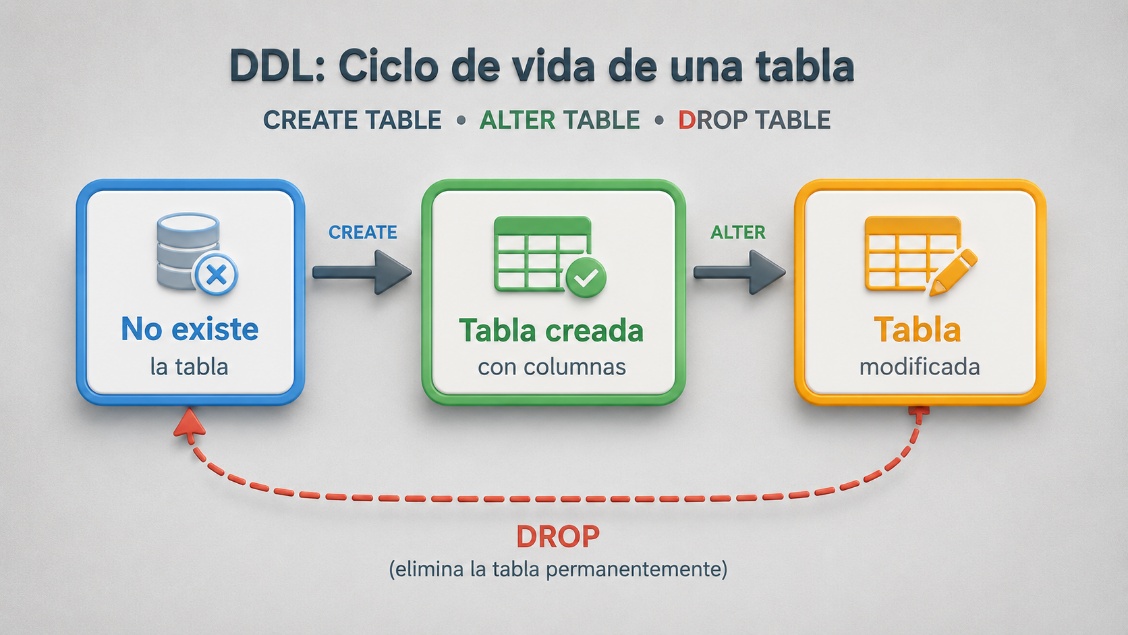
El ciclo de vida de una tabla: CREATE, ALTER y DROP
CREATE TABLE
CREATE TABLE crea una nueva tabla en la base de datos. Se definen las columnas con su nombre, tipo de dato y restricciones (constraints). Un ejemplo completo con todos los elementos:
CREATE TABLE productos (
id_producto INT NOT NULL,
nombre VARCHAR(150) NOT NULL,
descripcion TEXT, -- puede ser NULL
precio DECIMAL(10,2) NOT NULL CHECK (precio >= 0),
stock INT NOT NULL DEFAULT 0,
categoria VARCHAR(50) CHECK (categoria IN ('electronica','ropa','hogar')),
fecha_alta DATE DEFAULT CURRENT_DATE,
activo BOOLEAN DEFAULT TRUE,
PRIMARY KEY (id_producto)
);| Elemento | Que hace |
|---|---|
| NOT NULL | Obliga a que el campo siempre tenga valor. No acepta NULL. |
| DEFAULT valor | Si no se especifica el valor al insertar, usa este valor por defecto. |
| CHECK (condición) | Valida que el valor cumpla una condición antes de guardar. |
| PRIMARY KEY | Marca la columna como clave primaria: unica y no nula. |
| UNIQUE | El valor debe ser unico en toda la tabla, pero puede ser NULL. |
ALTER TABLE
ALTER TABLE permite modificar la estructura de una tabla que ya existe y tiene datos. Es la instrucción que más cuidado requiere porque puede afectar datos existentes.
-- Agregar una columna nueva
ALTER TABLE productos ADD COLUMN peso_kg DECIMAL(6,2);
-- Agregar una columna con valor por defecto (no rompe los registros existentes)
ALTER TABLE productos ADD COLUMN descuento DECIMAL(4,2) DEFAULT 0.00;
-- Renombrar una columna
ALTER TABLE productos RENAME COLUMN nombre TO nombre_producto;
-- Cambiar el tipo de dato de una columna (con cuidado: puede perder datos)
ALTER TABLE productos ALTER COLUMN descripcion TYPE VARCHAR(500);
-- Agregar una restricción a una columna existente
ALTER TABLE productos ADD CONSTRAINT chk_stock CHECK (stock >=0);
-- Eliminar una columna
ALTER TABLE productos DROP COLUMN peso_kg;ALTER TABLE puede ser una operación costosa en tablas con millones de filas. Agregar una columna NOT NULL sin DEFAULT a una tabla con datos existentes fallara, porque los registros ya cargados no tendrían valor para esa columna.
DROP TABLE
DROP TABLE elimina una tabla completa: su estructura y todos sus datos de forma permanente. No hay una papelera de reciclaje en SQL. Una vez ejecutado, no hay vuelta atrás salvo un backup.
-- Elimina la tabla y todos sus datos para siempre
DROP TABLE productos;
-- Variante segura: no da error si la tabla no existe
DROP TABLE IF EXISTS productos;
-- TRUNCATE: vacía todos los datos, pero mantiene la estructura
TRUNCATE TABLE productos;La diferencia entre DROP y TRUNCATE: DROP elimina la tabla entera (estructura + datos). TRUNCATE solo borra todos los registros, pero deja la tabla lista para seguir usando. Ambas son operaciones irreversibles.
Capitulo 3 - DML: trabajar con los datos
DML significa Data Manipulation Language (Lenguaje de Manipulación de Datos). Son las instrucciones que operan sobre los datos: INSERT para agregar, UPDATE para modificar y DELETE para eliminar. SELECT también es DML, aunque ya lo vimos en el Nivel 1.
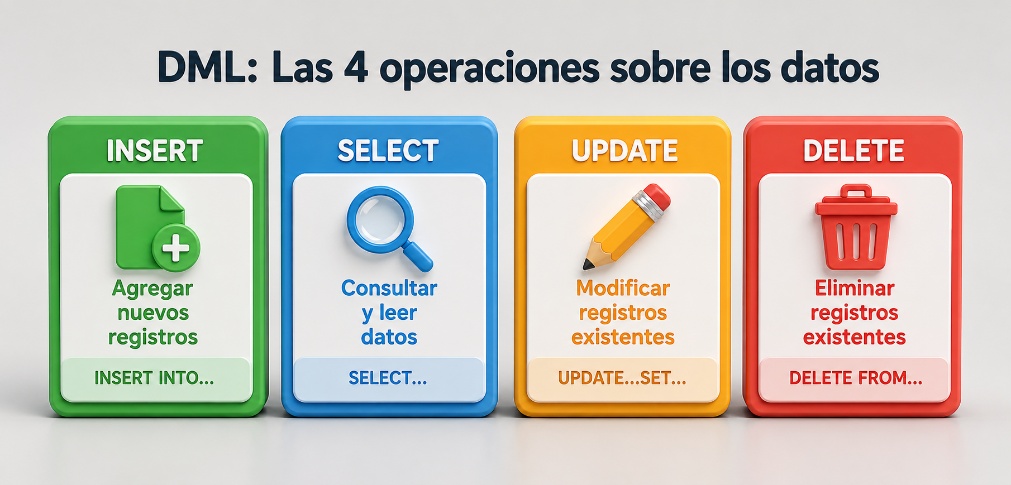
Las 4 operaciones DML: INSERT, SELECT, UPDATE, DELETE
INSERT - agregar registros
INSERT INTO agrega nuevas filas a una tabla. Se puede insertar de a un registro o varios a la vez.
-- Insertar un registro especificando todas las columnas
INSERT INTO productos (id_producto, nombre, precio, stock)
VALUES (1, 'Laptop Lenovo', 899.99, 15);
-- Insertar varios registros en una sola instrucción
INSERT INTO productos (id_producto, nombre, precio, stock) VALUES
(2, 'Mouse Logitech', 29.99, 80),
(3, 'Teclado Mecanico', 79.99, 40),
(4, 'Monitor 24 pulg', 249.99, 20);
-- Si se omite una columna con DEFAULT, usa el valor por defecto
INSERT INTO productos (id_producto, nombre, precio)
VALUES (5, 'Webcam HD', 49.99); -- stock tomara DEFAULT 0No es necesario especificar todas las columnas en el INSERT. Las que tienen DEFAULT o aceptan NULL se pueden omitir. Las que son NOT NULL sin DEFAULT son obligatorias.
UPDATE - modificar registros
UPDATE modifica los valores de registros que ya existen. Siempre se debe usar con WHERE para indicar cuales filas modificar. Sin WHERE, se actualizan TODOS los registros de la tabla.
-- Modificar el precio de un producto especifico
UPDATE productos
SET precio = 849.99
WHERE id_producto = 1;
-- Actualizar múltiples columnas al mismo tiempo
UPDATE productos
SET precio = 799.99, stock = 20
WHERE id_producto = 1;
-- Actualizar usando el valor actual (sumar al stock)
UPDATE productos
SET stock = stock + 50
WHERE id_producto = 2;
-- Actualizar todos los productos de una categoría
UPDATE productos
SET activo = FALSE
WHERE categoria = 'electronica' AND stock = 0;NUNCA ejecutar UPDATE sin WHERE en produccion a menos que realmente se quieran modificar todos los registros. Un error común: olvidar el WHERE y actualizar miles de filas sin querer. Buena practica: probar antes con un SELECT usando la misma condición.
DELETE - eliminar registros
DELETE FROM elimina filas de una tabla. Al igual que UPDATE, sin WHERE elimina todos los registros. La diferencia con TRUNCATE es que DELETE puede tener condición y es parte de una transacción (se puede hacer ROLLBACK).
-- Eliminar un registro especifico
DELETE FROM productos
WHERE id_producto = 5;
-- Eliminar todos los productos sin stock
DELETE FROM productos
WHERE stock = 0;
-- Usando transacción para poder deshacer si algo sale mal
BEGIN;
DELETE FROM productos WHERE categoria = 'electronica';
-- si nos arrepentimos antes de confirmar:
ROLLBACK; -- deshace el DELETE
-- o si estamos seguros:
-- COMMIT; -- confirma el DELETE permanentementeLa técnica de usar BEGIN + DELETE + ROLLBACK/COMMIT es muy útil para practicar sin miedo a borrar datos accidentalmente. Mientras no se haga COMMIT, el DELETE no es definitivo.
Capítulo 4 - ORDER BY, LIMIT y filtros avanzados
ORDER BY - ordenar resultados
ORDER BY ordena los resultados de una consulta. Se puede ordenar por una o varias columnas, de forma ascendente (ASC, el default) o descendente (DESC).
-- Ordenar por precio de menor a mayor (ASC es el default)
SELECT nombre, precio FROM productos
ORDER BY precio ASC;
-- Ordenar por precio de mayor a menor
SELECT nombre, precio FROM productos
ORDER BY precio DESC;
-- Ordenar por categoría primero, luego por nombre dentro de cada categoría
SELECT nombre, categoría, precio FROM productos
ORDER BY categoría ASC, nombre ASC;
-- Ordenar clientes por apellido y mostrar solo los 10 primeros
SELECT nombre FROM clientes
ORDER BY nombre ASC
LIMIT 10;
LIMIT y OFFSET - paginar resultados
LIMIT restringe la cantidad de filas devueltas. OFFSET indica desde que fila empezar. Juntos permiten paginar resultados, algo esencial en aplicaciones web.
-- Traer solo los 5 productos más caros
SELECT nombre, precio FROM productos
ORDER BY precio DESC
LIMIT 5;
-- Paginación: pagina 1 (filas 1-10)
SELECT * FROM productos ORDER BY id_producto LIMIT 10 OFFSET 0;
-- Paginación: pagina 2 (filas 11-20)
SELECT * FROM productos ORDER BY id_producto LIMIT 10 OFFSET 10;
-- Paginación: pagina 3 (filas 21-30)
SELECT * FROM productos ORDER BY id_producto LIMIT 10 OFFSET
20;La fórmula para calcular el OFFSET es: OFFSET = (numero_pagina - 1) * filas_por_pagina. Página 3 con 10 filas por página: OFFSET = (3-1) * 10 = 20.
Filtros avanzados en WHERE
El WHERE no solo acepta comparaciones simples (=, >, <). SQL tiene operadores especiales para casos comunes: búsqueda de patrones en texto, listas de valores, rangos y valores nulos.
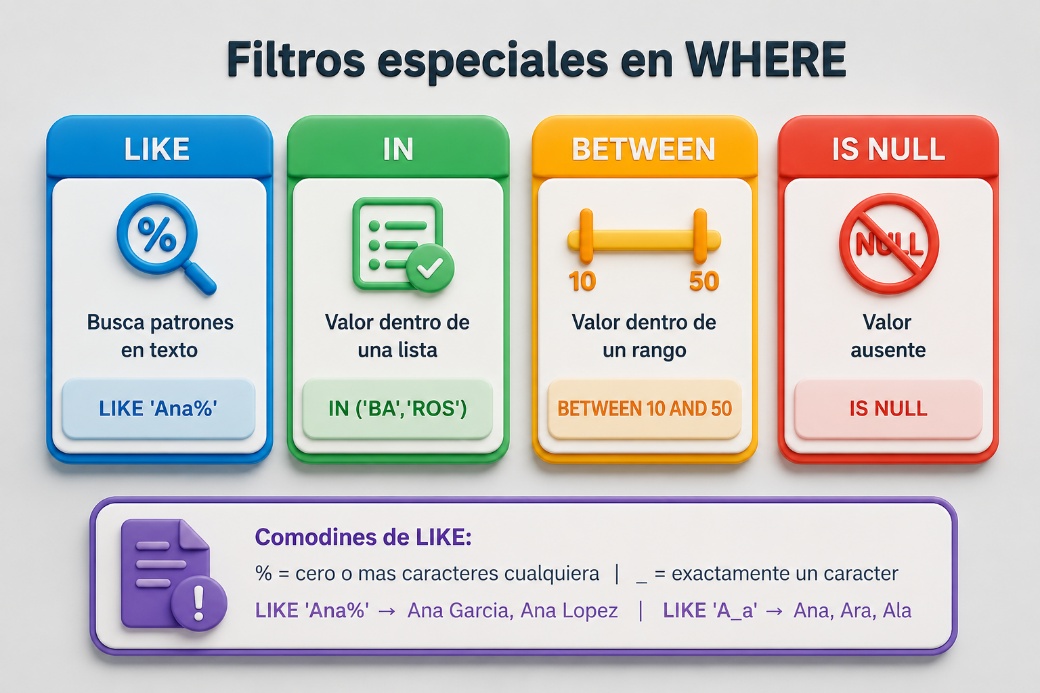
Los cuatro filtros especiales más usados en SQL
LIKE - búsqueda de patrones en texto
LIKE permite buscar filas que cumplan un patrón de texto. Usa dos caracteres especiales: % para representar cualquier cantidad de caracteres, y _ para representar exactamente un carácter.
-- Clientes cuyo nombre empieza con 'Ana'
SELECT * FROM clientes WHERE nombre LIKE 'Ana%';
-- Resultado: Ana Garcia, Ana Lopez, Anabela Ruiz
-- Clientes cuyo nombre termina en 'ez'
SELECT * FROM clientes WHERE nombre LIKE '%ez';
-- Resultado: Lopez, Perez, Gomez, Benitez
-- Productos que contienen 'laptop' en cualquier parte del nombre
SELECT * FROM productos WHERE nombre LIKE '%laptop%';
-- Códigos de 3 letras que empiezan con A y terminan con G
SELECT * FROM paises WHERE codigo LIKE 'A_G';
-- Resultado: ARG (Argentina)LIKE no distingue mayúsculas de minúsculas en algunos motores (MySQL). En otros (PostgreSQL) si importan. Para búsqueda insensible a mayúsculas en PostgreSQL usar ILIKE en lugar de LIKE.
IN - lista de valores aceptados
IN verifica si el valor de una columna pertenece a una lista de valores posibles. Es mucho más legible que encadenar múltiples OR.
-- Sin IN (engorroso):
SELECT * FROM clientes
WHERE ciudad = 'Buenos Aires' OR ciudad = 'Rosario' OR ciudad ='Cordoba';
-- Con IN (limpio y claro):
SELECT * FROM clientes
WHERE ciudad IN ('Buenos Aires', 'Rosario', 'Cordoba');
-- NOT IN: excluir una lista de valores
SELECT * FROM productos
WHERE categoria NOT IN ('electronica', 'tecnologia');
BETWEEN - rango de valores
BETWEEN filtra valores dentro de un rango inclusivo. Funciona con números, fechas y textos.
-- Productos con precio entre $50 y $200
SELECT nombre, precio FROM productos
WHERE precio BETWEEN 50 AND 200;
-- Equivalente a: WHERE precio >= 50 AND precio <= 200
-- Pedidos del primer trimestre de 2025
SELECT * FROM pedidos
WHERE fecha BETWEEN '2025-01-01' AND '2025-03-31';
-- NOT BETWEEN: fuera del rango
SELECT * FROM productos WHERE precio NOT BETWEEN 100 AND 500;
IS NULL / IS NOT NULL
Como vimos en el Capítulo 1, NULL no se puede comparar con =. Los operadores correctos son IS NULL para buscar valores ausentes e IS NOT NULL para buscar los que tienen valor.
-- Clientes que no tienen teléfono cargado
SELECT nombre FROM clientes WHERE telefono IS NULL;
-- Productos que SI tienen descripción
SELECT nombre FROM productos WHERE descripcion IS NOT NULL;
-- Combinar con otros filtros
SELECT nombre, email FROM clientes
WHERE ciudad = 'Buenos Aires' AND telefono IS NOT NULL
ORDER BY nombre;
Capítulo 5 - Funciones de agregación, GROUP BY y HAVING
Hasta ahora las consultas devolvían filas individuales. Las funciones de agregación permiten calcular resúmenes sobre conjuntos de filas: cuantos hay, cual es el total, el promedio, el máximo. Según Silberschatz (Cap. 3.7), son una de las herramientas más poderosas de SQL.
Las funciones de agregación
-- COUNT: cuantas filas hay (o cuantos valores no NULL)
SELECT COUNT(*) FROM pedidos; -- total de pedidos
SELECT COUNT(id_cliente) FROM clientes; -- clientes con ID
cargado
SELECT COUNT(DISTINCT ciudad) FROM clientes; -- ciudades únicas
-- SUM: suma de valores numéricos
SELECT SUM(total) FROM pedidos; -- suma total de ventas
SELECT SUM(stock) FROM productos; -- stock total
-- AVG: promedio
SELECT AVG(precio) FROM productos; -- precio promedio
SELECT AVG(total) FROM pedidos WHERE YEAR(fecha) = 2025;
-- MAX y MIN: valor máximo y mínimo
SELECT MAX(precio) FROM productos; -- producto más caro
SELECT MIN(fecha) FROM pedidos; -- pedido más antiguo| Función | Que calcula | Ignora NULL |
|---|---|---|
| COUNT(*) | Cantidad total de filas | No (cuenta todo) |
| COUNT(columna) | Cantidad de valores no nulos en esa columna | Si |
| SUM(columna) | Suma de todos los valores | Si |
| AVG(columna) | Promedio de los valores | Si |
| MAX(columna) | Valor máximo (mayor numero, fecha más reciente) | Si |
| MIN(columna) | Valor mínimo (menor número, fecha más antigua) | Si |
GROUP BY - agrupar para resumir
GROUP BY agrupa las filas que tienen el mismo valor en una columna y aplica la función de agregación a cada grupo por separado. Es el mecanismo que convierte una tabla de miles de filas en un resumen compacto.
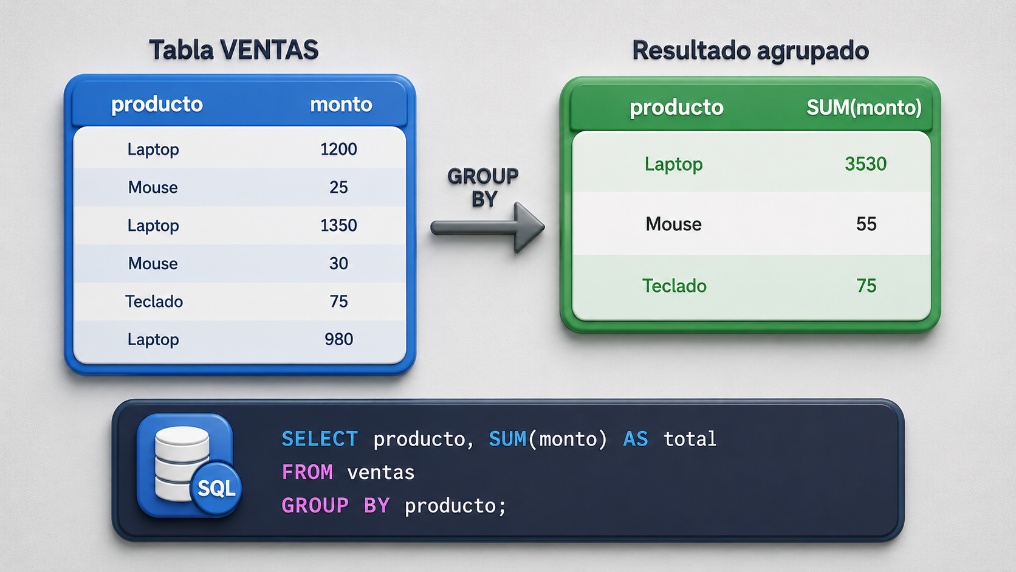
GROUP BY agrupa filas del mismo valor y aplica SUM a cada grupo
-- Total de ventas por producto
SELECT producto, SUM(monto) AS total_vendido
FROM ventas
GROUP BY producto
ORDER BY total_vendido DESC;
-- Cantidad de clientes por ciudad
SELECT ciudad, COUNT(*) AS cantidad
FROM clientes
GROUP BY ciudad
ORDER BY cantidad DESC;
-- Ticket promedio y total de pedidos por mes
SELECT MONTH(fecha) AS mes,
COUNT(*) AS cantidad_pedidos,
AVG(total) AS ticket_promedio,
SUM(total) AS total_mes
FROM pedidos
WHERE YEAR(fecha) = 2025
GROUP BY MONTH(fecha)
ORDER BY mes;Regla de oro de GROUP BY: toda columna en el SELECT que NO sea una función de agregación DEBE aparecer en el GROUP BY. Si pones nombre y categoría en el SELECT, ambas deben estar en GROUP BY.
HAVING - filtrar grupos
WHERE filtra filas individuales antes de agrupar. HAVING filtra grupos después de aplicar GROUP BY. Esta diferencia es fundamental: no se puede usar una función de agregación en WHERE, pero si en HAVING.
-- Filtrar grupos con más de 100 clientes
SELECT ciudad, COUNT(*) AS cantidad
FROM clientes
GROUP BY ciudad
HAVING COUNT(*) > 100
ORDER BY cantidad DESC;
-- Productos con ventas totales mayores a $10000
SELECT producto, SUM(monto) AS total
FROM ventas
GROUP BY producto
HAVING SUM(monto) > 10000
ORDER BY total DESC;
-- Combinar WHERE (filtra filas) y HAVING (filtra grupos)
SELECT categoría, AVG(precio) AS precio_promedio
FROM productos
WHERE activo = TRUE -- primero filtra solo activos
GROUP BY categoría
HAVING AVG(precio) > 50 -- luego filtra categorías caras
ORDER BY precio_promedio DESC;Orden de ejecución de una consulta SQL: FROM → WHERE → GROUP BY → HAVING → SELECT → ORDER BY → LIMIT. Saber esto explica por qué WHERE no puede usar alias definidos en SELECT, pero ORDER BY si puede.
Capítulo 6 - Vistas (VIEW)
Una vista es una consulta SQL guardada con un nombre, que se puede usar como si fuera una tabla. Los datos no se duplican: cada vez que se consulta la vista, la base de datos ejecuta la query original en ese momento. Silberschatz las define en el Cap. 4.2 como tablas virtuales.
| Una VIEW es una tabla virtual definida por una consulta SQL. No almacena datos propios: siempre muestra los datos actuales de las tablas subyacentes. |
|---|
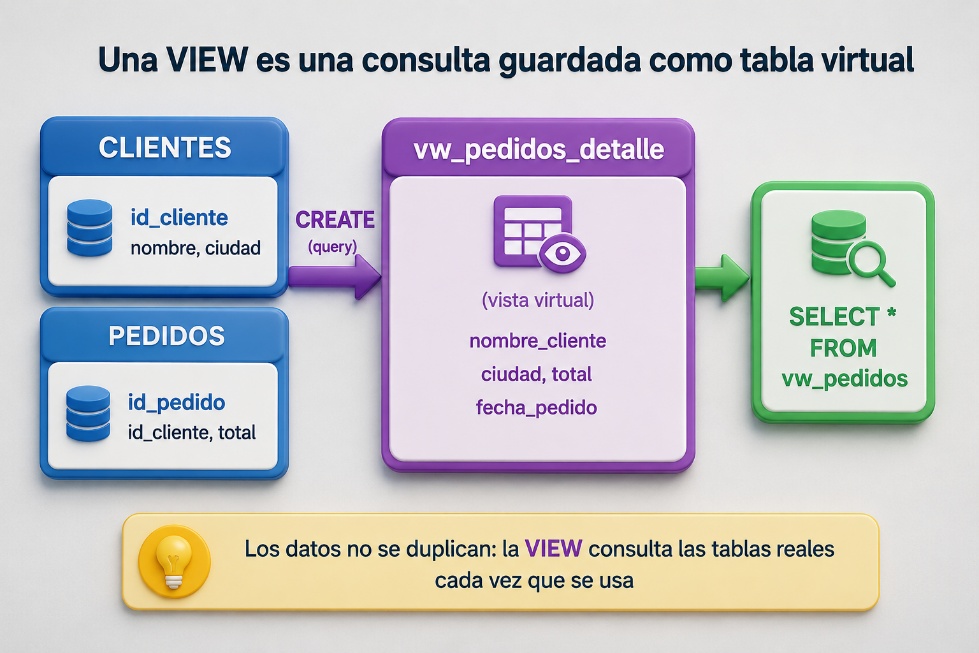
La VIEW combina tablas reales y se consulta como si fuera una tabla mas
Crear y usar vistas
-- Crear una vista que muestra pedidos con nombre de cliente
CREATE VIEW vw_pedidos_detalle AS
SELECT
p.id_pedido,
c.nombre AS nombre_cliente,
c.ciudad,
p.total,
p.fecha
FROM pedidos p
JOIN clientes c ON p.id_cliente = c.id_cliente;
-- Usar la vista exactamente igual que una tabla
SELECT * FROM vw_pedidos_detalle
WHERE ciudad = 'Buenos Aires'
ORDER BY fecha DESC;
-- Las vistas aceptan WHERE, ORDER BY, y hasta otras agregaciones encima
SELECT ciudad, COUNT(*) AS pedidos, SUM(total) AS total_ciudad
FROM vw_pedidos_detalle
GROUP BY ciudad;
Por qué usar vistas
Las vistas tienen varios usos prácticos que las hacen muy valiosas en el día a día:
-
Simplificar consultas complejas: una query con varios JOINs y filtros se guarda una vez como vista y se reutiliza con un SELECT simple.
-
Seguridad: se puede dar acceso a una vista sin exponer las tablas originales. Por ejemplo, una vista que muestra nombre y ciudad, pero oculta email y teléfono.
-
Consistencia: si la lógica de negocio cambia, se modifica la vista en un solo lugar y todas las consultas que la usan quedan actualizadas automáticamente.
-
Documentación viva: una vista bien nombrada como vw_ventas_mensuales comunica claramente que información contiene.
Modificar y eliminar vistas
-- Modificar una vista existente
CREATE OR REPLACE VIEW vw_pedidos_detalle AS
SELECT
p.id_pedido,
c.nombre AS nombre_cliente,
c.ciudad,
p.total,
p.fecha,
p.estado -- agregamos una columna nueva
FROM pedidos p
JOIN clientes c ON p.id_cliente = c.id_cliente;
-- Eliminar una vista (no afecta las tablas originales)
DROP VIEW vw_pedidos_detalle;
DROP VIEW IF EXISTS vw_pedidos_detalle; -- sin error si no existeUna vista no guarda datos: si borramos la vista, los datos de las tablas originales no se ven afectados. Pero si borramos o modificamos las tablas subyacentes, la vista puede quedar invalida.
Resumen completo del Nivel 2
Entre la Parte 1 y esta Parte 2, el Nivel 2 cubre todos los conceptos intermedios necesarios para trabajar de forma profesional con bases de datos relacionales:
| Tema | Conceptos clave | Capitulo |
|---|---|---|
| ACID | Atomicidad, Consistencia, Aislamiento, Durabilidad | Nivel 2 Parte 1 |
| Transacciones | BEGIN, COMMIT, ROLLBACK | Nivel 2 Parte 1 |
| Integridad | Entidad, Referencial, Dominio | Nivel 2 Parte 1 |
| Indices | B-Tree, CREATE INDEX, EXPLAIN | Nivel 2 Parte 1 |
| Tipos de datos | INT, VARCHAR, DATE, BOOLEAN, etc. | Cap 1 |
| NULL | IS NULL, IS NOT NULL, logica de tres valores | Cap 1 |
| DDL | CREATE TABLE, ALTER TABLE, DROP TABLE | Cap 2 |
| Constraints | NOT NULL, DEFAULT, CHECK, PRIMARY KEY | Cap 2 |
| INSERT | Agregar uno o varios registros | Cap 3 |
| UPDATE | Modificar registros con condición | Cap 3 |
| DELETE | Eliminar registros con condición | Cap 3 |
| ORDER BY / LIMIT | Ordenar y paginar resultados | Cap 4 |
| LIKE / IN / BETWEEN | Filtros avanzados en WHERE | Cap 4 |
| COUNT / SUM / AVG | Funciones de agregación | Cap 5 |
| GROUP BY / HAVING | Agrupar y filtrar grupos | Cap 5 |
| VIEW | Tabla virtual basada en una consulta | Cap 6 |
Con todo esto dominado, el Nivel 3 introduce los JOINs para cruzar tablas, las subqueries, la normalización de esquemas y el modelo Entidad-Relacion para diseñar bases de datos desde cero.
Fin del Nivel 2 completo - Siguiente: Nivel 3 - JOINs, Normalización y Diseño
Nivel 3 - Consultas Avanzadas y Motor Interno
JOINs - Subqueries - Stored Procedures - Triggers - Optimización - Concurrencia
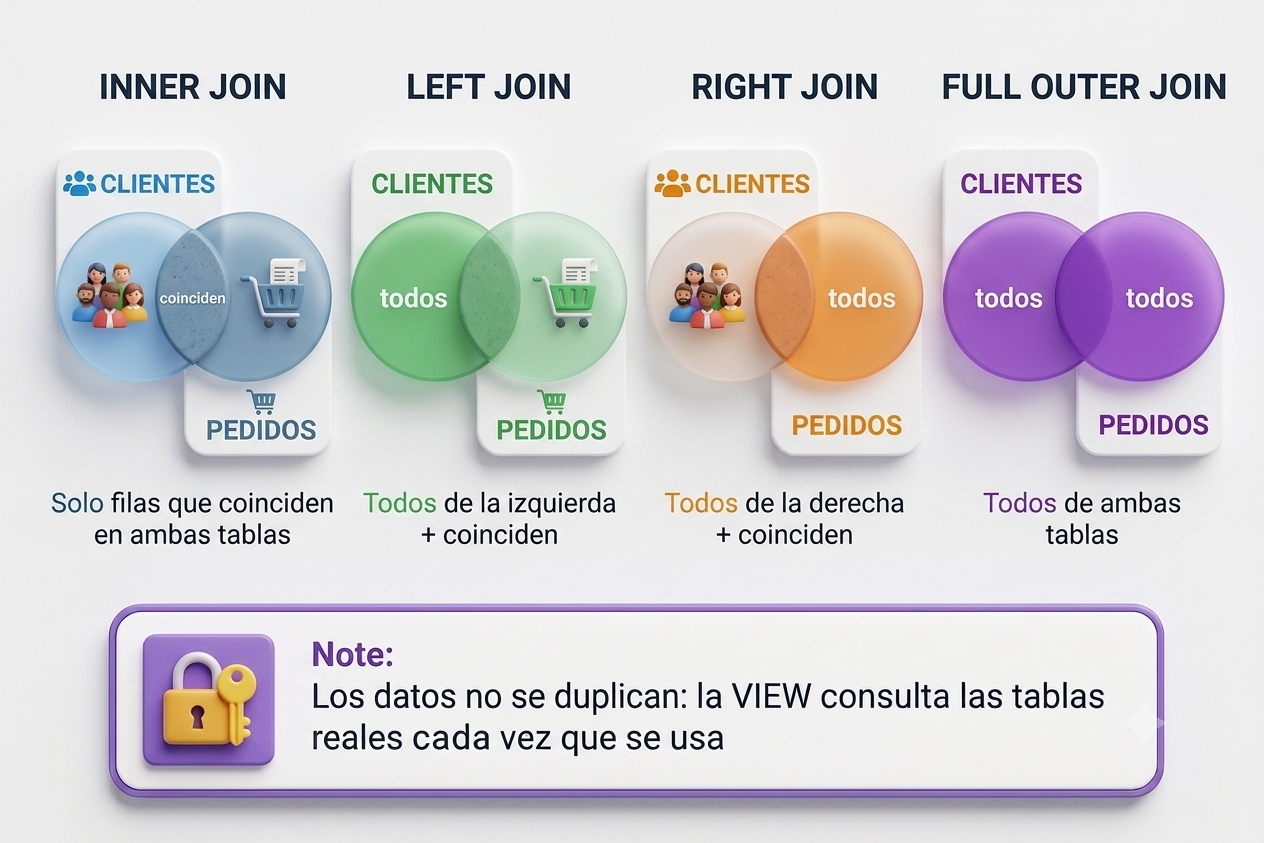
Los cuatro tipos de JOIN: el corazón de las consultas entre múltiples tablas
“Basado en Fundamentos de Bases de Datos, Silberschatz - Korth - Sudarshan (4a Ed.)”
Introducción
Los niveles 1 y 2 te dieron los cimientos: entendiste que es una base de datos, como se organiza la información en tablas, las propiedades ACID, la integridad, los tipos de datos, DDL, DML, agregaciones y vistas. En este nivel 3 das el salto a las herramientas que usan los profesionales en el día a día.
Las tablas de ejemplo que ya conoces (clientes, productos, pedidos, pagos) aparecen en todos los ejemplos para que el contenido sea familiar y fácil de seguir.
-
Capitulo 1: JOINs - cruzar información entre tablas
-
Capitulo 2: Subqueries - consultas dentro de consultas
-
Capitulo 3: Stored Procedures y Funciones - lógica guardada en el servidor
-
Capitulo 4: Triggers - automatizaciones que se disparan solas
-
Capitulo 5: Optimización de consultas y EXPLAIN
-
Capitulo 6: Control de concurrencia - que pasa cuando varios usuarios actúan al mismo tiempo
El contenido teórico de este manual está basado en Fundamentos de Bases de Datos (4a Ed.) de Silberschatz, Korth y Sudarshan, especialmente los Capítulos 4, 13, 14, 15 y 16. Los ejemplos prácticos usan las tablas clientes, productos, pedidos y pagos ya conocidas.
Capítulo 1 - JOINs: cruzar información entre tablas
En el mundo real la información no vive en una sola tabla. Un pedido necesita datos del cliente, el cliente tiene datos en su propia tabla, y el detalle del pedido tiene productos de otra tabla. El JOIN es la instrucción que une esas tablas en una sola consulta.
Un JOIN es una operación que combina filas de dos o más tablas basándose en una condición de relación entre ellas, generalmente una clave foránea que apunta a una clave primaria.
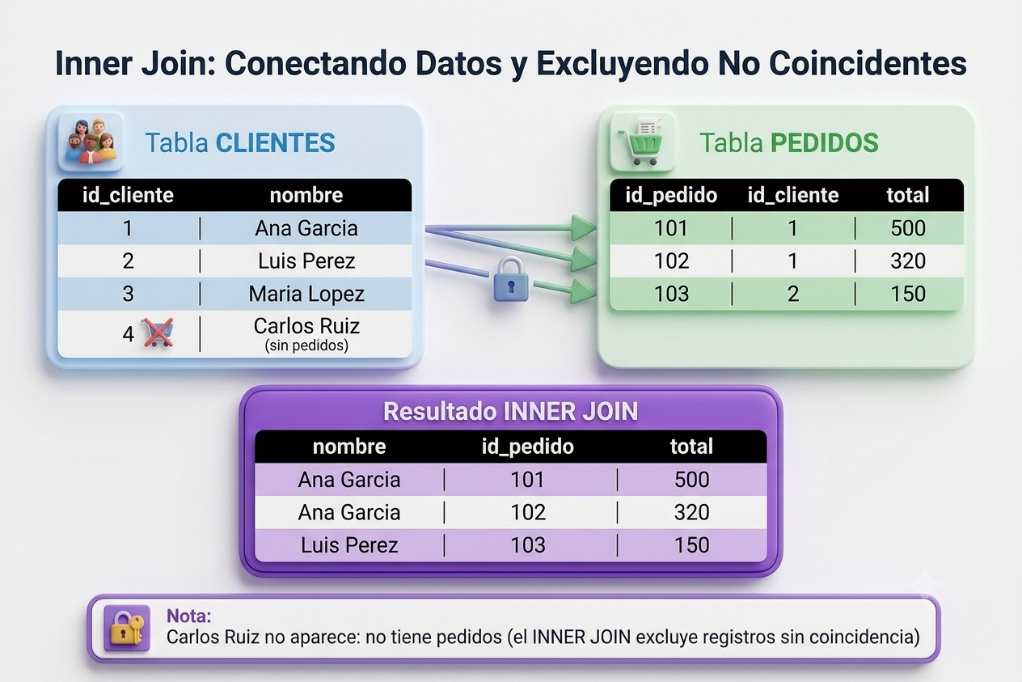
INNER JOIN entre CLIENTES y PEDIDOS: solo aparecen los clientes que tienen pedidos
Los 4 tipos de JOIN
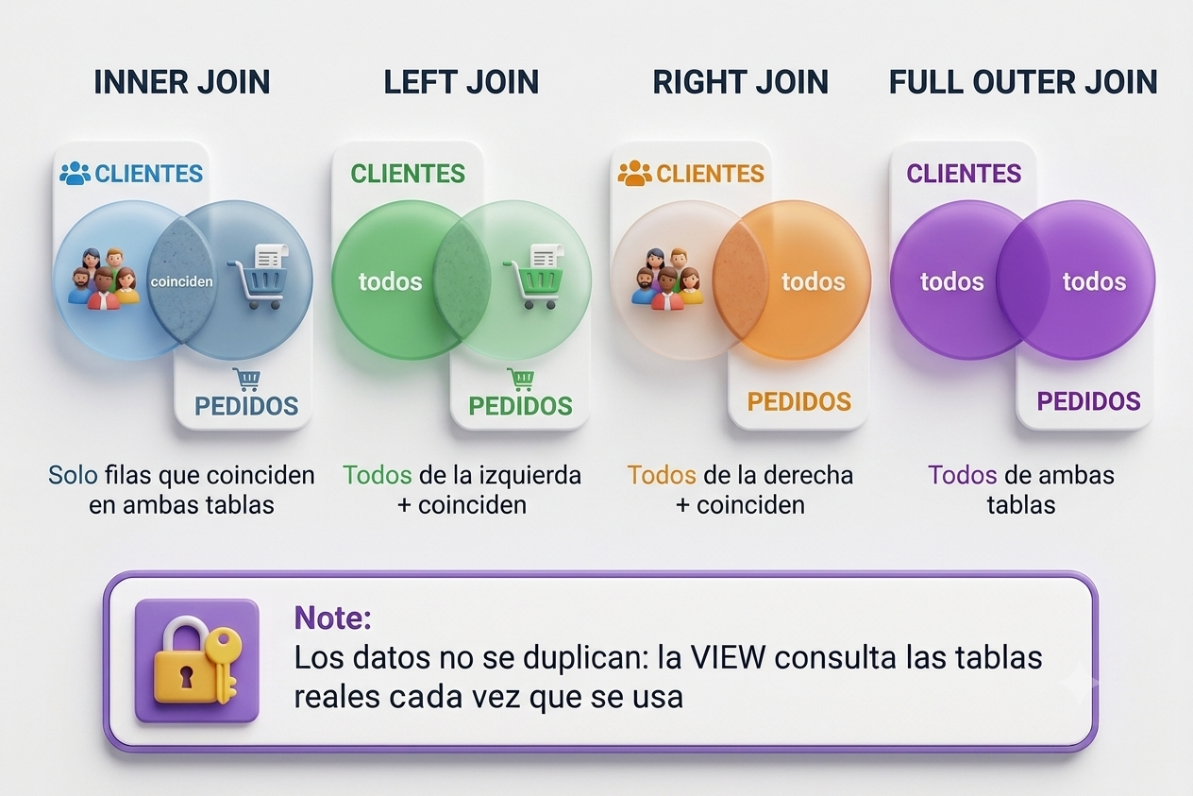
Diagrama de Venn: cada tipo de JOIN determina que filas incluir cuando no hay coincidencia
INNER JOIN - solo lo que coincide
El INNER JOIN devuelve únicamente las filas que tienen coincidencia en ambas tablas. Si un cliente no tiene pedidos, no aparece. Si un pedido tuviera un id_cliente inexistente, tampoco aparecería.
-- Pedidos con nombre de cliente
SELECT c.nombre, c.ciudad, p.id_pedido, p.total, p.fecha
FROM clientes c
INNER JOIN pedidos p ON c.id_cliente = p.id_cliente
ORDER BY p.fecha DESC;
-- JOIN con 3 tablas: pedido + cliente + detalle
SELECT c.nombre, p.id_pedido, pr.nombre AS producto, d.cantidad,
d.precio_unitario
FROM pedidos p
INNER JOIN clientes c ON p.id_cliente = c.id_cliente
INNER JOIN detalle_pedido d ON p.id_pedido = d.id_pedido
INNER JOIN productos pr ON d.id_producto = pr.id_producto
WHERE p.fecha >= '2025-01-01';Por convención se usan alias de una letra (c para clientes, p para pedidos). Cuando hay muchas tablas, aliases descriptivos como cli, ped, prod son más claros.
LEFT JOIN - todos los de la izquierda
El LEFT JOIN devuelve todas las filas de la tabla izquierda (la del FROM) aunque no tengan coincidencia en la tabla derecha. Donde no hay coincidencia, las columnas de la tabla derecha aparecen como NULL. Es ideal para encontrar registros ‘huérfanos’.
-- Todos los clientes, tengan o no pedidos
SELECT c.nombre, c.ciudad,
p.id_pedido, -- NULL si el cliente no tiene pedidos
p.total -- NULL si el cliente no tiene pedidos
FROM clientes c
LEFT JOIN pedidos p ON c.id_cliente = p.id_cliente
ORDER BY c.nombre;
-- Truco útil: encontrar clientes SIN pedidos
SELECT c.nombre, c.ciudad
FROM clientes c
LEFT JOIN pedidos p ON c.id_cliente = p.id_cliente
WHERE p.id_pedido IS NULL; -- solo los que NO tienen coincidenciaEl patrón LEFT JOIN … WHERE tabla_derecha IS NULL es una forma muy eficiente de encontrar registros sin relación. Alternativa: usar NOT EXISTS con subquery (ver Capitulo 2).
RIGHT JOIN - todos los de la derecha
El RIGHT JOIN es el espejo del LEFT JOIN: devuelve todas las filas de la tabla derecha, aunque no tengan coincidencia en la izquierda. En la práctica se usa poco porque siempre se puede reescribir como un LEFT JOIN cambiando el orden de las tablas.
-- RIGHT JOIN: todos los pedidos, aunque el cliente no exista
SELECT c.nombre, p.id_pedido, p.total
FROM clientes c
RIGHT JOIN pedidos p ON c.id_cliente = p.id_cliente;
-- Equivalente con LEFT JOIN (más común):
SELECT c.nombre, p.id_pedido, p.total
FROM pedidos p
LEFT JOIN clientes c ON p.id_cliente = c.id_cliente;
FULL OUTER JOIN - todos de ambas tablas
El FULL OUTER JOIN devuelve todas las filas de ambas tablas. Donde no hay coincidencia en un lado, esas columnas son NULL. Es útil para detectar inconsistencias o hacer comparaciones completas entre dos conjuntos de datos.
-- Todos los clientes y todos los pedidos coincidan o no
SELECT c.nombre, p.id_pedido, p.total
FROM clientes c
FULL OUTER JOIN pedidos p ON c.id_cliente = p.id_cliente
ORDER BY c.nombre;
-- Resultado incluye:
-- Filas con coincidencia en ambos lados
-- Clientes sin pedidos (p.id_pedido = NULL)
-- Pedidos sin cliente valido (c.nombre = NULL)MySQL no soporta FULL OUTER JOIN directamente. Se puede simular combinando LEFT JOIN y RIGHT JOIN con UNION ALL, filtrando los nulos de cada lado.
SELF JOIN - una tabla unida consigo misma
A veces una tabla tiene una relación consigo misma. El caso clásico es una tabla de empleados donde cada empleado tiene un jefe que también es empleado. El SELF JOIN usa la misma tabla dos veces con aliases distintos.
-- Empleados con el nombre de su jefe
SELECT e.nombre AS empleado,
j.nombre AS jefe
FROM empleados e
LEFT JOIN empleados j ON e.id_jefe = j.id_empleado
ORDER BY j.nombre, e.nombre;
Resumen de tipos de JOIN
| Tipo | Que devuelve | Uso tipico |
| INNER JOIN | Solo filas con coincidencia en ambas tablas | La mayoría de los reportes de negocio |
| LEFT JOIN | Todas las filas de la izq. + coincidencias de la der. | Detectar registros sin relación |
| RIGHT JOIN | Todas las filas de la der. + coincidencias de la izq. | Poco usado, preferir LEFT JOIN |
| FULL OUTER JOIN | Todas las filas de ambas tablas | Comparaciones, auditorias de datos |
| SELF JOIN | Filas de la misma tabla relacionadas entre si | Jerarquías, categorías anidadas |
Capítulo 2 - Subqueries: consultas dentro de consultas
Una subquery (o subconsulta) es una consulta SQL que se escribe dentro de otra consulta. La subconsulta se ejecuta primero y su resultado es usado por la consulta externa. Es una de las herramientas más versátiles de SQL, basada en el algebra relacional que describe Silberschatz en el Cap. 4.6.
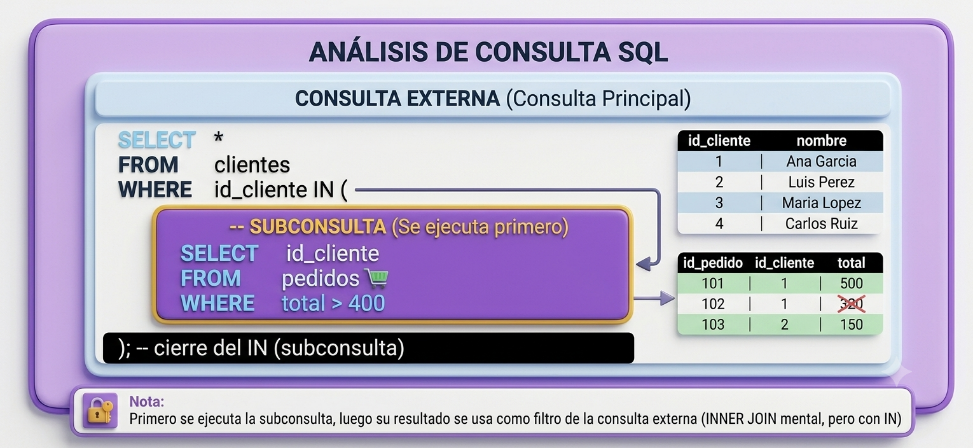
La subconsulta (en naranja) se ejecuta primero y su resultado alimenta la consulta externa
Subquery en WHERE con IN
La forma más común es usar una subconsulta como filtro dentro de un WHERE. La subconsulta devuelve una lista de valores y la consulta externa filtra usando IN.
-- Clientes que hicieron al menos un pedido mayor a $400
SELECT nombre, ciudad
FROM clientes
WHERE id_cliente IN (
SELECT id_cliente
FROM pedidos
WHERE total > 400
);
-- Productos que nunca fueron pedidos
SELECT nombre, precio
FROM productos
WHERE id_producto NOT IN (
SELECT id_producto
FROM detalle_pedido
);
Subquery con EXISTS
EXISTS verifica si la subconsulta devuelve al menos una fila. Es más eficiente que IN cuando la tabla interna es grande, porque el motor para de buscar en cuanto encuentra la primera coincidencia.
-- Clientes que tienen al menos un pedido (con EXISTS)
SELECT nombre, ciudad
FROM clientes c
WHERE EXISTS (
SELECT 1
FROM pedidos p
WHERE p.id_cliente = c.id_cliente
);
-- Clientes sin ningún pedido (con NOT EXISTS)
SELECT nombre, ciudad
FROM clientes c
WHERE NOT EXISTS (
SELECT 1
FROM pedidos p
WHERE p.id_cliente = c.id_cliente
);Dentro de EXISTS se usa SELECT 1 (o SELECT *) porque no importa que columnas devuelve, solo si devuelve filas. El motor no lee las columnas, solo verifica la existencia.
Subquery en SELECT (subquery escalar)
Una subquery escalar devuelve exactamente un valor (una fila, una columna) y se puede usar directamente como columna en el SELECT.
-- Para cada cliente mostrar cuantos pedidos tiene
SELECT
c.nombre,
c.ciudad,
(SELECT COUNT(*)
FROM pedidos p
WHERE p.id_cliente = c.id_cliente) AS total_pedidos,
(SELECT SUM(total)
FROM pedidos p
WHERE p.id_cliente = c.id_cliente) AS monto_total
FROM clientes c
ORDER BY monto_total DESC;
Subquery en FROM (tabla derivada)
Una subquery en el FROM actúa como una tabla temporal. El resultado de la subconsulta se puede usar como si fuera una tabla real. Siempre se le debe dar un alias.
-- Top 5 clientes por monto total de pedidos
SELECT nombre, ciudad, monto_total
FROM (
SELECT c.nombre, c.ciudad, SUM(p.total) AS monto_total
FROM clientes c
INNER JOIN pedidos p ON c.id_cliente = p.id_cliente
GROUP BY c.nombre, c.ciudad
) AS resumen_clientes -- alias obligatorio para la tabla derivada
ORDER BY monto_total DESC
LIMIT 5;
CTEs: la alternativa moderna a las subqueries
Las CTE (Common Table Expressions) son una forma más legible de escribir subqueries complejas. Se definen con WITH antes de la consulta principal y se pueden reutilizar varias veces en la misma query.
-- Equivalente al ejemplo anterior con CTE
WITH resumen_clientes AS (
SELECT c.nombre, c.ciudad, SUM(p.total) AS monto_total
FROM clientes c
INNER JOIN pedidos p ON c.id_cliente = p.id_cliente
GROUP BY c.nombre, c.ciudad
)
SELECT nombre, ciudad, monto_total
FROM resumen_clientes
ORDER BY monto_total DESC
LIMIT 5;
-- CTEs múltiples: se pueden encadenar con coma
WITH
totales_cliente AS (
SELECT id_cliente, SUM(total) AS monto
FROM pedidos GROUP BY id_cliente
),
clientes_vip AS (
SELECT id_cliente FROM totales_cliente WHERE monto > 5000
)
SELECT c.nombre, c.ciudad
FROM clientes c
INNER JOIN clientes_vip v ON c.id_cliente = v.id_cliente;Las CTEs hacen el código SQL mucho más fácil de leer y mantener. Son especialmente útiles cuando una subquery se necesita más de una vez en la misma consulta.
Capítulo 3 - Stored Procedures y Funciones
Un Stored Procedure (procedimiento almacenado) es un bloque de código SQL con nombre que se guarda dentro del servidor de base de datos. En lugar de enviar toda la query desde la aplicación cada vez, la aplicación simplemente llama al procedimiento por su nombre.
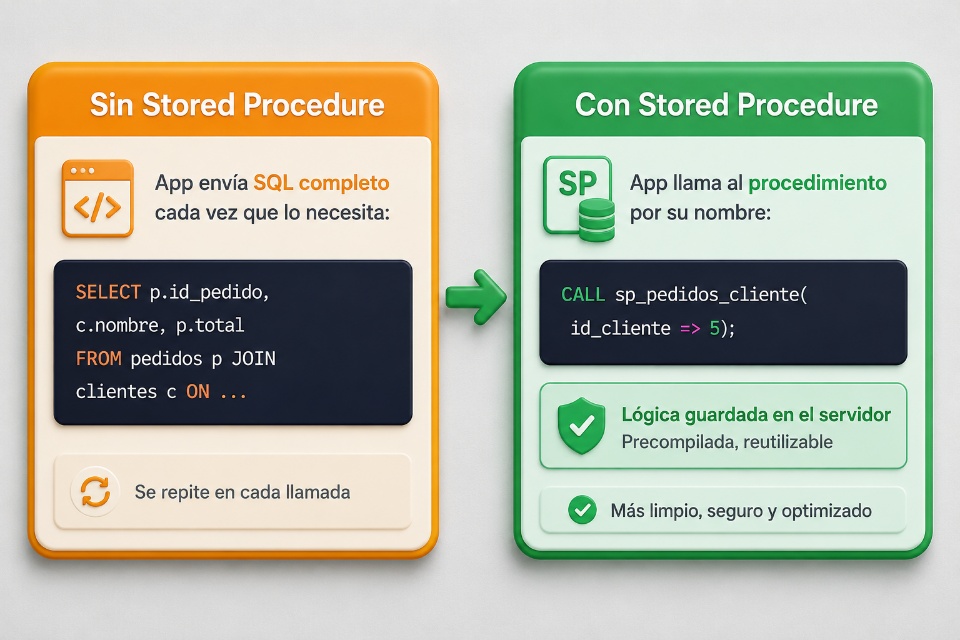
Sin SP: la app envía SQL completo. Con SP: la app llama por nombre al código guardado en el servidor
Un Stored Procedure es un bloque de código SQL precompilado y guardado en la base de datos que puede recibir parámetros, ejecutar lógica compleja y devolver resultados.
Ventajas de los Stored Procedures
-
Rendimiento: el código esta precompilado y el plan de ejecución se cachea. La primera llamada es la más lenta; las siguientes son más rápidas.
-
Seguridad: se puede dar permiso de ejecutar el SP sin dar permiso de acceder a las tablas directamente.
-
Reutilización: la lógica se escribe una vez y se llama desde múltiples aplicaciones o partes del sistema.
-
Mantenimiento: si la lógica cambia, se modifica el SP en un solo lugar sin tocar el código de la aplicación.
-
Reducción del tráfico de red: en lugar de enviar cientos de líneas de SQL, solo se envía el nombre del procedimiento y sus parámetros.
Crear un Stored Procedure
-- Procedimiento: obtener pedidos de un cliente en un rango de fechas
CREATE PROCEDURE sp_pedidos_cliente(
IN p_id_cliente INT,
IN p_fecha_desde DATE,
IN p_fecha_hasta DATE
)
BEGIN
SELECT
p.id_pedido,
p.fecha,
p.total,
p.estado
FROM pedidos p
WHERE p.id_cliente = p_id_cliente
AND p.fecha BETWEEN p_fecha_desde AND p_fecha_hasta
ORDER BY p.fecha DESC;
END;
-- Llamar al procedimiento:
CALL sp_pedidos_cliente(5, '2025-01-01', '2025-06-30');
SP con lógica condicional y loops
Los SPs no se limitan a un SELECT. Pueden incluir variables locales, condicionales IF/ELSE y bucles, lo que los convierte en programas completos dentro de la base de datos.
CREATE PROCEDURE sp_aplicar_descuento(
IN p_id_cliente INT,
OUT p_descuento DECIMAL(5,2)
)
BEGIN
DECLARE v_total_compras DECIMAL(10,2);
-- Calcular total histórico del cliente
SELECT SUM(total) INTO v_total_compras
FROM pedidos
WHERE id_cliente = p_id_cliente;
-- Asignar descuento segun nivel de compras
IF v_total_compras >= 10000 THEN SET p_descuento = 15.00;
ELSEIF v_total_compras >= 5000 THEN SET p_descuento = 10.00;
ELSEIF v_total_compras >= 1000 THEN SET p_descuento = 5.00;
ELSE SET p_descuento = 0.00;
END IF;
END;
-- Llamar y ver el resultado del parámetro OUT:
CALL sp_aplicar_descuento(5, @descuento);
SELECT @descuento AS descuento_asignado;
Funciones vs Stored Procedures
Las funciones son similares a los SPs pero siempre devuelven un valor escalar y se pueden usar directamente dentro de un SELECT, WHERE o cualquier expresión SQL.
-- Función: calcular el total con impuestos
CREATE FUNCTION fn_precio_con_iva(precio DECIMAL(10,2))
RETURNS DECIMAL(10,2)
DETERMINISTIC
BEGIN
RETURN precio * 1.21; -- 21% de IVA
END;
-- Usar la función directamente en un SELECT:
SELECT
nombre,
precio AS precio_sin_iva,
fn_precio_con_iva(precio) AS precio_con_iva
FROM productos
WHERE activo = TRUE;| Característica | Stored Procedure | Función |
| Devuelve | Puede devolver 0 o N resultados | Siempre devuelve 1 valor escalar |
| Uso en SELECT | No se puede usar en SELECT | Si, como si fuera una columna |
| Transacciones | Puede controlar transacciones | No puede |
| Se llama con | CALL nombre() | SELECT nombre() o en expresión |
| Ideal para | Lógica de negocio compleja | Cálculos reutilizables |
Capitulo 4 - Triggers: automatizaciones que se disparan solas
Un trigger (disparador) es un bloque de código SQL que se ejecuta automáticamente cuando ocurre un evento especifico en una tabla: un INSERT, UPDATE o DELETE. No hace falta llamarlo: el motor lo invoca solo.
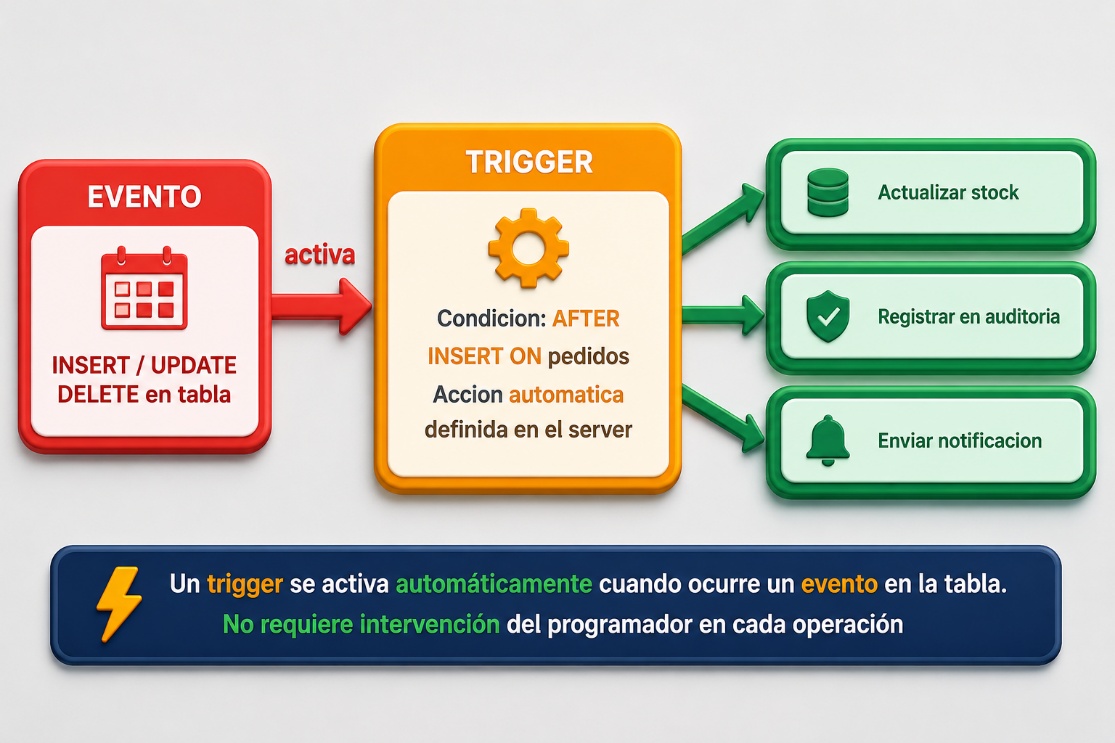
Un trigger reacciona automáticamente a eventos en la tabla sin intervención del programador
Un trigger es un objeto de la base de datos que se ejecuta automáticamente en respuesta a un evento (INSERT, UPDATE o DELETE) en una tabla determinada.
Cuando usar un trigger
-
Auditoria: registrar automáticamente quien modifico un dato y cuando.
-
Validaciones complejas: aplicar reglas de negocio que no se pueden expresar con CHECK.
-
Actualizar tablas relacionadas: al insertar un pedido, descontar automáticamente el stock del producto.
-
Cálculos automáticos: mantener un campo de total actualizado cuando cambian los detalles.
-
Replicación de datos: propagar cambios a tablas de resumen o histórico.
Crear un trigger
La sintaxis define WHEN (BEFORE o AFTER), que evento lo activa, y sobre que tabla. Dentro del cuerpo se usan las palabras especiales NEW (el registro nuevo) y OLD (el registro anterior al cambio).
-- Trigger: al insertar un pedido, descontar stock
automáticamente
CREATE TRIGGER trg_descontar_stock
AFTER INSERT ON detalle_pedido
FOR EACH ROW
BEGIN
UPDATE productos
SET stock = stock - NEW.cantidad
WHERE id_producto = NEW.id_producto;
END;
-- Ahora al hacer este INSERT:
INSERT INTO detalle_pedido (id_pedido, id_producto, cantidad, precio_unitario)
VALUES (201, 5, 3, 49.99);
-- Automáticamente el stock del producto 5 se reduce en 3.
-- No hace falta escribir el UPDATE de stock por separado.
-- Trigger de auditoria: registrar cambios de precio en productos
CREATE TRIGGER trg_auditoria_precio
AFTER UPDATE ON productos
FOR EACH ROW
BEGIN
IF OLD.precio <> NEW.precio THEN
INSERT INTO auditoria_precios (
id_producto, precio_anterior, precio_nuevo, fecha_cambio, usuario)
VALUES (NEW.id_producto, OLD.precio, NEW.precio,NOW(), USER());
END IF;
END;Los triggers son poderosos pero peligrosos si se abusa de ellos. Un trigger que falla aborta la operación original. Triggers que llaman a otros triggers (cascada) pueden crear bucles infinitos. Usarlos con criterio.
| Tipo | Cuando se ejecuta | NEW disponible | OLD disponible |
| BEFORE INSERT | Antes de insertar la fila nueva | Si | No |
| AFTER INSERT | Después de insertar la fila nueva | Si | No |
| BEFORE UPDATE | Antes de aplicar el cambio | Si (nuevo valor) | Si (valor anterior) |
| AFTER UPDATE | Después de aplicar el cambio | Si (nuevo valor) | Si (valor anterior) |
| BEFORE DELETE | Antes de borrar la fila | No | Si |
| AFTER DELETE | Después de borrar la fila | No | Si |
Capítulo 5 - Optimización de consultas y EXPLAIN
Una consulta SQL puede estar correcta y aun así ser muy lenta. La diferencia entre una query que tarda 0,001 segundos y una que tarda 30 segundos sobre la misma tabla puede ser simplemente la presencia o ausencia de un índice. Este capítulo explica como el motor decide como ejecutar una query y como diagnosticar problemas de rendimiento.
Este capítulo está basado en los Capítulos 13 y 14 de Silberschatz: ‘Procesamiento de Consultas’ y ‘Optimización de Consultas’. Esos capítulos describen en detalle los algoritmos internos que usa el motor para decidir el plan de ejecución.
Como procesa el motor una query
Cuando ejecutas un SELECT, el motor no lo corre directamente. Primero lo transforma internamente en varios pasos:
-
1. Parsing: verifica la sintaxis y que las tablas y columnas existan.
-
2. Traducción: convierte el SQL a una representación interna basada en algebra relacional.
-
3. Optimización: genera múltiples planes de ejecución equivalentes y estima el costo de cada uno (en accesos a disco).
-
4. Ejecución: ejecuta el plan elegido y devuelve el resultado.
La clave del paso 3 es que el optimizador usa estadísticas guardadas en el catálogo del sistema (número de filas, valores distintos por columna, histogramas de distribución) para estimar cual plan será más rápido. Si las estadísticas están desactualizadas, el optimizador puede elegir un plan subóptimo.
EXPLAIN: ver el plan de ejecución
EXPLAIN muestra el plan que el motor eligió para ejecutar una consulta, sin ejecutarla realmente. Es la herramienta fundamental para diagnosticar queries lentas.
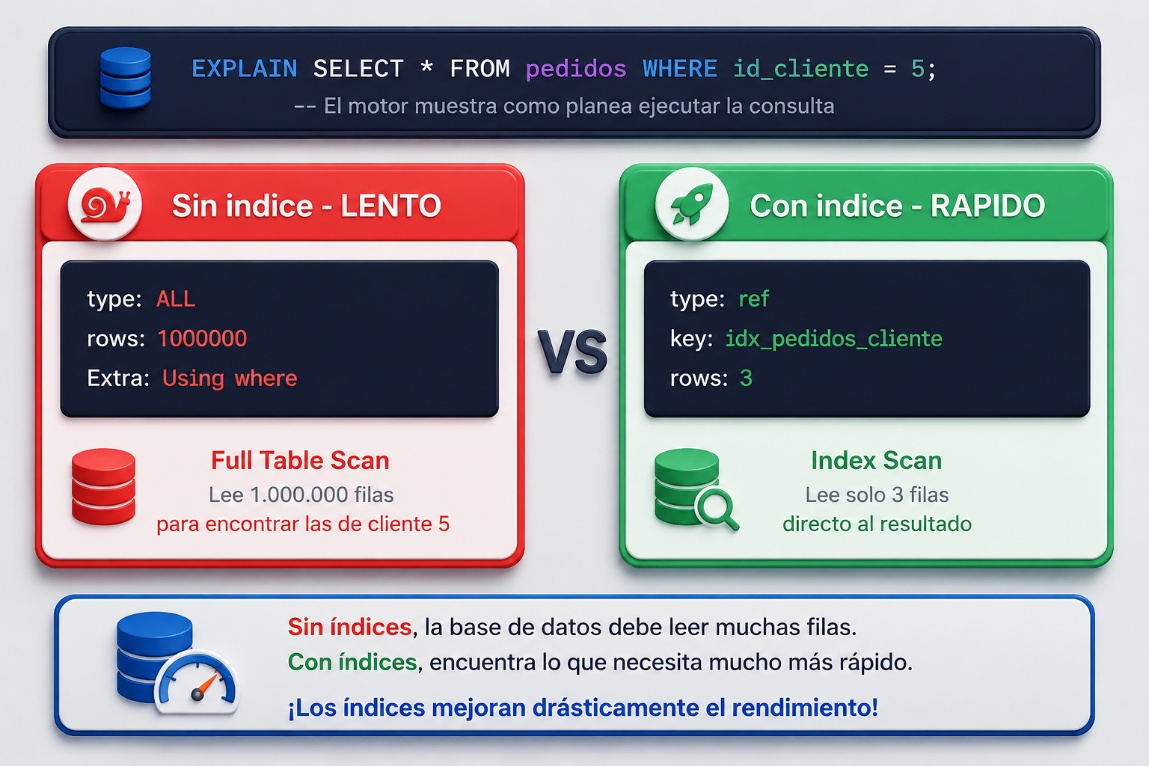
EXPLAIN revela si el motor usa un índice o escanea toda la tabla
-- Ver el plan de ejecución de una consulta:
EXPLAIN SELECT * FROM pedidos WHERE id_cliente = 5;
-- Resultado SIN índice (malo):
-- type: ALL | rows: 1000000 | Extra: Using where
-- Significa: lee TODA la tabla (Full Table Scan)
-- Crear el índice:
CREATE INDEX idx_pedidos_cliente ON pedidos (id_cliente);
-- Resultado CON índice (bueno):
-- type: ref | key: idx_pedidos_cliente | rows: 3
-- Significa: usa el índice, lee solo 3 filas| Valor en ‘type’ | Que significa | Velocidad |
| ALL | Full Table Scan: lee todas las filas | Muy lento en tablas grandes |
| index | Recorre todo el índice (mejor que ALL pero no ideal) | Lento |
| range | Usa el índice para un rango de valores | Aceptable |
| ref | Usa un índice no único para búsqueda exacta | Rápido |
| eq_ref | Usa un índice único (JOIN por PK) | Muy rápido |
| const/system | La tabla tiene una sola fila o resultado único | Instantáneo |
Reglas de oro de la optimización
1. Indexar las columnas del WHERE y JOIN
-- Consulta frecuente que filtra por ciudad:
SELECT * FROM clientes WHERE ciudad = 'Buenos Aires';
-- Sin índice: Full Table Scan en cada consulta
-- Con índice: búsqueda directa en milisegundos
CREATE INDEX idx_clientes_ciudad ON clientes (ciudad);
-- JOIN frecuente entre pedidos y clientes:
-- id_cliente en pedidos SIEMPRE debe estar indexado
CREATE INDEX idx_pedidos_cliente ON pedidos (id_cliente);
2. Evitar funciones sobre columnas indexadas en WHERE
-- MALO: la función YEAR() impide usar el índice de fecha
SELECT * FROM pedidos WHERE YEAR(fecha) = 2025;
-- BUENO: usar BETWEEN permite usar el índice
SELECT * FROM pedidos
WHERE fecha BETWEEN '2025-01-01' AND '2025-12-31';
-- MALO: función en columna indexada
SELECT * FROM clientes WHERE UPPER(nombre) = 'ANA GARCIA';
-- BUENO: guardar los datos ya normalizados y comparar directo
SELECT * FROM clientes WHERE nombre = 'Ana Garcia';
3. SELECT solo las columnas necesarias
-- MALO: trae todas las columnas, aunque solo uses dos
SELECT * FROM clientes WHERE ciudad = 'Rosario';
-- BUENO: solo las columnas que necesitas
SELECT nombre, email FROM clientes WHERE ciudad = 'Rosario';
-- En tablas con columnas TEXT o BLOB, esto puede ser
-- la diferencia entre traer 10KB o 10MB por fila.
4. Actualizar estadísticas regularmente
-- El optimizador usa estadísticas para elegir el plan.
-- Si la tabla creció mucho, actualizar las estadísticas:
ANALYZE TABLE pedidos; -- MySQL / MariaDB
ANALYZE pedidos; -- PostgreSQL
UPDATE STATISTICS pedidos; -- SQL Server / TeradataLa herramienta más valiosa de cualquier desarrollador de bases de datos es EXPLAIN. Antes de optimizar cualquier query, ejecuta EXPLAIN y lee el plan. El problema casi siempre es obvio una vez que lo ves.
Capítulo 6 - Control de concurrencia
En el mundo real, una base de datos no la usa un solo usuario a la vez. En un banco, miles de clientes pueden estar haciendo transacciones simultáneamente. En un e-commerce, docenas de usuarios pueden estar comprando el mismo producto al mismo tiempo. El control de concurrencia es el mecanismo que garantiza que esto funcione correctamente.
Este capítulo está basado en el Capítulo 16 de Silberschatz, ‘Control de Concurrencia’, y el Capítulo 15, ‘Transacciones’. Son dos de los capítulos más importantes del libro para entender cómo funciona un DBMS en producción.
El control de concurrencia es el conjunto de mecanismos que garantiza que la ejecución concurrente de transacciones produce el mismo resultado que si se hubieran ejecutado de forma secuencial, una por una.
Los problemas de la concurrencia sin control
Sin un mecanismo de control, las transacciones concurrentes pueden producir resultados incorrectos. Silberschatz describe tres problemas clásicos:
1. Lectura sucia (Dirty Read)
Una transacción lee datos que otra transacción modifico, pero todavía no confirmo. Si la primera transacción hace ROLLBACK, la segunda leyó datos que nunca existieron oficialmente.
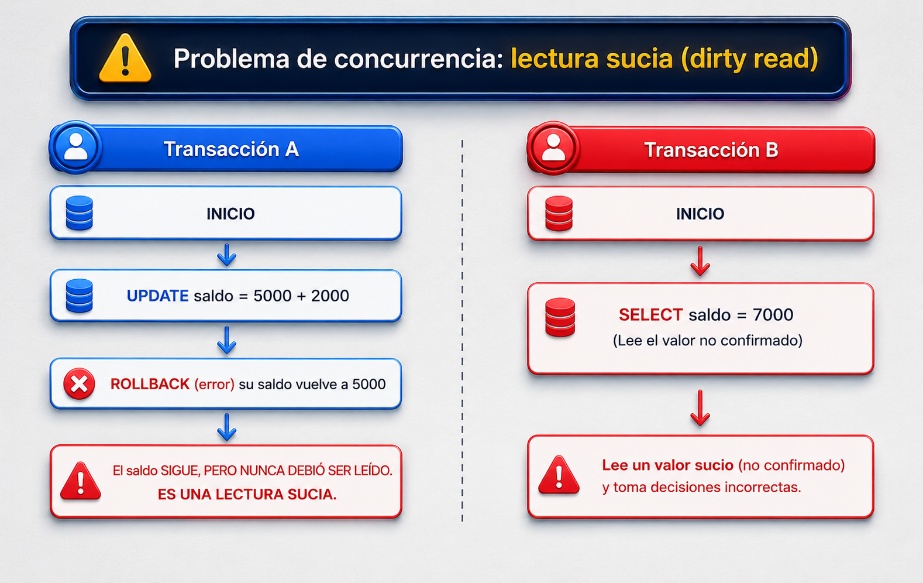
Lectura sucia: la transacción B lee un valor que la transacción A nunca confirmo
2. Lectura no repetible (Non-Repeatable Read)
Una transacción lee el mismo dato dos veces y obtiene valores distintos porque otra transacción lo modifico entre las dos lecturas.
-- Transacción A: -- Transacción B:
BEGIN; BEGIN;
SELECT saldo FROM cuenta -- (nada todavía)
WHERE id = 1; -- lee 1000
UPDATE cuenta SET saldo = 500
WHERE id = 1;
COMMIT;
SELECT saldo FROM cuenta
WHERE id = 1; -- ahora lee 500 -- Misma query, distinto
resultado!
COMMIT;
3. Lectura fantasma (Phantom Read)
Una transacción ejecuta una consulta dos veces con la misma condición y obtiene filas distintas porque otra transacción inserto o borro filas entre medio.
-- transacción A: -- transacción B:
BEGIN;
SELECT COUNT(*) FROM pedidos -- cuenta 50 pedidos
WHERE id_cliente = 1;
INSERT INTO pedidos ...; COMMIT;
SELECT COUNT(*) FROM pedidos -- ahora cuenta 51!
WHERE id_cliente = 1; -- apareció una 'fila fantasma'
COMMIT;
Niveles de aislamiento
SQL estándar define 4 niveles de aislamiento que establecen un balance entre consistencia y rendimiento. A mayor aislamiento, mayor consistencia, pero menor concurrencia (más bloqueos, más espera).
| Nivel | Dirty Read | Non-Repeatable | Phantom Read | Rendimiento |
| READ UNCOMMITTED | Posible | Posible | Posible | Máximo |
| READ COMMITTED | No | Posible | Posible | Alto |
| REPEATABLE READ | No | No | Posible | Medio |
| SERIALIZABLE | No | No | No | Mas bajo |
-- Cambiar el nivel de aislamiento de una transacción:
SET TRANSACTION ISOLATION LEVEL READ COMMITTED;
BEGIN;
SELECT * FROM cuentas WHERE id = 1;
-- Aqui no se pueden leer datos sin confirmar de otras transacciones
COMMIT;
-- READ COMMITTED es el nivel por defecto en la mayoría de los DBMS
-- SERIALIZABLE es el más seguro pero el más restrictivo
Mecanismo de bloqueos (Locks)
El mecanismo más común para implementar el aislamiento son los bloqueos. Cuando una transacción accede a un dato, lo bloquea para que otras transacciones no puedan modificarlo al mismo tiempo.
-
Lock compartido (Shared Lock / S): varias transacciones pueden leer el mismo dato simultáneamente, pero ninguna puede modificarlo.
-
Lock exclusivo (Exclusive Lock / X): solo una transacción puede acceder al dato. Nadie más puede ni leer ni modificar hasta que se libere.
-- Bloqueo explicito para lectura (evita que otros modifiquen):
SELECT * FROM cuentas WHERE id = 1 FOR SHARE;
-- Bloqueo exclusivo para escritura (nadie más puede tocar la fila):
SELECT * FROM cuentas WHERE id = 1 FOR UPDATE;
-- Patron seguro para transferencia bancaria:
BEGIN;
SELECT saldo FROM cuentas WHERE id = 1 FOR UPDATE; -- bloquea fila
SELECT saldo FROM cuentas WHERE id = 2 FOR UPDATE; -- bloquea fila
UPDATE cuentas SET saldo = saldo - 300 WHERE id = 1;
UPDATE cuentas SET saldo = saldo + 300 WHERE id = 2;
COMMIT; -- libera los bloqueos
Deadlock: el abrazo mortal
Un deadlock ocurre cuando dos transacciones se bloquean mutuamente esperando que la otra libere un recurso. Ninguna puede avanzar y el sistema queda trabado.
-- transacción A: -- transacción B:
BEGIN; BEGIN;
LOCK cuenta 1; LOCK cuenta 2;
-- intenta lockear cuenta 2... -- intenta lockear cuenta 1...
-- ESPERA a que B libere -- ESPERA a que A libere
-- DEADLOCK: ninguna puede avanzar
-- El motor detecta el deadlock y aborta una de las dos transacciones.
-- La transacción abortada recibe un error y debe reintentarse.Para evitar deadlocks la regla de oro es: siempre acceder a las tablas y filas en el mismo orden en todas las transacciones. Si A y B siempre bloquean primero cuenta 1 y luego cuenta 2, nunca habrá deadlock.
Los deadlocks son inevitables en sistemas de alta concurrencia. Lo importante es que el motor los detecte rápidamente y que la aplicación esté preparada para reintentar la transacción abortada automáticamente.
Resumen del Nivel 3
Con este nivel completaste el salto de principiante a desarrollador intermedio de bases de datos. Estos son los conceptos que ahora manejas:
| Tema | Concepto clave | Para que sirve |
| INNER JOIN | Une tablas por coincidencia | La base de cualquier reporte con múltiples tablas |
| LEFT JOIN | Incluye todas las filas de la izquierda | Detectar registros sin relación, reportes completos |
| FULL OUTER JOIN | Incluye todas las filas de ambas tablas | Auditorias y comparaciones de conjuntos |
| Subquery IN/NOT IN | Filtro basado en otra consulta | Reemplaza múltiples queries separadas |
| EXISTS / NOT EXISTS | Verifica si hay coincidencia | Mas eficiente que IN en tablas grandes |
| CTE (WITH) | Consulta temporal con nombre | Hace legible la lógica compleja |
| Stored Procedure | Lógica SQL guardada en el servidor | Reutilización, seguridad, rendimiento |
| Funcion SQL | Devuelve un valor escalar | Cálculos reutilizables dentro de queries |
| Trigger | Código que se dispara solo ante eventos | Auditoria, stock automático, validaciones |
| EXPLAIN | Muestra el plan de ejecución | Diagnosticar y solucionar queries lentas |
| Índices en JOIN/WHERE | Evitar full table scan | La optimización más impactante disponible |
| Niveles de aislamiento | Controlan visibilidad entre transacciones | Balance entre consistencia y concurrencia |
| Locks | Bloquean filas o tablas | Garantizan consistencia en escrituras concurrentes |
| Deadlock | Bloqueo mutuo entre transacciones | Conocer el patrón para prevenirlo |
El siguiente paso natural es el Nivel 4: Normalización y Diseño de Esquemas (modelo entidad-relación, 1FN/2FN/3FN, diseño desde cero), y luego Administración (backup, recovery, seguridad, monitoreo).
Fin del Nivel 3 - Siguiente: Nivel 4 - Diseño, Normalización y Administración
Nivel 4 - Diseño y Normalización
Anomalías - 1FN / 2FN / 3FN - Modelo Entidad-Relación - Diseño desde cero
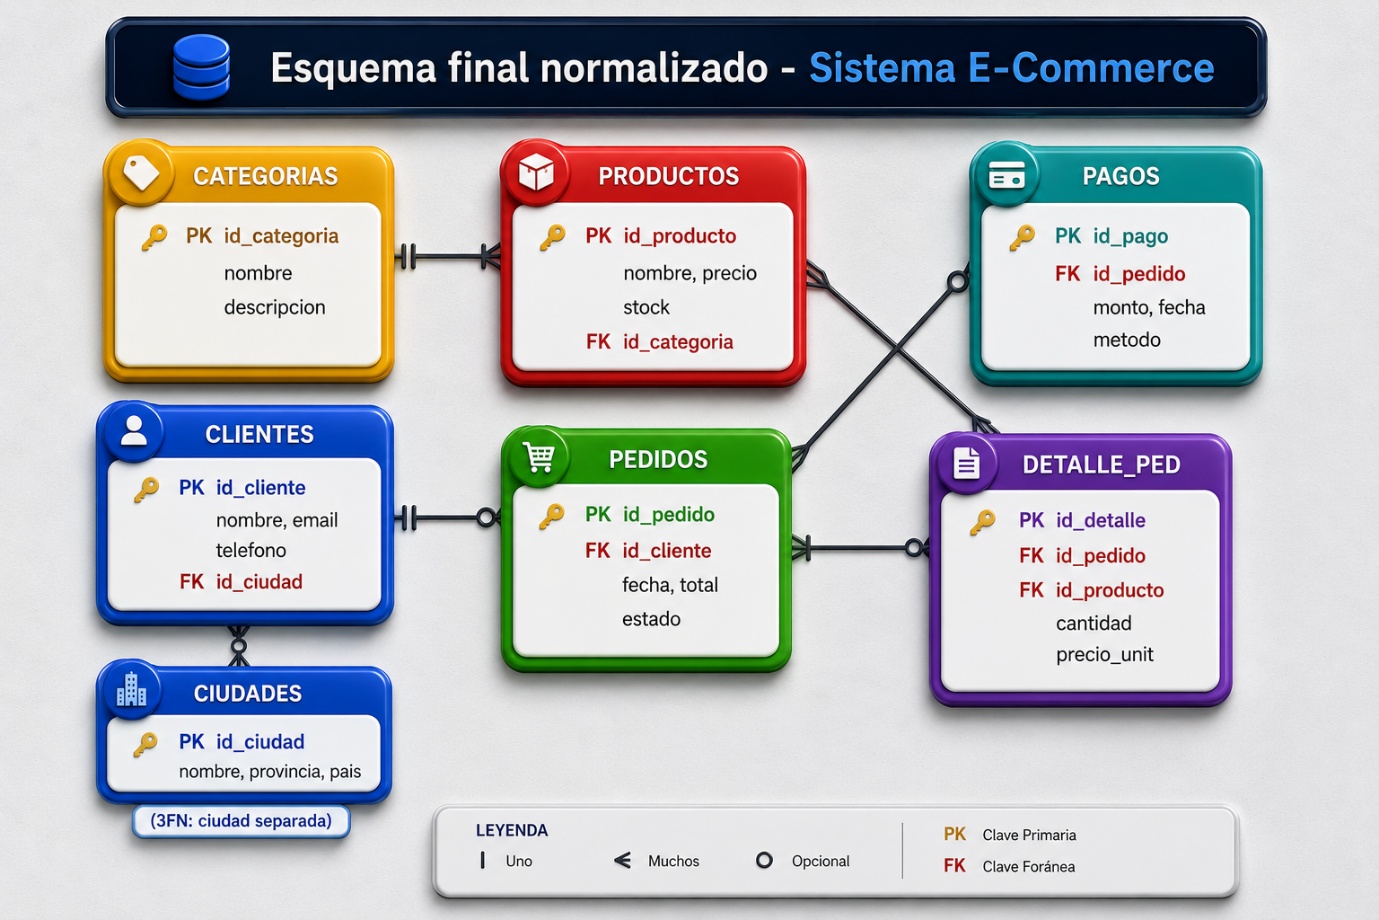
El esquema normalizado del sistema e-commerce que diseñamos paso a paso en este manual
“Basado en Fundamentos de Bases de Datos, Silberschatz - Korth - Sudarshan (4a Ed.)”
Introducción
En los niveles anteriores aprendiste a consultar datos, a garantizar su consistencia, a optimizar las queries y a usar las herramientas avanzadas del motor. En este nivel 4 vas un paso más atrás: antes de escribir una sola línea de SQL, hay que diseñar bien la base de datos.
Un mal diseño genera problemas que ningún índice ni ninguna optimización puede resolver. Una base de datos bien desenada desde el principio ahorra semanas de trabajo de corrección después.
-
Capítulo 1: Por qué importa el diseño: las anomalías
-
Capítulo 2: Dependencias funcionales: el fundamento teórico
-
Capítulo 3: Primera Forma Normal (1FN)
-
Capítulo 4: Segunda Forma Normal (2FN)
-
Capítulo 5: Tercera Forma Normal (3FN)
-
Capítulo 6: El Modelo Entidad-Relación (ERD)
-
Capítulo 7: Diseñando desde cero: el sistema e-commerce completo
El contenido teórico está basado en el Capítulo 7 de Silberschatz (‘Diseño de Bases de Datos Relacionales’) y el Capítulo 2 (‘Modelo Entidad-Relación’). Los ejemplos usan el sistema e-commerce que conoces de los niveles anteriores.
Capítulo 1 - Por qué importa el diseño: las anomalías
Imagina que guardas toda la información de tu negocio en una sola tabla enorme: clientes, pedidos y productos juntos. Al principio parece practico. Con el tiempo, empiezan los problemas. Silberschatz los llama anomalías de diseño y son la consecuencia directa de mezclar datos de distintas entidades en la misma tabla.
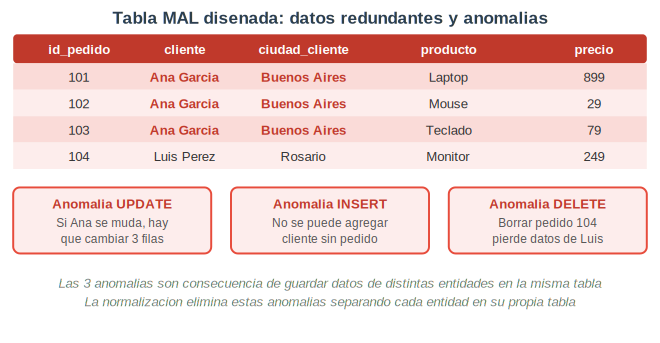
Una tabla mal desenada genera tres tipos de anomalías que corrompen o pierden datos
Anomalía de actualización (Update Anomaly)
Si un dato se repite en muchas filas, actualizar ese dato requiere modificar todas las filas donde aparece. Si se actualiza solo algunas, la base queda en estado inconsistente con versiones distintas del mismo dato.
En la tabla del ejemplo, Ana Garcia aparece en 3 filas con Buenos Aires como ciudad. Si Ana se muda a Cordoba, hay que actualizar 3 filas. Si alguien actualiza solo 2, la base de datos quedara con dos ciudades distintas para la misma persona.
Anomalía de inserción (Insert Anomaly)
No se puede insertar un dato sin insertar datos de otra entidad que no corresponden. En la tabla del ejemplo, no se puede agregar un cliente nuevo sin que tenga al menos un pedido, porque id_pedido es parte de la clave y no puede ser nulo.
Anomalía de borrado (Delete Anomaly)
Al borrar un dato de una entidad, se pierden involuntariamente datos de otra. En el ejemplo, si borramos el pedido 104 (el único de Luis Perez), perdemos toda la información del cliente Luis junto con el pedido.
La causa de las tres anomalías es siempre la misma: guardar datos de entidades distintas (clientes, pedidos, productos) en una sola tabla. La solución es la normalización.
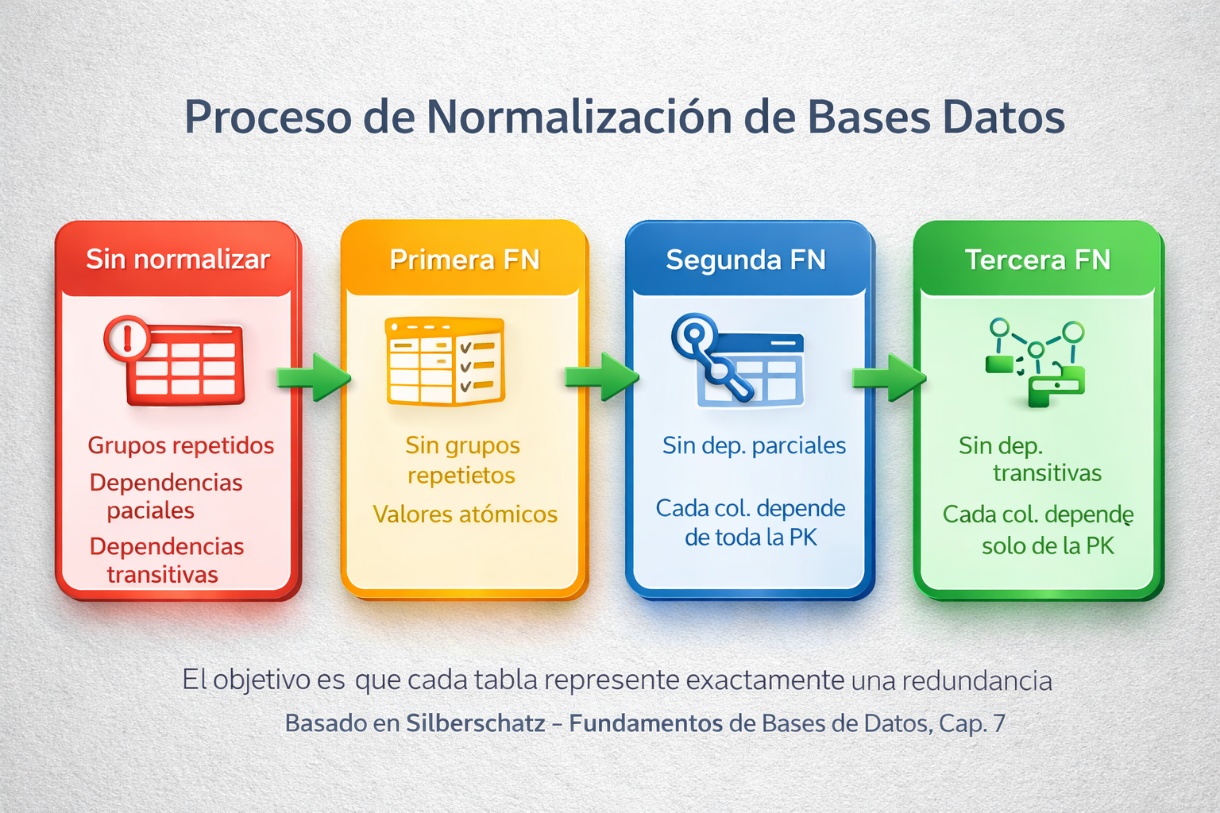
El proceso de normalización lleva una tabla mal desenada a la 3FN paso a paso
Capítulo 2 - Dependencias funcionales
Antes de normalizar hay que entender el concepto que funda toda la teoría de normalización: las dependencias funcionales. Es el concepto central del Capítulo 7 de Silberschatz y la herramienta que permite razonar formalmente sobre el diseño.
Una dependencia funcional X -> Y significa que el valor de X determina de forma única el valor de Y. Conociendo X, siempre se puede saber cuál es Y.
Ejemplos concretos sobre nuestras tablas:
-- id_cliente -> nombre (conociendo el id, se sabe el nombre)
-- id_cliente -> ciudad (conociendo el id, se sabe la ciudad)
-- id_producto -> precio (conociendo el producto, se sabe el precio)
-- id_pedido -> fecha (conociendo el pedido, se sabe la fecha)
-- id_pedido -> id_cliente (conociendo el pedido, se sabe quién lo hizo)
-- Dependencia funcional PARCIAL (problema de 2FN):
-- {id_pedido, id_producto} -> cantidad (OK: depende de la clave completa)
-- {id_pedido, id_producto} -> nombre_prod (MAL: nombre depende solo de id_producto)
-- Dependencia funcional TRANSITIVA (problema de 3FN):
-- id_cliente -> cod_postal (el cliente determina el código postal)
-- cod_postal -> ciudad (el código postal determina la ciudad)
-- Por lo tanto: id_cliente -> ciudad (a través de cod_postal)
Identificar las dependencias funcionales de una tabla es el primer paso para normalizarla. Las formas normales son restricciones sobre que tipos de dependencias pueden existir dentro de una tabla.
Una forma práctica de encontrar dependencias: preguntarse para cada columna: ‘dado el valor de la clave primaria, queda determinado de forma única el valor de esta columna?’ Si la respuesta es sí, hay una dependencia funcional.
Capítulo 3 - Primera Forma Normal (1FN)
La Primera Forma Normal es el requisito mínimo para que una tabla sea relacional. Sin 1FN, el modelo relacional no puede funcionar correctamente.
Una tabla está en 1FN si todos sus atributos contienen valores atómicos (indivisibles) y no existen grupos repetidos ni listas dentro de una columna.
Que viola la 1FN
Valores no atómicos: múltiples valores en una celda
-- MAL: la columna teléfonos tiene múltiples valores en una celda
id_cliente | nombre 	 | telefonos
1          | Ana Garcia  | 011-1234, 011-5678, 011-9999
-- BIEN: una fila por cada valor atómico
CREATE TABLE telefonos_cliente (
id_telefono INT PRIMARY KEY,
id_cliente INT NOT NULL,
teléfono VARCHAR(20) NOT NULL,
tipo VARCHAR(10), -- celular, fijo, trabajo
FOREIGN KEY (id_cliente) REFERENCES clientes(id_cliente)
);
Grupos repetidos: columnas que repiten la misma información
-- MAL: columnas producto1, producto2, producto3 son grupos repetidos
id_pedido | producto1 | precio1 | producto2 | precio2 | producto3 | precio3
101       | Laptop    |$ 899    | Mouse     | $ 29    | NULL      | NULL
-- BIEN: una tabla separada con una fila por cada item
CREATE TABLE detalle_pedido (
id_detalle INT PRIMARY KEY,
id_pedido INT NOT NULL,
id_producto INT NOT NULL,
cantidad INT NOT NULL,
precio_unitario DECIMAL(10,2) NOT NULL,
FOREIGN KEY (id_pedido) REFERENCES pedidos(id_pedido),
FOREIGN KEY (id_producto) REFERENCES productos(id_producto)
);
Regla practica para verificar 1FN
-
Cada celda de la tabla tiene exactamente un valor.
-
No hay columnas que repitan el mismo tipo de dato (producto1, producto2…).
-
Cada fila es única: existe una clave primaria que la identifica.
Guardar listas como texto separado por comas (‘rojo,azul,verde’) viola la 1FN aunque este en una sola celda. Para listas de longitud variable siempre se necesita una tabla separada.
Capítulo 4 - Segunda Forma Normal (2FN)
La 2FN aplica a tablas que tienen una clave primaria compuesta (formada por dos o más columnas). El problema que resuelve son las dependencias parciales: columnas que no dependen de toda la clave sino solo de una parte de ella.
Una tabla está en 2FN si está en 1FN y todos los atributos no clave dependen de la clave primaria completa, no de una parte de ella.
Ejemplo de violación de 2FN
Supongamos una tabla detalle_pedido mal diseñada que incluye datos del producto:
-- MAL: clave primaria compuesta {id_pedido, id_producto}
-- pero nombre_producto y precio solo dependen de id_producto detalle_pedido_mal:
PK: {id_pedido, id_producto}
cantidad -> depende de {id_pedido, id_producto} OK
precio_unitario -> depende de {id_pedido, id_producto} OK
nombre_producto -> depende solo de id_producto MAL (dep.parcial)
categoría -> depende solo de id_producto MAL (dep.parcial)
solución: separar en dos tablas
-- BIEN: cada tabla con su propia clave y sus propias
dependencias
-- Tabla 1: información del producto (depende de id_producto)
CREATE TABLE productos (
id_producto INT PRIMARY KEY,
nombre_producto VARCHAR(150) NOT NULL,
categoría VARCHAR(50),
precio_base DECIMAL(10,2)
);
-- Tabla 2: detalle del pedido (depende de {id_pedido, id_producto})
CREATE TABLE detalle_pedido (
id_detalle INT PRIMARY KEY,
id_pedido INT NOT NULL,
id_producto INT NOT NULL,
cantidad INT NOT NULL,
precio_unitario DECIMAL(10,2) NOT NULL, -- precio en el momento del pedido
FOREIGN KEY (id_pedido) REFERENCES pedidos(id_pedido),
FOREIGN KEY (id_producto) REFERENCES productos(id_producto)
);precio_unitario en detalle_pedido NO es una violación de 2FN aunque productos tenga precio_base. Son dos cosas distintas: el precio al momento de la venta puede diferir del precio actual del producto. Este es un ejemplo de dato que correctamente pertenece al detalle del pedido.
Regla practica para verificar 2FN
-
Si la clave primaria es de una sola columna, la tabla automáticamente cumple 2FN.
-
Si la PK es compuesta, verificar que cada columna no clave dependa de TODAS las columnas de la PK, no solo de alguna.
-
Si una columna depende solo de parte de la PK, moverla a una tabla separada.
Capítulo 5 - Tercera Forma Normal (3FN)
La 3FN elimina las dependencias transitivas: situaciones donde una columna no clave depende de otra columna no clave, en lugar de depender directamente de la clave primaria.
Una tabla está en 3FN si está en 2FN y ningún atributo no clave depende de otro atributo no clave. Todo atributo no clave debe depender directa y únicamente de la clave primaria.
Ejemplo de violación de 3FN
Una tabla de clientes que incluye la ciudad y el Código postal viola la 3FN si el Código postal determina la ciudad:
-- MAL: dependencia transitiva
-- id_cliente -> cod_postal -> ciudad
-- ciudad no depende directamente de id_cliente
-- depende de cod_postal, que a su vez depende de id_cliente clientes_mal:
PK: id_cliente
nombre -> depende de id_cliente OK
email -> depende de id_cliente OK
cod_postal -> depende de id_cliente OK
ciudad -> depende de cod_postal MAL (dep. transitiva)
provincia -> depende de cod_postal MAL (dep. transitiva)
solución: separar la dependencia transitiva
-- BIEN: cada entidad en su propia tabla
CREATE TABLE codigos_postales (
cod_postal CHAR(8) PRIMARY KEY,
ciudad VARCHAR(100) NOT NULL,
provincia VARCHAR(100) NOT NULL
);
CREATE TABLE clientes (
id_cliente INT PRIMARY KEY,
nombre VARCHAR(150) NOT NULL,
email VARCHAR(200) UNIQUE,
cod_postal CHAR(8),
FOREIGN KEY (cod_postal) REFERENCES codigos_postales(cod_postal)
);
-- Ahora si la ciudad de un código postal cambia,
-- se actualiza en UN solo lugar: la tabla codigos_postales.
-- No hay anomalía de actualización.
Otro ejemplo clásico de 3FN: empleados y departamentos
-- MAL: id_empleado -> id_depto -> nombre_depto -> jefe_depto
CREATE TABLE empleados_mal (
id_empleado INT PRIMARY KEY,
nombre VARCHAR(150),
id_depto INT,
nombre_depto VARCHAR(100), -- dep. transitiva via id_depto
jefe_depto VARCHAR(150) -- dep. transitiva via id_depto
);
-- BIEN: separar departamentos en su propia tabla
CREATE TABLE departamentos (
id_depto INT PRIMARY KEY,
nombre_depto VARCHAR(100) NOT NULL,
jefe_depto VARCHAR(150)
);
CREATE TABLE empleados (
id_empleado INT PRIMARY KEY,
nombre VARCHAR(150) NOT NULL,
id_depto INT,
FOREIGN KEY (id_depto) REFERENCES departamentos(id_depto)
);| Forma Normal | Que elimina | Pregunta clave |
| 1FN | Valores no atómicos y grupos repetidos | ¿Cada celda tiene un solo valor? |
| 2FN | Dependencias parciales (solo en PK compuesta) | ¿Cada columna depende de TODA la PK? |
| 3FN | Dependencias transitivas | ¿Cada columna depende DIRECTAMENTE de la PK? |
| FNBC (opcional) | Dependencias de atributos candidatos | ¿Todo determinante es una superclase? |
Normalizar hasta 3FN es el objetivo estándar en el diseño relacional. Ir mas allá (FNBC, 4FN, 5FN) es necesario solo en casos muy específicos. En la práctica profesional, llegar a 3FN correctamente es lo que separa un buen diseño de uno problemático.
Capítulo 6 - El Modelo Entidad-Relación (ERD)
El Modelo Entidad-Relación (ER) es una herramienta visual para diseñar la estructura de una base de datos antes de escribir SQL. Fue propuesto por Peter Chen en 1976 y sigue siendo el estándar de la industria para comunicar el diseño de datos. Silberschatz lo dedica todo el Capítulo 2 de su libro.
Un Diagrama Entidad-Relación (ERD) es una representación gráfica de las entidades del mundo real que se quieren modelar, sus atributos y las relaciones entre ellas.
Los elementos del ERD
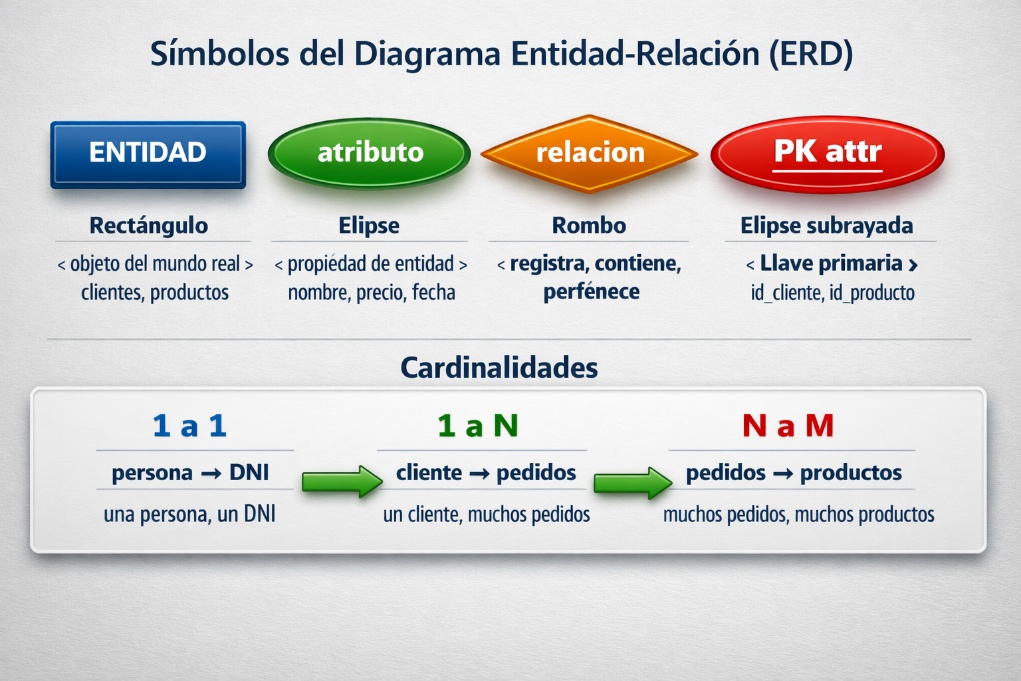
Los cuatro símbolos fundamentales del ERD y los tres tipos de cardinalidad
Entidades
Una entidad es cualquier objeto del mundo real sobre el que queremos guardar información: un cliente, un producto, un pedido, un empleado. Se representan como rectángulos. En SQL se convierten en tablas.
-- Las entidades principales de nuestro sistema e-commerce:
-- CLIENTES, PRODUCTOS, PEDIDOS, CATEGORIAS, PAGOS
Atributos
Los atributos son las propiedades de cada entidad. Se representan como elipses conectadas a la entidad. En SQL se convierten en columnas. El atributo que es clave primaria se subraya.
-
Atributo simple: un solo valor. nombre, precio, fecha.
-
Atributo compuesto: se divide en partes. dirección = calle + numero + ciudad.
-
Atributo derivado: se calcula de otros. edad se deriva de fecha_nacimiento.
-
Atributo multivaluado: puede tener varios valores. teléfonos de un cliente.
Relaciones y cardinalidades
Las relaciones vinculan dos entidades. La cardinalidad indica cuantas instancias de una entidad pueden relacionarse con cuantas de la otra. Es el concepto más importante del ERD.
| Cardinalidad | Ejemplo | implementación en SQL |
| 1 a 1 (1:1) | Persona - Pasaporte | FK en cualquiera de las dos tablas |
| 1 a Muchos (1:N) | Cliente - Pedidos | FK en el lado N (id_cliente en pedidos) |
| Muchos a Muchos (N:M) | Pedidos - Productos | Tabla intermedia con dos FK |
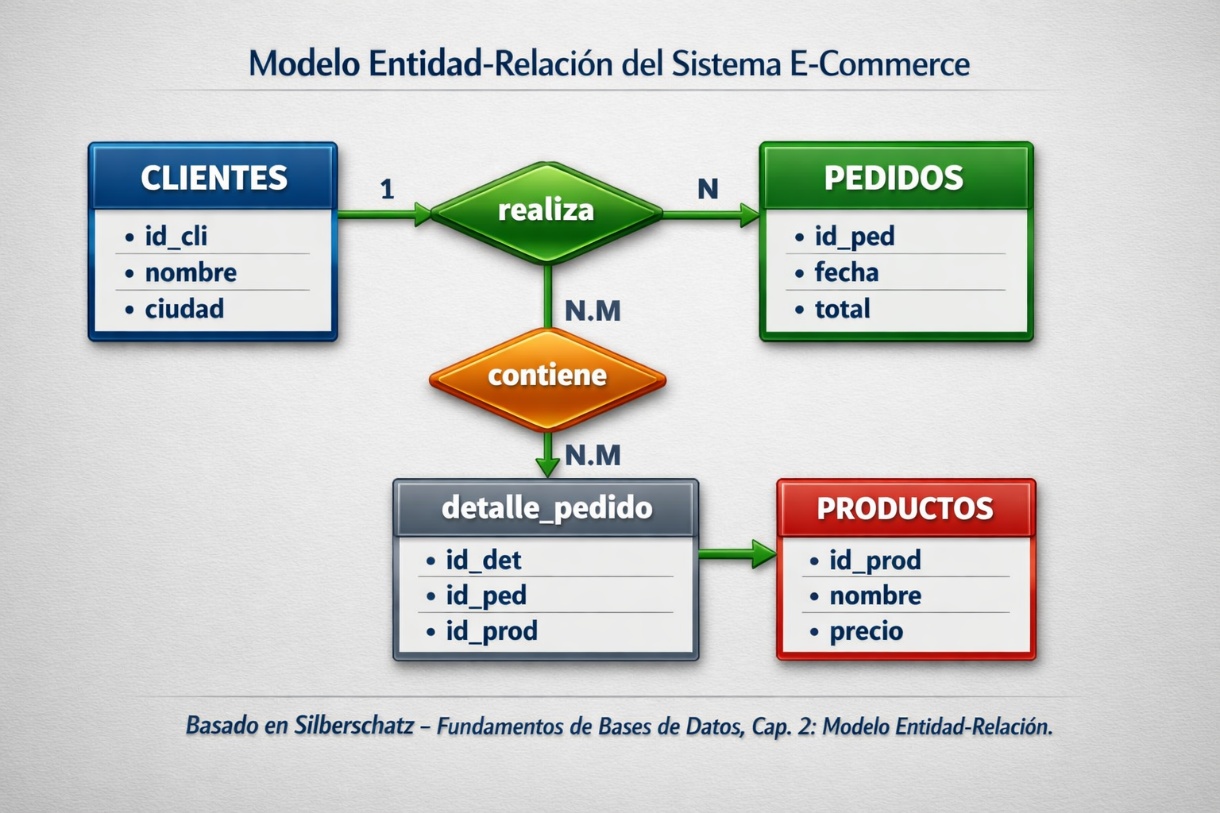
ERD del sistema e-commerce: entidades, atributos, relaciones y cardinalidades
De ERD a tablas SQL: las reglas de conversión
Una vez que el ERD está completo, convertirlo a tablas SQL sigue reglas sistemáticas. Silberschatz las describe en el Apartado 2.9 (‘Reducción de un esquema E-R a tablas’).
-- REGLA 1: Cada entidad se convierte en una tabla
-- CLIENTES -> tabla clientes
-- PRODUCTOS -> tabla productos
-- PEDIDOS -> tabla pedidos
-- REGLA 2: Relación 1:N -> FK en el lado N
-- Cliente REALIZA Pedido (1:N)
-- -> agregar id_cliente como FK en la tabla pedidos
-- REGLA 3: Relación N:M -> tabla intermedia
-- Pedido CONTIENE Producto (N:M)
-- -> crear tabla detalle_pedido con FK a pedidos y FK a productos
-- REGLA 4: Relación 1:1 -> FK en la tabla que tiene cardinalidad total
-- Si cada empleado TIENE exactamente un contrato:
-- -> agregar id_empleado como FK en la tabla contratos
-- REGLA 5: Atributos multivaluados -> tabla separada
-- Si un cliente puede tener varios teléfonos:
-- -> crear tabla telefonos_cliente con FK a clientes
Capítulo 7 - Diseñando desde cero: el sistema e-commerce
Ahora aplicamos todo lo visto para diseñar el esquema completo del sistema e-commerce que usamos en todos los manuales anteriores. Seguimos el proceso completo: identificar entidades, definir atributos, establecer relaciones, verificar las formas normales y generar el SQL.
Paso 1: Identificar las entidades
El primer paso es leer los requisitos del negocio y extraer los objetos sobre los que necesitamos guardar información.
- Los clientes se registran con nombre, email, teléfono y ciudad - Los productos tienen nombre, descripción, precio y stock - Los productos pertenecen a una categoría - Los clientes hacen pedidos - Cada pedido puede tener uno o varios productos en distintas cantidades - Los pedidos se pagan por distintos medios (tarjeta, transferencia, etc.) Entidades identificadas: - CLIENTES - PRODUCTOS - CATEGORIAS - PEDIDOS - DETALLE_PEDIDO (tabla intermedia para la relación N:M) - PAGOS
Paso 2: Definir atributos y claves primarias
CLIENTES: id_cliente (PK), nombre, email, teléfono, id_ciudad (FK)
CIUDADES: id_ciudad (PK), nombre, provincia <- separada por 3FN
CATEGORIAS: id_categoria (PK), nombre, descripcion
PRODUCTOS: id_producto (PK), nombre, descripcion, precio, stock, id_categoria (FK)
PEDIDOS: id_pedido (PK), fecha, total, estado, id_cliente (FK)
DETALLE_PEDIDO: id_detalle (PK), id_pedido (FK), id_producto (FK), cantidad, precio_unitario, descuento
PAGOS: id_pago (PK), id_pedido (FK), monto, fecha, metodo
Paso 3: Verificar las 3 formas normales
Verificación 1FN:
OK - Todos los valores son atómicos
OK - No hay grupos repetidos (detalle_pedido resuelve la relacion N:M)
OK - Cada tabla tiene clave primaria
Verificación 2FN:
OK - CLIENTES: PK simple (id_cliente), no puede haber dep. parciales
OK - PRODUCTOS: PK simple (id_producto), no puede haber dep. parciales
OK - DETALLE_PEDIDO: cantidad y precio_unitario dependen del par {id_pedido + id_producto}. Sin dep. parciales.
Verificación 3FN:
ATENCION - En CLIENTES: id_cliente->ciudad->provincia (dep. transitiva)
SOLUCION - Separar en tabla CIUDADES (ya está en el diseño)
OK - Con CIUDADES separada, CLIENTES solo guarda id_ciudad (FK)
OK - Todas las demás tablas: cada columna depende directamente de su PK
Paso 4: El esquema final en SQL
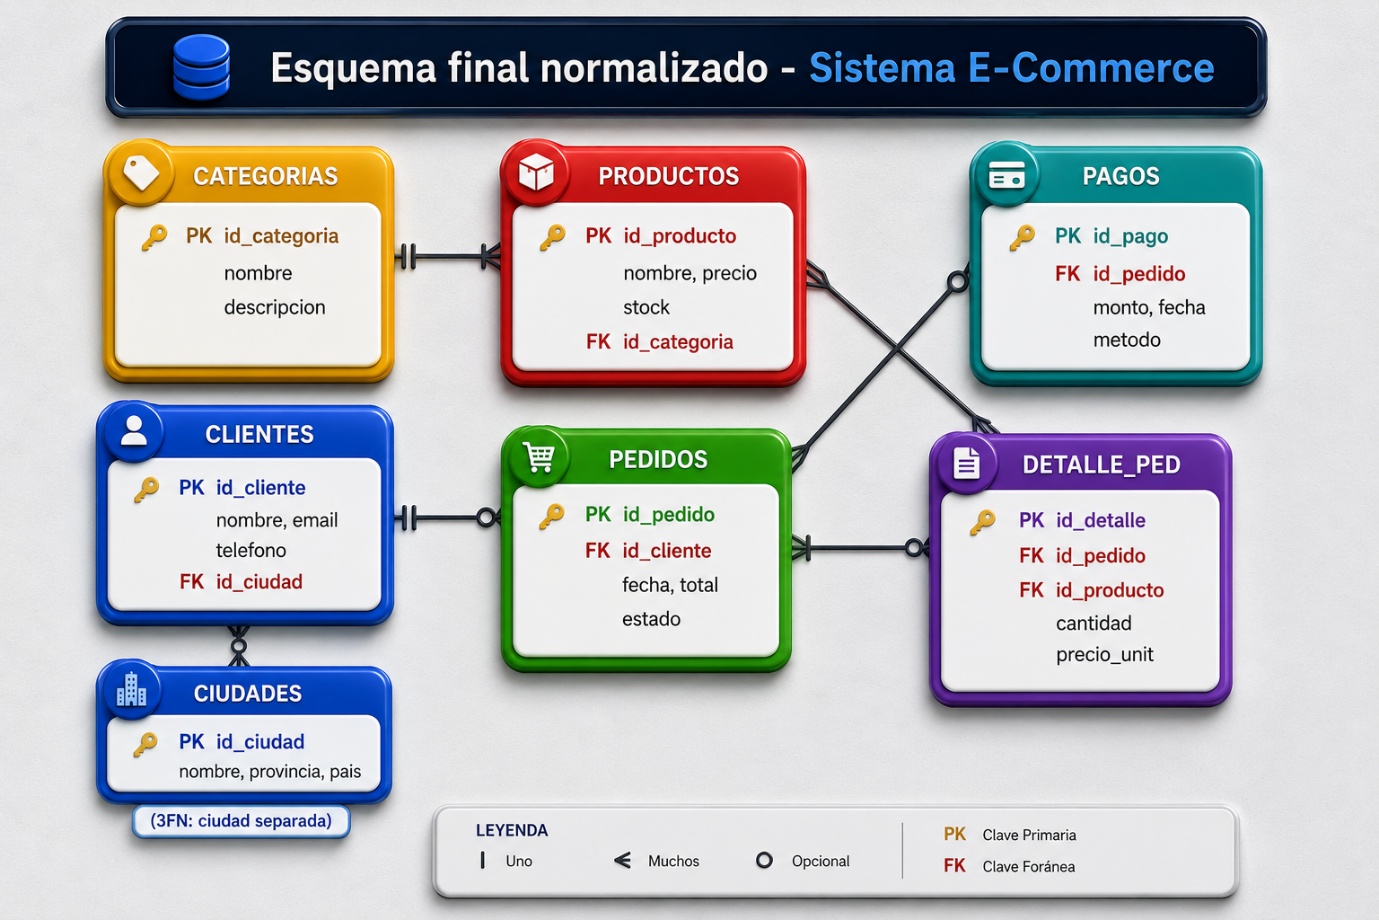
El esquema completo normalizado con todas las relaciones entre tablas
-- 1. Tablas sin dependencias externas primero
CREATE TABLE ciudades (
id_ciudad INT PRIMARY KEY,
nombre VARCHAR(100) NOT NULL,
provincia VARCHAR(100) NOT NULL
);
CREATE TABLE categorias (
id_categoria INT PRIMARY KEY,
nombre VARCHAR(100) NOT NULL,
descripcion TEXT
);
-- 2. Tablas con FK a las anteriores
CREATE TABLE clientes (
id_cliente INT PRIMARY KEY,
nombre VARCHAR(150) NOT NULL,
email VARCHAR(200) UNIQUE,
teléfono VARCHAR(30),
id_ciudad INT,
FOREIGN KEY (id_ciudad) REFERENCES ciudades(id_ciudad)
);
CREATE TABLE productos (
id_producto INT PRIMARY KEY,
nombre VARCHAR(150) NOT NULL,
descripcion TEXT,
precio DECIMAL(10,2) NOT NULL CHECK (precio >= 0),
stock INT NOT NULL DEFAULT 0,
activo BOOLEAN DEFAULT TRUE,
id_categoria INT,
FOREIGN KEY (id_categoria) REFERENCES categorias(id_categoria)
);
-- 3. Pedidos depende de clientes
CREATE TABLE pedidos (
id_pedido INT PRIMARY KEY,
fecha TIMESTAMP NOT NULL DEFAULT CURRENT_TIMESTAMP,
total DECIMAL(10,2) NOT NULL DEFAULT 0,
estado VARCHAR(20) NOT NULL DEFAULT 'pendiente'
CHECK (estado IN
('pendiente','confirmado','enviado','entregado','cancelado')),
id_cliente INT NOT NULL,
FOREIGN KEY (id_cliente) REFERENCES clientes(id_cliente)
);
-- 4. Tablas intermedias y dependientes al final
CREATE TABLE detalle_pedido (
id_detalle INT PRIMARY KEY,
id_pedido INT NOT NULL,
id_producto INT NOT NULL,
cantidad INT NOT NULL CHECK (cantidad > 0),
precio_unitario DECIMAL(10,2) NOT NULL,
descuento DECIMAL(4,2) DEFAULT 0.00,
FOREIGN KEY (id_pedido) REFERENCES pedidos(id_pedido),
FOREIGN KEY (id_producto) REFERENCES productos(id_producto)
);
CREATE TABLE pagos (
id_pago INT PRIMARY KEY,
id_pedido INT NOT NULL,
monto DECIMAL(10,2) NOT NULL,
fecha TIMESTAMP NOT NULL DEFAULT CURRENT_TIMESTAMP,
metodo VARCHAR(30) NOT NULL
CHECK (metodo IN
('tarjeta','transferencia','efectivo','mercadopago')),
estado VARCHAR(20) DEFAULT 'aprobado',
FOREIGN KEY (id_pedido) REFERENCES pedidos(id_pedido)
);
Paso 5: Índices para el esquema
Una vez creadas las tablas, agregar los índices sobre las columnas de JOIN y WHERE más frecuentes:
-- Índices sobre todas las claves foráneas (esencial para JOINs rápidos)
CREATE INDEX idx_clientes_ciudad ON clientes (id_ciudad);
CREATE INDEX idx_productos_categoria ON productos (id_categoria);
CREATE INDEX idx_pedidos_cliente ON pedidos (id_cliente);
CREATE INDEX idx_detalle_pedido ON detalle_pedido (id_pedido);
CREATE INDEX idx_detalle_producto ON detalle_pedido (id_producto);
CREATE INDEX idx_pagos_pedido ON pagos (id_pedido);
-- Índices sobre columnas de búsqueda frecuente
CREATE INDEX idx_pedidos_fecha ON pedidos (fecha);
CREATE INDEX idx_pedidos_estado ON pedidos (estado);
CREATE INDEX idx_productos_activo ON productos (activo);
CREATE UNIQUE INDEX idx_clientes_email ON clientes (email);El orden de creación importa: siempre crear primero las tablas referenciadas (sin FK) y después las que las referencian. En nuestro caso: ciudades y categorías primero, luego clientes y productos, después pedidos, y finalmente detalle_pedido y pagos.
Resumen del Nivel 4
Con este nivel completaste el ciclo completo del diseño de bases de datos: desde entender por qué el diseño importa, hasta diseñar y construir un esquema profesional desde cero.
| Concepto | Que resuelve | Herramienta |
| Anomalía de UPDATE | Actualizar un dato en múltiples filas | Normalización: separar entidades |
| Anomalía de INSERT | No poder insertar sin datos de otra entidad | Normalización: separar entidades |
| Anomalía de DELETE | Perder datos al borrar otro dato | Normalización: separar entidades |
| Dependencia funcional | Razonar formalmente sobre el diseño | X -> Y: X determina Y |
| 1FN | Valores no atómicos y grupos repetidos | Tablas separadas para múltiples valores |
| 2FN | Dep. parciales en PK compuesta | Separar en tablas por cada dependencia |
| 3FN | Dep. transitivas entre no clave | Separar la entidad transitiva |
| Entidad (ERD) | Objeto del mundo real a modelar | Rectángulo en el diagrama |
| Relación 1:N | Un registro de A tiene muchos de B | FK en el lado N |
| Relación N:M | Muchos de A con muchos de B | Tabla intermedia con dos FK |
| Orden de creación | Respetar dependencias entre tablas | Primero tablas sin FK, luego las que las referencian |
El siguiente nivel (Nivel 5) cubre Administración: backup y recovery, gestión de usuarios y permisos, monitoreo del servidor, y las tareas del DBA en el día a día.
Fin del Nivel 4 - Siguiente: Nivel 5 - Administración y Seguridad
Bibliografia y Referencias
Este manual de bases de datos fue elaborado tomando como referencia principal los textos académicos más reconocidos del área, complementados con documentación técnica oficial de los principales motores de bases de datos. A continuación, se listan las fuentes utilizadas.
Libros de referencia principal
-
Silberschatz, A., Korth, H. F., y Sudarshan, S. (2006). Fundamentos de Bases de Datos (4a edición). McGraw-Hill / Interamericana de España. ISBN: 84-481-4644-1. [Capítulos utilizados: 2 (Modelo E-R), 3 (SQL), 4 (SQL Avanzado), 7 (Diseño de BD Relacionales), 13 (Procesamiento de Consultas), 14 (Optimización), 15 (Transacciones), 16 (Control de Concurrencia)]
-
Silberschatz, A., Korth, H. F., y Sudarshan, S. (2011). Database System Concepts (6th edition). McGraw-Hill. ISBN: 978-0-07-352332-3. [Referencia principal para ACID, integridad, índices B-Tree, procesamiento y optimización de consultas]
-
Kimball, R., y Ross, M. (2013). The Data Warehouse Toolkit: The Definitive Guide to Dimensional Modeling (3rd edition). Wiley. ISBN: 978-1-118-53080-1. [Referencia para modelado dimensional y arquitectura de data warehouses]
-
Bernstein, P. A., y Newcomer, E. (2009). Principles of Transaction Processing (2nd edition). Morgan Kaufmann. ISBN: 978-1-55860-623-4. [Referencia para transacciones, ACID, aislamiento y control de concurrencia]
-
Date, C. J. (2004). An Introduction to Database Systems (8th edition). Addison-Wesley. ISBN: 978-0-321-19784-9. [Referencia para algebra relacional, normalización y teoría del modelo relacional]
Documentacion técnica oficial
-
Oracle Corporation. (2023). MySQL 8.0 Reference Manual. Recuperado de https://dev.mysql.com/doc/refman/8.0/en/
-
The PostgreSQL Global Development Group. (2023). PostgreSQL 16 Documentation. Recuperado de https://www.postgresql.org/docs/16/
-
Microsoft Corporation. (2023). Transact-SQL Reference (SQL Server). Recuperado de https://learn.microsoft.com/en-us/sql/t-sql/
-
Teradata Corporation. (2023). Teradata Database SQL Fundamentals. Recuperado de https://docs.teradata.com/
-
ISO/IEC 9075:2023. Information technology - Database languages - SQL. International Organization for Standardization.
Recursos académicos complementarios
-
Codd, E. F. (1970). A relational model of data for large shared data banks. Communications of the ACM, 13(6), 377-387. doi:10.1145/362384.362685 [Articulo fundacional del modelo relacional]
-
Chen, P. P. (1976). The entity-relationship model: Toward a unified view of data. ACM Transactions on Database Systems, 1(1), 9-36. doi:10.1145/320434.320440 [Articulo original que propuso el Modelo Entidad-Relacion]
-
Gray, J., y Reuter, A. (1992). Transaction Processing: Concepts and Techniques. Morgan Kaufmann. ISBN: 978-1-55860-190-1. [Referencia para el acronimo ACID y los fundamentos de procesamiento de transacciones]
Nota sobre el uso de referencias
Los conceptos teóricos presentados en este manual fueron adaptados y simplificados para un público principiante e intermedio, manteniendo la precisión académica de las fuentes originales. Las definiciones formales, los algoritmos y los ejemplos fueron reelaborados con fines didácticos, citando en cada capítulo las fuentes especificas utilizadas. Se recomienda consultar las obras originales para profundizar en los fundamentos matemáticos y teóricos de cada tema.
Archivos de práctica
Los scripts y recursos de este manual, para descargar y practicar en tu propio entorno.