Bases de Datos & SQL
Modelo relacional, transacciones y consultas desde cero.
Serie Técnica · Ingeniería de Datos
JAVIESCA es una consultora de datos. Esta es nuestra biblioteca técnica: manuales propios sobre bases de datos, Big Data, ETL y BI — abiertos para leer, aprender y consultar.
9 manuales · 1 serie · 0 humo
En qué trabajamos
Cada manual nace de trabajo real en producción, sobre un stack on-premise de telecomunicaciones.
Modelo relacional, transacciones y consultas desde cero.
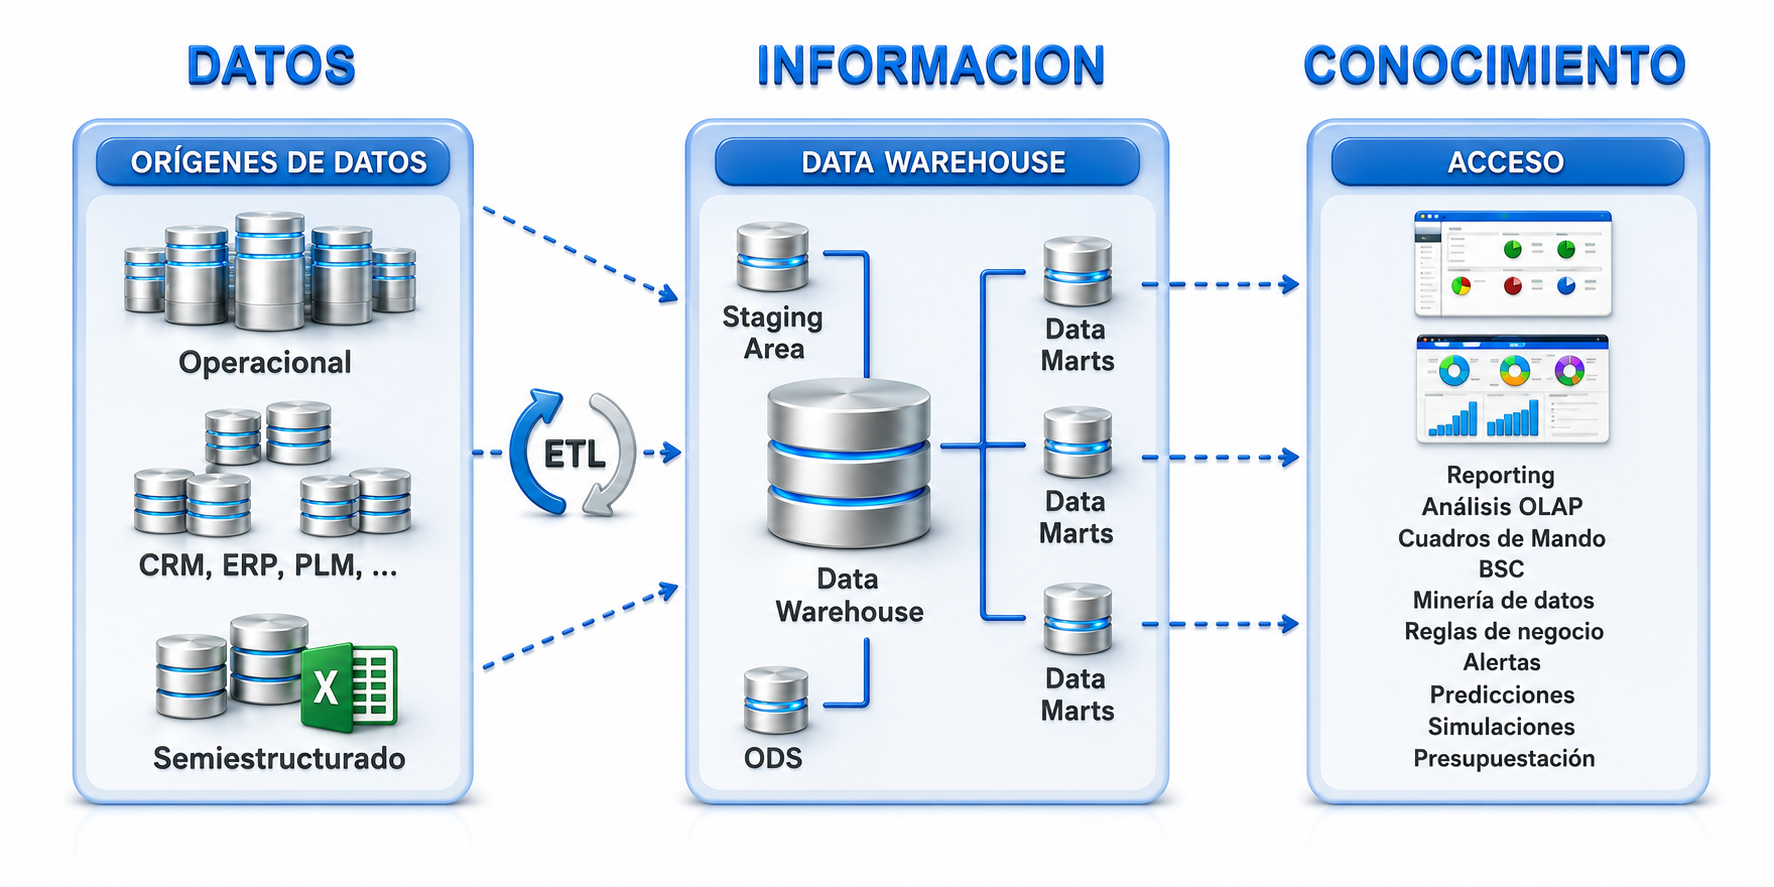
Kimball, Inmon, esquemas estrella y SCD tipo 2.
Ecosistema distribuido, HDFS y Hive.
KPIs, OLAP, tableros y análisis de negocio.
Automatización de procesos con Control-M.
Pipelines de datos con DataStage y Teradata.
Los programas y utilidades que uso todos los días para escribir consultas, leer logs, comparar versiones y documentar. Todo gratuito, todo probado en trabajo real.
Ver las herramientas →De la biblioteca
Fundamentos en cuatro niveles: del modelo relacional a las transacciones. La base sobre la que se apoya todo lo demás.
Consultas desde cero con el esquema TechStore, en cuatro partes y con PostgreSQL para practicar.
Trece capítulos con carga masiva (FastLoad / MultiLoad), veinticinco consultas analíticas y un dataset realista.
Sobre JAVIESCA
JAVIESCA es la consultora de datos de Javier Escalante, analista programador especializado en data warehousing. Desde 2016 trabajo en el DWH de una de las operadoras de telecomunicaciones más grandes del país: análisis de incidentes, resolución de cancelaciones de procesos, desarrollo de ETL y explotación de datos sobre un stack on-premise que mueve volúmenes reales, todos los días.
El trabajo diario pasa por Teradata y Oracle, pipelines en DataStage, orquestación en Control-M, consultas sobre Hive y HDFS, tableros en MicroStrategy y scripts en shell sobre Linux. Extraer, normalizar, verificar, transformar y cargar —con FastLoad y MultiLoad cuando el volumen aprieta—, y sobre todo entender por qué un proceso falló a las tres de la mañana.
Pero hay una tarea que, con los años, se volvió la más importante: documentar y capacitar. Escribir lo que el equipo necesita saber, explicarlo bien, dejarlo por escrito para el que venga después. Esta serie de manuales nace de ahí: es ese mismo hábito, abierto al público. Nada de teoría copiada — cada manual sale de haber resuelto el problema en producción, con ejemplos concretos, código que corre y bibliografía chequeada.
Licenciado en Gestión de Información, con formación en data warehousing en la UTN.