Sobre este manual
Este manual cierra la serie técnica de JAVIESCA con el tema que sirve de paraguas a casi todos los anteriores. Big Data no es una tecnología concreta sino un conjunto de problemas -escala, velocidad y heterogeneidad de los datos- y de respuestas arquitectónicas y tecnológicas que surgieron para resolverlos. Entender ese marco permite ubicar en su lugar a Hadoop, al Data warehouse, al mundo BI y a las herramientas de integración que se documentaron en los manuales previos.
El enfoque es deliberadamente conceptual y panorámico: el objetivo es que el lector pueda razonar sobre por qué existen estas tecnologías, cuando conviene cada una y como se ensamblan, sin convertirse en un tutorial profundo de ninguna en particular. Cuando un tema ya fue tratado en detalle en otro manual de la serie, se lo referencia en lugar de repetirlo.
Los capítulos 1 a 3 construyen el marco conceptual (que es Big Data, porque los sistemas distribuidos se comportan como lo hacen, y la diferencia entre procesamiento batch y streaming). Los capítulos 4 y 5 recorren el panorama de almacenamiento y de motores de procesamiento. El capítulo 6 muestra cómo se ensamblan las piezas en arquitecturas concretas. El capítulo 7 aterriza todo en la práctica: gobierno, calidad, seguridad y la relación con el stack real on-premise.
Convenciones tipográficas: los bloques de código y comandos se muestran sobre fondo oscuro con los comentarios en verde. Los términos técnicos clave se resaltan en la primera aparición. Las cajas con barra lateral azul contienen notas y referencias cruzadas a otros manuales de la serie.
1. Que es Big Data
El termino Big Data se popularizo a partir de la década de 2000 para nombrar una situación que muchas organizaciones empezaron a compartir: los volúmenes, la velocidad y la variedad de los datos que necesitaban gestionar superaban lo que un único servidor con una base de datos relacional clásica podía manejar de forma razonable. No se trata de una tecnología, sino de una categoría de problemas y del conjunto de respuestas que la industria fue construyendo para enfrentarlos.
Dicho de otro modo, el big data está formado por conjuntos de datos de mayor tamaño y más complejos, especialmente procedentes de nuevas fuentes de datos. Estos conjuntos de datos son tan voluminosos que el software de procesamiento de datos convencional sencillamente no puede gestionarlos. Sin embargo, estos volúmenes masivos de datos pueden utilizarse para abordar problemas empresariales que antes no hubiera sido posible solucionar.
1.1 Un poco de contexto histórico
Durante décadas, el modelo dominante para almacenar y consultar datos fue el sistema de gestión de bases de datos relacionales (RDBMS): tablas normalizadas, transacciones ACID y un único servidor -o un servidor primario con replicas- como unidad de computo. Ese modelo sigue siendo excelente para una enorme cantidad de casos, y de hecho es el corazón de los entornos transaccionales y de gran parte del Data warehouse tradicional.
Lo que cambio fue la escala. La expansión de la web, los dispositivos móviles, los sensores, los registros de red de las telecomunicaciones (por ejemplo, los CDR: Call Detail Records) y luego el IoT generaron flujos de datos que crecían más rápido que la capacidad de un solo servidor. Escalar verticalmente -comprar una maquina más grande- dejo de alcanzar, tanto por limites físicos como por costo. La alternativa fue escalar horizontalmente: repartir los datos y el computo entre muchas maquinas modestas trabajando en paralelo. Esa decisión aparentemente simple es la que dispara casi toda la complejidad que este manual describe.
Los pioneros de este enfoque fueron empresas que enfrentaron el problema antes que el resto. Google publico artículos fundacionales sobre su sistema de archivos distribuido y sobre MapReduce; Amazon describió Dynamo, su almacén clave-valor distribuido. La comunidad de código abierto respondió con Hadoop, HBase, Cassandra y muchos otros. De ese linaje proviene buena parte del ecosistema actual.
1.2 Las V del Big Data
La forma más difundida de caracterizar un problema de Big Data es a través de sus dimensiones o V. El origen del modelo es concreto y verificable: en 2001, Doug Laney, entonces analista de META Group, publico una nota técnica titulada 3D Data Management en la que identificaba tres dimensiones que tensionaban la gestión de datos: volumen, velocidad y variedad. Con el tiempo la literatura y la industria agregaron otras dos V que hoy se citan de forma casi universal: veracidad y valor.
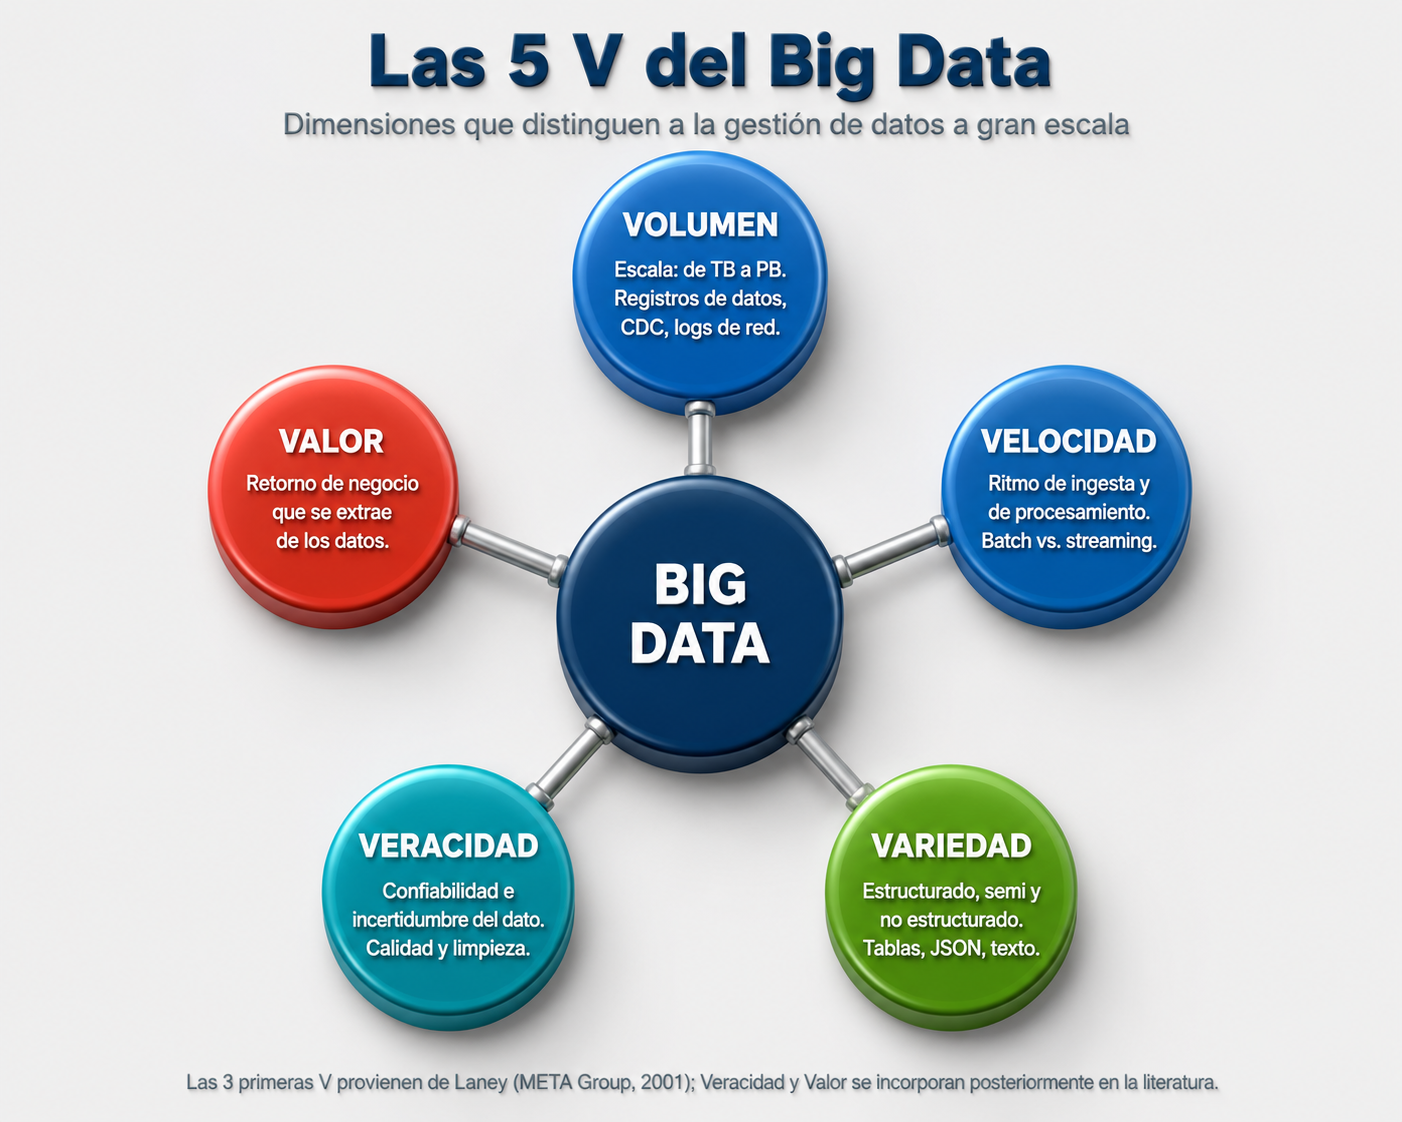
Figura 1.1 Las 5 V del Big Data. Las tres primeras provienen de Laney (2001); veracidad y valor se incorporan despues.
Volumen
Es la dimensión más evidente: la cantidad de datos. Se habla de terabytes, petabytes y más. En un contexto de telecomunicaciones, el volumen aparece de forma natural en los registros de tráfico, los CDR, los logs de los elementos de red o los eventos de facturación. El punto no es un número mágico a partir del cual algo es Big Data, sino el momento en que el volumen obliga a repartir el almacenamiento y el procesamiento entre varias máquinas.
Velocidad
Se refiere al ritmo al que los datos llegan y a la rapidez con que deben procesarse. Un cierre de facturación mensual tolera horas de computo batch; la detección de fraude o el monitoreo de una red en tiempo real exigen respuestas en segundos. Esta dimensión es la que separa el mundo batch del mundo streaming, tema del capítulo 3.
Variedad
Alude a la heterogeneidad de los datos. Además de las tablas estructuradas del RDBMS, aparecen datos semiestructurados (JSON, XML, logs) y no estructurados (texto libre, imágenes, audio). El modelo relacional rígido no siempre es la mejor forma de almacenar todo esto, y de ahí surge buena parte del ecosistema NoSQL que se ve en el capítulo 4.
Veracidad
Es la dimensión de la confianza: que tan fiable, completo y limpio es el dato. A mayor escala y variedad, mayor la probabilidad de inconsistencias, duplicados, valores faltantes o errores de captura. La veracidad conecta directamente con la calidad de datos, un tema que cualquier profesional de Data warehouse y BI conoce bien, y que se retoma en el capítulo 7.
Valor
Es la V que da sentido a todas las demás. Almacenar y procesar datos a gran escala solo se justifica si de ahí se extrae valor de negocio: mejores decisiones, nuevos productos, eficiencias operativas. Sin un caso de uso claro, un proyecto de Big Data es solo un costo de infraestructura. Por eso conviene empezar por el valor y no por la tecnología.
Conviene una advertencia honesta: el término “Big Data” esta tan sobre utilizado que en una discusión de ingeniería seria suele ser más útil hablar de términos menos ambiguos, como sistemas de un solo nodo frente a distribuidos, o procesamiento interactivo frente a batch. Esta es, de hecho, la postura de Martin Kleppmann en Designing Data-Intensive Applications. Las V son un buen mapa mental de entrada, pero no un criterio técnico preciso.
1.3 Por que el modelo relacional clásico no siempre alcanza
No se trata de que el modelo relacional sea inferior, sino de que fue diseñado bajo supuestos que la escala masiva rompe. Un RDBMS clásico asume, típicamente, que los datos caben y se procesan de forma eficiente en un único nodo (o un pequeño clúster con almacenamiento compartido), que las transacciones ACID son deseables en todos los casos, y que el esquema está bien definido de antemano.
Cuando se reparte una base entre decenas o cientos de máquinas, esos supuestos entran en tensión. Mantener consistencia fuerte y transacciones ACID a través de muchos nodos conectados por una red poco fiable tiene un costo alto en disponibilidad y latencia; ese es exactamente el terreno del teorema CAP que se estudia en el capítulo 2. Además, imponer un esquema rígido a datos muy variados y cambiantes puede ser una desventaja más que una ayuda.
La respuesta del ecosistema Big Data no fue reemplazar al modelo relacional, sino complementarlo con nuevas herramientas: sistemas de archivos distribuidos, motores de procesamiento paralelo, bases NoSQL de distintas familias y arquitecturas pensadas para clúster de hardware común. El resto del manual recorre ese panorama.
1.4 Big Data como paraguas de la serie
Vale la pena situar este manual respecto de los anteriores. El Data warehouse resuelve el problema de integrar y modelar datos para análisis; el modelado dimensional le da forma; Hadoop provee una plataforma concreta de almacenamiento y procesamiento distribuido; el mundo BI convierte esos datos en tableros y reportes; las herramientas de integración (por ejemplo, DataStage) mueven los datos entre sistemas. Big Data es el marco conceptual que explica por qué todas esas piezas existen y como se relacionan cuando la escala aprieta.
Los conceptos de Data warehouse, esquema estrella y arquitecturas Kimball/Inmon/Data Vault/Lakehouse se desarrollan en detalle en los manuales Data Warehouse y Modelado Dimensional de esta misma serie. El presente manual los referencia y se apoya en ellos, sin repetir su contenido.
2. Fundamentos de sistemas distribuidos
Casi todo lo que hace particular al Big Data se deriva de una única decisión: repartir datos y computo entre muchas maquinas. Este capítulo cubre los fundamentos que explican por qué los sistemas distribuidos se comportan como lo hacen. No es teoría abstracta: cada concepto de aquí aparece luego, de forma concreta, en el comportamiento de Hadoop, Cassandra, Kafka o Spark.
2.1 Escalabilidad: vertical frente a horizontal
Escalar verticalmente (scale up) significa hacer más potente una única maquina: más CPU, más RAM, discos más rápidos. Es simple de operar porque el sistema sigue siendo un solo nodo, pero tiene un techo físico y un costo que crece de forma no lineal: duplicar la potencia de un servidor de gama alta cuesta mucho más que el doble.
Escalar horizontalmente (scale out) significa agregar más maquinas modestas que trabajan en conjunto. No tiene el mismo techo -se pueden sumar nodos casi indefinidamente- y usa hardware común, más barato. El precio a pagar es la complejidad: ahora hay que repartir los datos, coordinar el trabajo, tolerar fallos de nodos individuales y lidiar con una red que introduce latencia y puede fallar. El Big Data es, en gran medida, el arte de gestionar esa complejidad.
En un cluster grande de hardware comun, que una maquina falle no es la excepcion sino la norma estadistica. Con cientos o miles de nodos, siempre hay alguno caido o degradado. Por eso los sistemas distribuidos de Big Data se disenan asumiendo el fallo como estado normal, no como emergencia.
2.2 Particionamiento y replicación
Dos técnicas básicas sostienen a casi todos los sistemas distribuidos de datos: el particionamiento y la replicación. Conviene entenderlas por separado porque resuelven problemas distintos.
Particionamiento (sharding)
Particionar (o hacer sharding) es repartir un conjunto de datos entre varios nodos, de modo que cada nodo guarde solo un subconjunto. Así, ni el volumen total ni la carga de escritura recaen sobre una sola máquina. La clave de particionamiento determina en que nodo vive cada dato; una buena clave reparte la carga de forma pareja, mientras que una mala genera nodos calientes (hotspots) que concentran el trabajo.
Replicación
Replicar es mantener varias copias del mismo dato en nodos distintos. Sirve para dos cosas: tolerancia a fallos (si un nodo cae, otra copia responde) y rendimiento de lectura (varias copias pueden atender consultas en paralelo). El costo es la coordinación: cuando el dato cambia, hay que propagar la actualización a todas las copias, y ahí aparece el problema de la consistencia.
La mayoría de los sistemas combinan ambas: particionan para repartir el volumen y replican cada partición para tolerar fallos. Es exactamente lo que hace HDFS con sus bloques y su factor de replicación, o Cassandra con sus rangos de tokens y su factor de replicación.
El mecanismo concreto de particionamiento en bloques y replicación de HDFS se explica en el manual Hadoop de esta serie (Niveles 1-2). Aquí se presentan los principios generales que ese mecanismo implementa.
2.3 El teorema CAP
El teorema CAP es probablemente el resultado teórico mas citado -y más malinterpretado- del mundo de los datos distribuidos. Su origen es preciso: Eric Brewer lo planteo como conjetura en una charla invitada en el simposio PODC de 2000, y Seth Gilbert y Nancy Lynch lo formalizaron y demostraron en 2002 en un artículo de ACM SIGACT News.
El teorema considera tres propiedades deseables de un sistema de datos distribuido:
-
Consistencia (C): toda lectura recibe la escritura más reciente o un error. Todos los nodos ven el mismo dato al mismo tiempo.
-
Disponibilidad (A): toda petición recibe una respuesta (no un error), aunque no sea necesariamente la más reciente.
-
Tolerancia a particiones (P): el sistema sigue funcionando, aunque la red se parta y algunos nodos no puedan comunicarse entre sí.
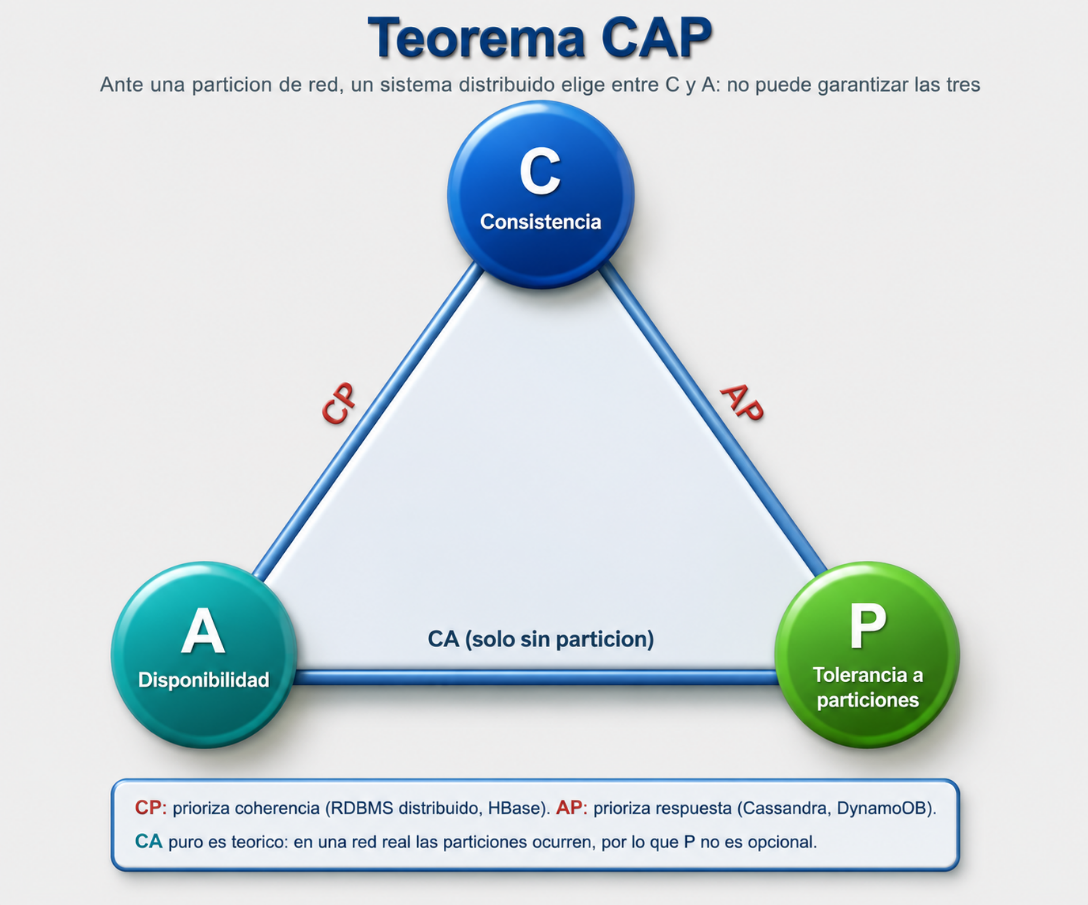
Figura 2.1 El teorema CAP. Ante una particion de red, hay que elegir entre consistencia y disponibilidad.
El enunciado correcto del teorema no es “elegí dos de tres” como suele simplificarse, sino algo más sutil: cuando ocurre una partición de red (P), el sistema debe elegir entre mantener la consistencia (C) o mantener la disponibilidad (A). No puede garantizar ambas simultáneamente mientras la partición persiste. Como en una red real las particiones son inevitables, P no es realmente opcional: la elección practica es entre sistemas CP y sistemas AP.
Sistemas CP y AP en la practica
Un sistema CP prioriza la consistencia: ante una partición, prefiere rechazar operaciones antes que devolver datos posiblemente desactualizados. HBase se ubica de este lado. Un sistema AP prioriza la disponibilidad: sigue respondiendo aun a riesgo de servir datos temporalmente inconsistentes, y reconcilia después. Cassandra y DynamoDB son ejemplos clásicos de este enfoque.
El caso CA puro -consistencia y disponibilidad sin tolerar particiones- solo tiene sentido en un sistema de un solo nodo o sin red de por medio, y por eso en la práctica se lo considera teórico dentro del contexto distribuido.
2.4 Consistencia eventual
De la elección AP surge un concepto central: la consistencia eventual. Un sistema es eventualmente consistente si, en ausencia de nuevas escrituras, todas las copias de un dato convergen con el tiempo al mismo valor. Es decir, puede haber una ventana de tiempo en que distintas replicas muestren valores distintos, pero el sistema garantiza que esa divergencia se resuelve.
Este modelo es más débil que la consistencia fuerte, pero a cambio ofrece mayor disponibilidad y menor latencia, lo que en muchos casos de uso es un intercambio aceptable. Un carrito de compras que tarda un segundo en reflejar un cambio en todas las réplicas rara vez es un problema; un saldo bancario, en cambio, suele exigir consistencia fuerte. La elección depende del caso de negocio, no de una preferencia técnica abstracta.
El propio teorema CAP ha sido matizado por la literatura posterior. Kleppmann, en su artículo “A critique of the CAP theorem” (2015) y en Designing Data-Intensive Applications, señala que las definiciones de C, A y P son más estrechas de lo que su uso coloquial sugiere, y que conviene razonar en términos de modelos de consistencia concretos (linealizabilidad, causalidad) en lugar de las tres letras. Es un buen recordatorio de que CAP es un punto de partida, no la última palabra.
2.5 Tolerancia a fallos
Si el fallo de nodos es la norma, el sistema debe tolerarlo sin intervención manual. Las estrategias típicas son la replicación (ya vista), la detección de fallos mediante heartbeats (señales periódicas que un nodo emite para indicar que sigue vivo) y la recuperación automática (cuando un nodo cae, sus particiones se reasignan o se reconstruyen a partir de las réplicas).
Un mecanismo particularmente elegante es el linaje (lineage) que usa Spark: en lugar de replicar los datos intermedios, el sistema recuerda la secuencia de transformaciones que los produjo, de modo que si se pierde una partición puede recomputarla a partir de sus entradas. Es una forma de tolerancia a fallos por recomputo en vez de por copia, y se retoma en el capítulo 5.
3. Procesamiento batch y streaming
Una de las distinciones más importantes en Big Data es como se procesan los datos en el tiempo: en lotes acumulados (batch) o a medida que llegan (streaming). Esta diferencia atraviesa la elección de tecnologías y da forma a las arquitecturas del capítulo 6, así que conviene entenderla a fondo.
3.1 Procesamiento batch
El procesamiento por lotes consiste en acumular un volumen de datos durante un periodo y procesarlo todo junto en una corrida. Es el modelo más antiguo y sigue siendo el más común para cargas analíticas: los procesos ETL nocturnos, los cierres de facturación, la construcción de tablas agregadas del Data warehouse. MapReduce, que se ve en el capítulo 5, es el paradigma batch por excelencia.
Sus ventajas son la eficiencia y la simplicidad conceptual: al procesar grandes bloques de datos de una vez, se aprovecha bien el hardware y se maximiza el throughput (cantidad de datos procesados por unidad de tiempo). Su desventaja es la latencia: el resultado no está disponible hasta que la corrida termina, lo que puede significar minutos u horas de demora entre que un dato llega y que se refleja en un reporte.
En el día a día de un entorno de Data warehouse, el batch es el pan de cada día: una cadena de jobs orquestada por una herramienta como Control-M ejecuta cada noche las extracciones, transformaciones y cargas, y los tableros de la mañana reflejan el estado del negocio hasta el cierre anterior. Para la mayoría de los reportes de gestión, esa latencia es perfectamente aceptable.
3.2 Procesamiento streaming
El procesamiento de flujo (streaming) procesa cada dato -o pequeños micro-lotes- a medida que llega, con latencias de segundos o menos. En lugar de esperar a acumular un lote, el sistema mantiene un flujo continuo de eventos y aplica la lógica sobre ellos casi en tiempo real. Es el modelo adecuado para detección de fraude, monitoreo de red, alertas operativas o cualquier caso donde el valor del dato decae rápidamente con el tiempo.
El costo del streaming es la complejidad: procesar datos ilimitados y continuos plantea problemas que el batch no tiene, como que hacer con eventos que llegan tarde o desordenados, como definir sobre que porción del flujo se calcula una agregación, y como garantizar que cada evento se procese exactamente una vez. Estas preguntas se abordan con los conceptos de ventanas temporales y semántica de entrega.
3.3 Latencia frente a throughput
Es útil no confundir dos métricas que a veces se contraponen. La latencia es el tiempo que tarda un dato individual en ser procesado desde que llega. El throughput es la cantidad total de datos que el sistema procesa por unidad de tiempo. El batch tiende a optimizar el throughput a costa de la latencia; el streaming, a minimizar la latencia manteniendo un throughput razonable.
No hay un ganador absoluto. La pregunta correcta no es “que es mejor”, sino “que exige el caso de uso”. Un reporte financiero mensual no gana nada con latencia de segundos; un sistema antifraude no sirve si tarda horas. Muchas organizaciones necesitan ambos, y de ahí surgen las arquitecturas hibridas del capítulo 6.
3.4 Ventanas temporales
Cuando se procesa un flujo continuo, muchas operaciones -contar, promediar, agregar- necesitan delimitar sobre que porción del flujo se calculan. Esa delimitación se llama ventana. Las más comunes son:
-
Ventanas fijas (tumbling): intervalos consecutivos que no se solapan, por ejemplo “cantidad de eventos cada 5 minutos”.
-
Ventanas deslizantes (sliding): intervalos que se solapan, por ejemplo “promedio de los últimos 5 minutos, actualizado cada minuto”.
-
Ventanas de sesión: se definen por periodos de actividad separados por pausas, útiles para agrupar la actividad de un usuario.
Un problema fino del streaming es la diferencia entre el tiempo del evento (cuando ocurrió realmente) y el tiempo de procesamiento (cuando el sistema lo ve). Un evento generado a las 10:00 puede llegar al sistema a las 10:03 por demoras de red. Decidir si ese evento entra en la ventana de las 10:00 o se descarta es una decisión de diseño con consecuencias reales en la exactitud de los resultados.
3.5 Semántica de entrega
En un sistema distribuido con fallos, garantizar que cada evento se procese la cantidad correcta de veces no es trivial. Se distinguen tres niveles de garantía:
-
A lo sumo una vez (at-most-once): cada evento se procesa una vez o ninguna; puede haber perdidas, pero no duplicados. Simple pero arriesgado.
-
Al menos una vez (at-least-once): ningún evento se pierde, pero alguno puede procesarse más de una vez ante un reintento. Exige que la lógica sea idempotente para no contar doble.
-
Exactamente una vez (exactly-once): cada evento afecta el resultado una sola vez, ni más ni menos. Es la garantía más fuerte y la más costosa de implementar; los motores modernos de streaming la ofrecen bajo ciertas condiciones.
Una operación es idempotente si aplicarla varias veces produce el mismo resultado que aplicarla una vez. Diseñar procesos idempotentes es una de las mejores defensas contra los duplicados en sistemas distribuidos, tanto en streaming como en batch. Por ejemplo, un UPSERT por clave es idempotente; un INSERT ciego o un incremento de contador, no.
4. Almacenamiento a gran escala
Antes de procesar los datos hay que guardarlos, y a gran escala eso plantea sus propias decisiones. Este capítulo recorre el panorama de opciones de almacenamiento analítico: la diferencia entre data lake, data warehouse y lakehouse; las familias de bases NoSQL y cuando conviene cada una; y el rol de los sistemas de archivos distribuidos como capa de base.
4.1 Data Lake, Data Warehouse y Lakehouse
Estos tres términos nombran enfoques distintos para almacenar datos con fines analíticos. No son sinónimos ni etapas de una evolución lineal: coexisten y resuelven necesidades diferentes.
Data Warehouse
El data warehouse es un repositorio de datos estructurados, integrados y modelados específicamente para el análisis. Los datos se limpian, se transforman y se cargan siguiendo un esquema definido de antemano (schema-on-write): se decide la estructura antes de escribir. Esto da consultas rápidas y confiables, gobierno sólido y una “única versión de la verdad”, a costa de rigidez: incorporar una fuente nueva exige rediseño.
El diseño del data warehouse -arquitecturas Kimball, Inmon y Data Vault, esquema estrella, dimensiones y hechos, SCD- se desarrolla por completo en los manuales Data Warehouse y Modelado Dimensional. Aquí solo se lo ubica dentro del panorama mayor de almacenamiento.
Data Lake
El data lake invierte el enfoque: almacena los datos en su formato crudo -estructurados, semiestructurados o no estructurados- sin imponer un esquema al escribir. La estructura se aplica al leer (schema-on-read), cuando se sabe que pregunta se quiere responder. Esto da máxima flexibilidad y bajo costo de almacenamiento, ideal para datos cuyo uso futuro aún no está claro. El riesgo es degenerar en un “pantano de datos” (data swamp): sin gobierno ni catálogo, un lago se vuelve un deposito inutilizable donde nadie sabe qué hay ni si es confiable.
Lakehouse
El lakehouse es un enfoque más reciente que busca combinar lo mejor de ambos mundos: el bajo costo y la flexibilidad del data lake con las garantías de gestión del data warehouse (transacciones, esquema, calidad). Se apoya en formatos de tabla abiertos que añaden una capa transaccional sobre los archivos del lago. El termino y su fundamentación técnica provienen del artículo de Armbrust y colegas presentado en CIDR 2021, que lo define como una nueva generación de plataformas abiertas que unifican el data warehousing y la analítica avanzada.
El concepto de lakehouse tambien se aborda, junto con las demás arquitecturas, en el manual Data Warehouse de la serie.
4.2 Sistemas de archivos distribuidos
Debajo de gran parte del almacenamiento analítico hay un sistema de archivos distribuido: una capa que reparte archivos grandes en bloques distribuidos y replicados entre muchos nodos, presentando la ilusión de un único sistema de archivos. El pionero conceptual fue el Google File System (GFS), descrito por Ghemawat, Gobioff y Leung en 2003; su equivalente de código abierto es HDFS, el sistema de archivos de Hadoop.
La idea central es sencilla: un archivo grande se divide en bloques de tamaño fijo, cada bloque se replica en varios nodos (típicamente tres) y un nodo maestro lleva el registro de donde vive cada bloque. Esto da tolerancia a fallos y permite que el computo se acerque a los datos en lugar de mover terabytes por la red -el principio de localidad de datos-. En la nube, este rol lo cumplen hoy los almacenes de objetos, que ofrecen una semántica parecida a escala prácticamente ilimitada.
El funcionamiento interno de HDFS -NameNode, DataNodes, bloques y replicación- se explica en detalle en el manual Hadoop (Niveles 1-2). Este capítulo presenta el concepto general del que HDFS es una implementación.
4.3 NoSQL: familias y criterios de elección
NoSQL (leído como “not only SQL”) agrupa una variedad de bases de datos que se apartan del modelo relacional puro para ganar escalabilidad, flexibilidad de esquema o rendimiento en patrones de acceso específicos. No son un reemplazo del RDBMS, sino un complemento: cada familia optimiza un modelo de datos y un tipo de acceso distinto.
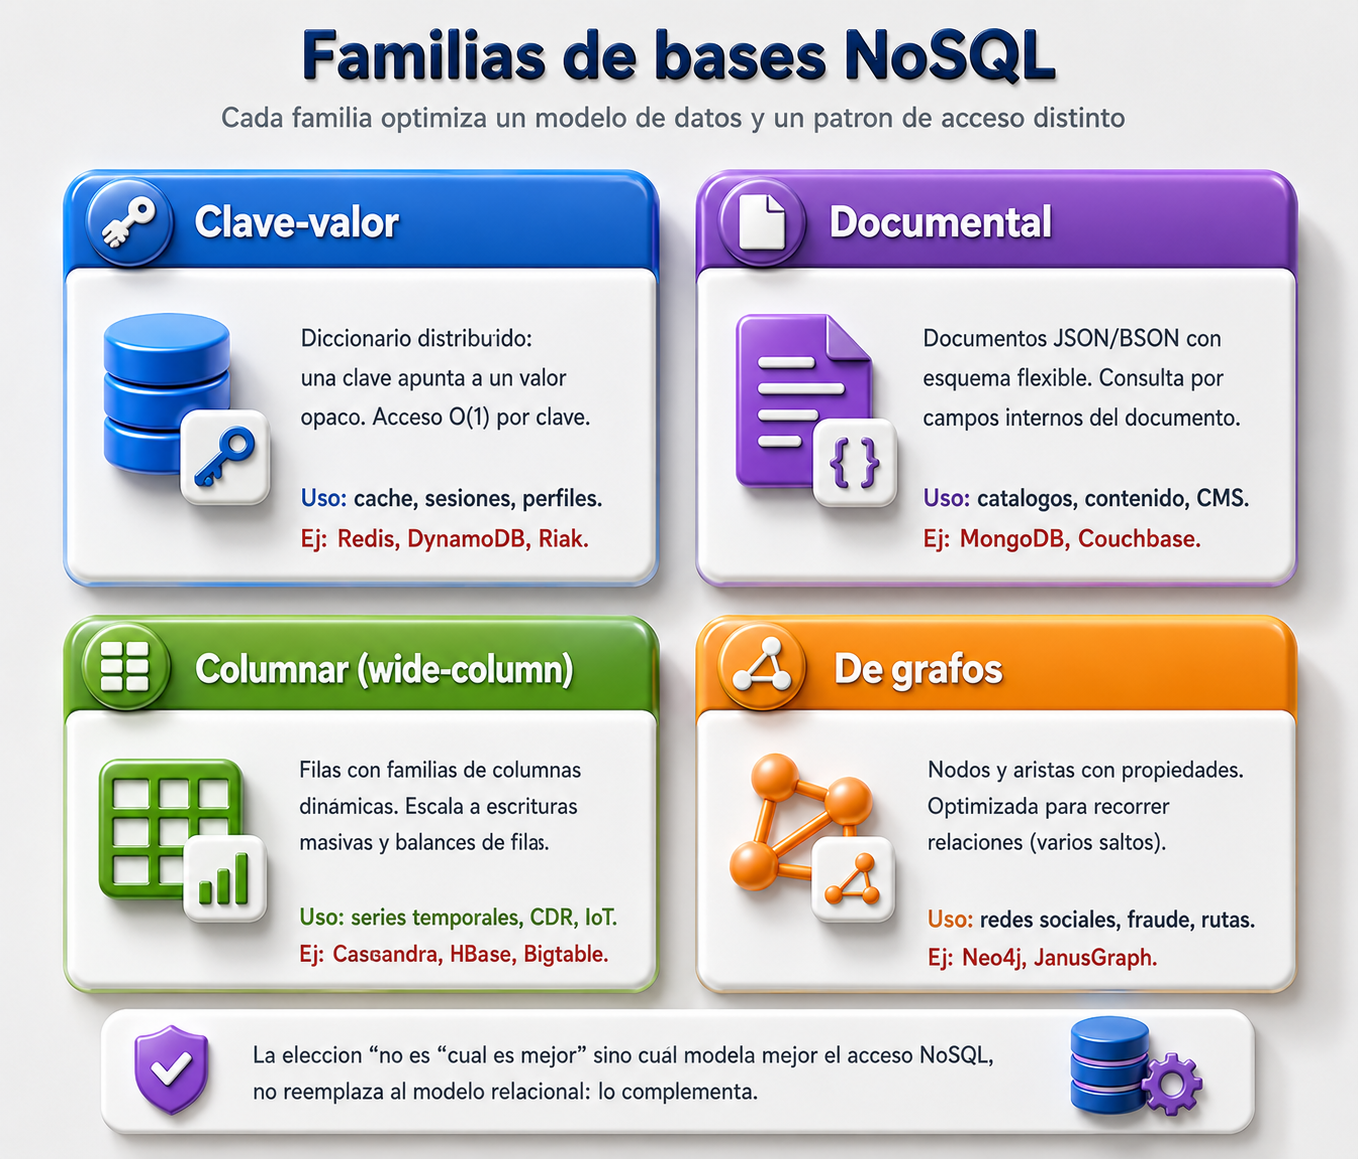
Figura 4.1 Las cuatro familias principales de bases NoSQL y sus casos de uso típicos.
Clave-valor
Es el modelo más simple: un diccionario distribuido donde cada clave apunta a un valor opaco. El acceso por clave es extremadamente rápido, pero no se puede consultar por el contenido del valor. Ideal para cache, sesiones de usuario o perfiles. Ejemplos: Redis, Amazon DynamoDB, Riak.
Documental
Almacena documentos -típicamente JSON o BSON- con esquema flexible, y permite consultar por los campos internos del documento. Cada documento puede tener una estructura distinta, lo que encaja bien con datos que evolucionan. Ideal para catálogos de productos, gestión de contenido o perfiles ricos. Ejemplos: MongoDB, Couchbase.
Columnar (wide-column)
Organiza los datos en filas que contienen familias de columnas dinámicas. Esta optimizada para escrituras masivas y para escalar a miles de millones de filas con particionamiento por clave. Ideal para series temporales, registros de tráfico, CDR o datos de IoT. Ejemplos: Apache Cassandra, HBase, y el Bigtable de Google que inspiro a ambos.
De grafos
Modela los datos como nodos y aristas con propiedades, y esta optimizada para recorrer relaciones a través de varios saltos -algo costoso en un RDBMS con muchos JOIN-. Ideal para redes sociales, detección de fraude, motores de recomendación o cálculo de rutas. Ejemplos: Neo4j, JanusGraph.
La pregunta al elegir una base NoSQL no es “cuál es la mejor”, sino “cual modela mejor mi patrón de acceso”. Si el acceso es siempre por clave, una clave-valor sobra; si el negocio son las relaciones, una de grafos ahorra un mundo de JOIN. Elegir la familia equivocada convierte una fortaleza en un lastre. Y en muchos sistemas reales conviven varias, incluido el buen viejo RDBMS: es lo que se llama persistencia poliglota.
5. Procesamiento y motores
Guardados los datos, hay que procesarlos. Este capítulo recorre los paradigmas y motores de procesamiento distribuido, desde el MapReduce clásico hasta el procesamiento en memoria y el streaming. El enfoque es panorámico: se busca entender el modelo mental de cada motor y cuando conviene, no dar un tutorial de su API.
5.1 MapReduce: el paradigma fundacional
MapReduce es el modelo de programación que popularizo el procesamiento distribuido de datos a gran escala. Fue descrito por Jeffrey Dean y Sanjay Ghemawat en su artículo de 2004 en el simposio OSDI, y su implementación de código abierto es el corazón del Hadoop clásico. La idea es expresar un cómputo como dos funciones que el sistema paraleliza automáticamente:
-
Map: toma cada registro de entrada y emite pares clave-valor intermedios. Se ejecuta en paralelo sobre las particiones de datos, cerca de donde estos viven.
-
Reduce: recibe todos los valores intermedios agrupados por clave y los combina en el resultado final.
Entre ambas fases hay un paso de shuffle en el que el sistema agrupa y ordena los pares intermedios por clave, moviéndolos entre nodos. El programador solo escribe map y reduce; el motor se ocupa de particionar, planificar, mover datos, tolerar fallos y coordinar. El ejemplo canónico es el conteo de palabras:
MapReduce - modelo conceptual
# Pseudocodigo del modelo MapReduce: conteo de palabras
funcion map(clave_documento, texto):
para cada palabra en texto:
emitir(palabra, 1) # clave = palabra, valor = 1
funcion reduce(palabra, lista_de_unos):
total = suma(lista_de_unos) # el shuffle ya agrupo por palabra emitir(palabra, total)
La gran virtud de MapReduce fue democratizar el computo distribuido: permitió a programadores sin experiencia en sistemas paralelos aprovechar miles de máquinas escribiendo dos funciones simples. Su limitación es que, al escribir los resultados intermedios a disco entre etapas, resulta ineficiente para algoritmos iterativos -como muchos de machine learning- que recorren los datos muchas veces. Esa limitación es justamente la que motivo a Spark.
El ecosistema Hadoop -HDFS, YARN, el motor MapReduce, Hive y las herramientas asociadas- se cubre en profundidad en el manual Hadoop de la serie. Aqui MapReduce se presenta como paradigma general, no como componente especifico de Hadoop.
5.2 Procesamiento en memoria: Spark
Apache Spark surgio para superar la principal limitación de MapReduce. Su abstracción central es el RDD (Resilient Distributed Dataset), descrito por Matei Zaharia y colegas en su artículo de 2012 en NSDI. Un RDD es una colección de datos distribuida, inmutable y tolerante a fallos que puede mantenerse en memoria entre operaciones.
La diferencia practica es enorme: al conservar los datos intermedios en memoria en lugar de escribirlos a disco en cada paso, Spark ejecuta cargas iterativas y multi-etapa mucho más rápido que MapReduce -hasta un orden de magnitud o más en analítica de varias pasadas-. La tolerancia a fallos no se logra replicando esos datos en memoria, sino recordando el linaje (lineage): cada RDD sabe cómo fue construido a partir de otros mediante transformaciones (map, filter, join), de modo que una partición perdida se recomputa a partir de sus entradas.
Spark introdujo además una distinción útil entre transformaciones (operaciones perezosas que definen un nuevo RDD sin ejecutarse, como map o filter) y acciones (operaciones que disparan el cómputo y devuelven un resultado, como count o collect). El motor construye un grafo de transformaciones y solo lo ejecuta cuando aparece una acción, lo que le permite optimizar el plan completo.
Spark - transformaciones perezosas y una acción
# Spark: mismo conteo de palabras, estilo funcional (PySpark)
texto = sc.textFile("hdfs:///datos/corpus.txt")
conteo = (texto
.flatMap(lambda l: l.split()) # transformación (perezosa)
.map(lambda w: (w, 1)) # transformación (perezosa)
.reduceByKey(lambda a, b: a + b)) # transformación (perezosa)
conteo.saveAsTextFile("hdfs:///salida/") # acción: recién aquí se ejecuta
Con el tiempo, Spark evoluciono de los RDD de bajo nivel hacia abstracciones de más alto nivel -DataFrames y Spark SQL- que permiten expresar el procesamiento con una sintaxis parecida a SQL y habilitan optimizaciones automáticas. Hoy Spark es un motor unificado que cubre batch, SQL, streaming (Structured Streaming) y machine learning sobre la misma base.
5.3 Procesamiento de flujo: Kafka y los motores de streaming
El procesamiento en tiempo real se apoya en dos piezas complementarias que conviene no confundir: el transporte de eventos y el motor de cálculo.
El log de eventos: Apache Kafka
Apache Kafka es una plataforma de streaming que funciona como un log de eventos distribuido, persistente y particionado. Los productores publican eventos en tópicos y los consumidores los leen a su propio ritmo. La clave es que Kafka retiene los eventos de forma ordenada e inmutable: un consumidor puede volver a leer desde cualquier punto (offset) del histórico. Esto lo convierte no solo en un transporte, sino en una fuente de verdad reproducible, propiedad que resulta central para la arquitectura Kappa del capítulo 6.
Los motores de calculo
Sobre ese flujo operan los motores de streaming, que aplican la lógica de negocio evento a evento (o en micro-lotes) con las ventanas y la semántica de entrega del capítulo 3. Ejemplos son Apache Flink, orientado a streaming nativo con garantías fuertes, y Spark Structured Streaming, que integra el streaming al motor unificado de Spark. La elección entre ellos depende de los requisitos de latencia, del modelo de ventanas y de la integración con el resto del stack.
Kafka mueve y guarda los eventos; Flink o Spark los procesan. Es un error frecuente pensar que Kafka “procesa” datos: su rol es ser el sistema nervioso que transporta y retiene el flujo de forma ordenada y reproducible. El cálculo lo hace el motor de streaming que se conecta a él.
6. Arquitecturas de datos
Los capítulos anteriores presentaron piezas sueltas: almacenamiento, batch, streaming, motores. Este capítulo muestra cómo se ensamblan en arquitecturas concretas. Cada patrón responde a una tensión particular -sobre todo, la de combinar la exactitud del batch con la baja latencia del streaming- y trae sus propios costos.
6.1 Arquitectura Lambda
La arquitectura Lambda fue formulada por Nathan Marz y James Warren en su libro Big Data (Manning, 2015). Nace de una observación: muchos sistemas necesitan a la vez resultados exactos sobre todo el histórico y respuestas de baja latencia sobre los datos recientes. Lambda resuelve esto con dos caminos paralelos que luego se fusionan.
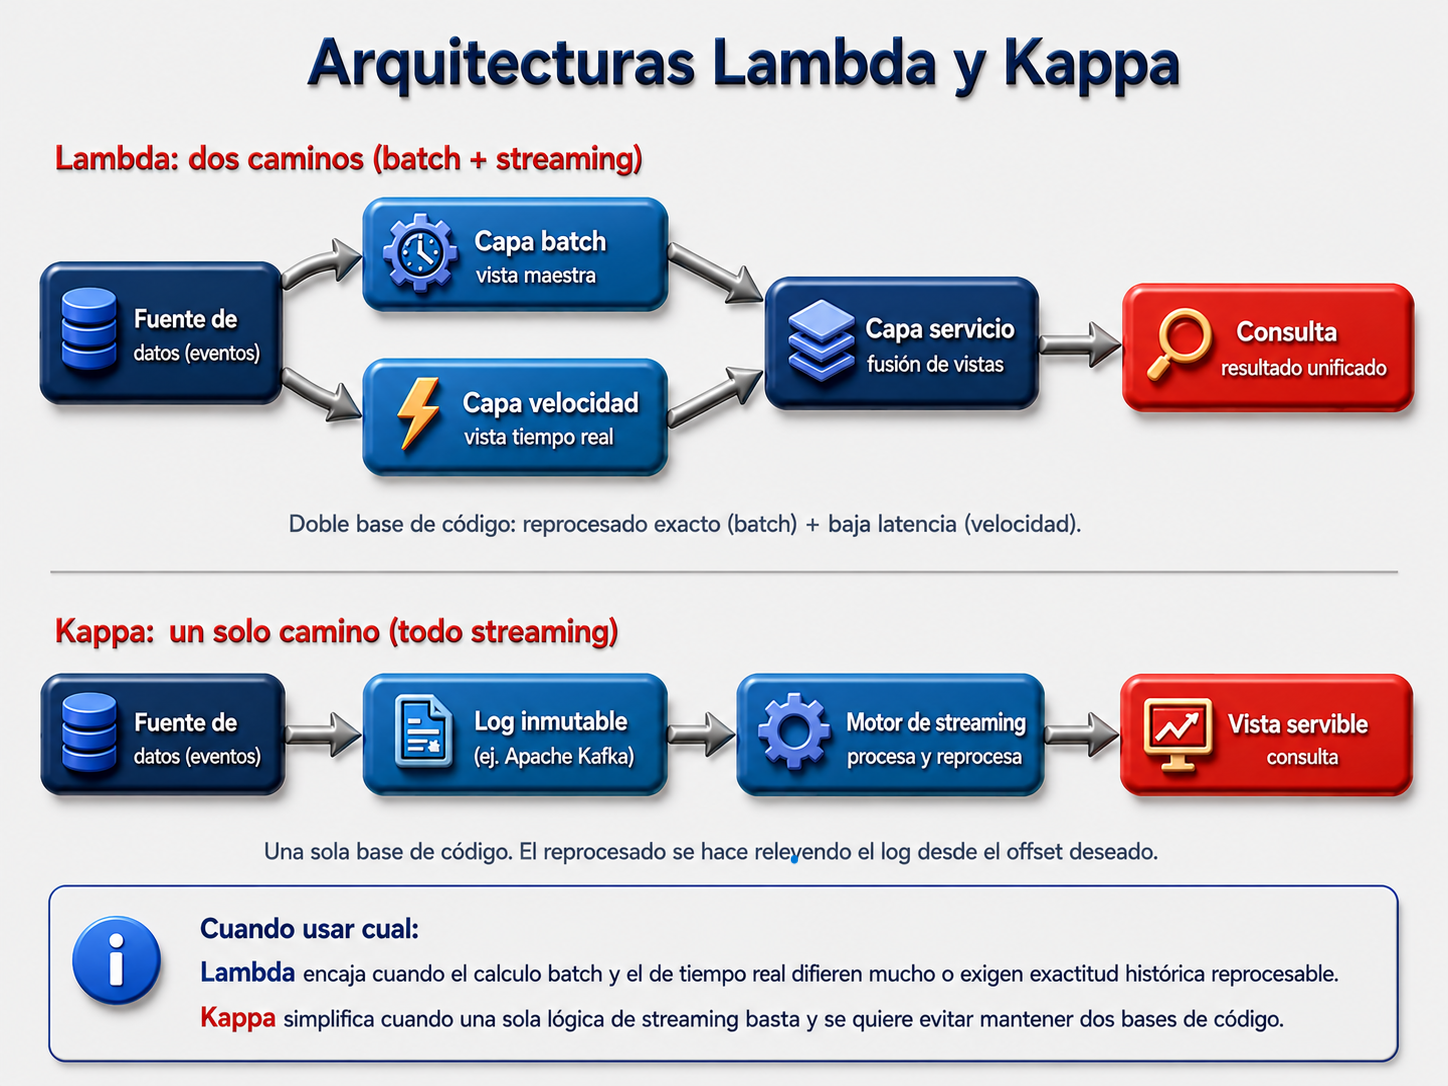
Figura 6.1 Arquitecturas Lambda (dos caminos) y Kappa (uno solo).
La capa batch procesa todo el conjunto de datos de forma periódica y produce vistas precomputadas exactas, pero con latencia alta. La capa de velocidad procesa solo los datos recientes en streaming, produciendo vistas aproximadas de baja latencia que cubren el hueco temporal que la capa batch aún no alcanzo. La capa de servicio fusiona ambas vistas para responder las consultas: lo exacto del histórico mas lo reciente en tiempo real.
La virtud de Lambda es la robustez: como la capa batch reprocesa todo desde los datos crudos, cualquier error en la lógica o en la capa de velocidad se corrige en la siguiente corrida batch. Su principal crítica es la duplicación: hay que implementar y mantener la misma lógica de negocio dos veces, en dos paradigmas distintos (batch y streaming), lo que multiplica el esfuerzo y el riesgo de que ambas versiones diverjan.
6.2 Arquitectura Kappa
La arquitectura Kappa fue propuesta por Jay Kreps -uno de los creadores de Kafka- en 2014, como respuesta directa a la complejidad de Lambda. Su idea es provocadora en su simplicidad: si el motor de streaming es lo bastante capaz y el log de eventos es reproducible, entonces no hace falta una capa batch separada. Todo se procesa como un flujo, con un único camino y una única base de código.
La clave que hace viable a Kappa es el log inmutable y reproducible -típicamente Kafka-: cuando se necesita reprocesar todo el histórico (por ejemplo, tras cambiar la lógica), no se corre un job batch distinto, sino que se relee el flujo desde el comienzo con el nuevo código de streaming. El reprocesado es “volver a reproducir la cinta” en lugar de mantener un segundo sistema.
Kappa elimina la duplicación de Lambda, pero no es universalmente superior. Funciona bien cuando una sola lógica de streaming basta para todos los casos. Cuando el cálculo batch y el de tiempo real difieren mucho -por ejemplo, un modelo pesado que solo tiene sentido correr sobre el histórico completo-, la separación de Lambda puede seguir siendo la opción más clara.
No hay una arquitectura correcta en abstracto. Lambda aporta robustez y exactitud reprocesable a costa de mantener dos bases de código; Kappa simplifica a una sola a costa de exigir que el streaming cubra todos los casos. La decisión depende de los requisitos de latencia, de cuan distintos son los cálculos batch y streaming, y de la capacidad del equipo para operar cada modelo.
6.3 Arquitecturas modernas: el giro organizativo
Las arquitecturas más recientes desplazan el foco de lo puramente técnico hacia lo organizativo. Reconocen que, a cierta escala, el cuello de botella ya no es la tecnología sino la coordinación entre equipos y el gobierno de los datos.
Data Mesh
Data Mesh es un paradigma propuesto por Zhamak Dehghani -primero en un artículo de 2019 publicado en el sitio de Martin Fowler y luego en su libro de O’Reilly de 2022-. Su tesis es que las arquitecturas monolíticas de datos (un único data lake o data warehouse central gestionado por un equipo especializado) no escalan bien con la complejidad organizativa. Data Mesh propone descentralizar sobre cuatro principios: propiedad por dominio (cada área de negocio es dueña de sus datos), datos como producto (tratar cada conjunto de datos con la disciplina de un producto, con calidad y documentación), plataforma de autoservicio (infraestructura común que habilita a los dominios) y gobierno federado y computacional (reglas comunes aplicadas de forma automatizada).
Data Mesh es más un paradigma sociotecnico que una arquitectura de cajas y flechas: mezcla decisiones de tecnología con decisiones de organización. Por eso su adopción es tanto un cambio cultural como técnico, y no encaja en toda organización.
Arquitecturas de lago moderno
En paralelo, el enfoque lakehouse (visto en el capítulo 4) representa la evolución técnica del almacenamiento hacia una plataforma única que sirve tanto a la ingeniería de datos como al análisis y al machine learning, sobre formatos de tabla abiertos con garantías transaccionales. Data Mesh y lakehouse no se excluyen: es común ver un data mesh implementado sobre una plataforma lakehouse de autoservicio.
7. Big Data en la practica
Un sistema de Big Data no vive solo de arquitectura y motores. Para que produzca valor sostenible necesita gobierno, calidad, seguridad y una comprensión realista de donde encaja en el stack existente. Este capítulo cierra el manual aterrizando el marco conceptual en las preocupaciones del día a día y conectándolo con el mundo on-premise real.
7.1 Gobierno de datos
El gobierno de datos es el conjunto de políticas, roles y procesos que aseguran que los datos sean confiables, comprensibles y utilizables a lo largo del tiempo. A escala de Big Data se vuelve más crítico, no menos: un data lake sin gobierno degenera en el data swamp mencionado en el capítulo 4. Los pilares habituales son el catálogo de datos (que datos existen, donde están, que significan), el linaje de datos (de donde viene cada dato y que transformaciones sufrió), la gestión de metadatos y la definición clara de propiedad y responsabilidad sobre cada conjunto.
El linaje merece un énfasis especial para quien trabaja en entornos de data warehouse: cuando un reporte muestra una cifra sospechosa, poder rastrear el dato hasta su origen -pasando por cada job de transformación- es la diferencia entre resolver una incidencia en horas o en días. Es la misma disciplina forense que se aplica al investigar una discrepancia en un reporte, escalada a todo el patrimonio de datos.
7.2 Calidad de datos
La calidad de datos es la V de veracidad puesta en práctica. Sus dimensiones clásicas son la exactitud (el dato refleja la realidad), la completitud (no faltan valores), la consistencia (no hay contradicciones entre fuentes), la unicidad (no hay duplicados no deseados) y la vigencia (el dato esta actualizado). A gran escala, verificar estas dimensiones exige automatización: reglas de validación que corren sobre los flujos y baterías de controles que detectan anomalías antes de que contaminen los reportes.
La experiencia práctica enseña que la calidad se defiende mejor en el origen y en la ingesta que en el reporte final. Un control de campos, una validación de rangos o una verificación de integridad referencial aplicados temprano en el pipeline evitan que un dato malo se propague. Cuando el error llega al tablero, el costo de rastrearlo y corregirlo ya se multiplico.
Las técnicas concretas de validación -controles de campos, verificación de medianas, chequeos de integridad, depuración- son el tipo de lógica que se implementa en los procesos de integración y en los parsers de log del entorno real. El marco de calidad de este capítulo es el porqué; la implementación es el como que vive en cada pipeline.
7.3 Seguridad y privacidad
A mayor concentración de datos, mayor la superficie de riesgo y más serias las consecuencias de una brecha. Los controles fundamentales son el control de acceso (quien puede ver o modificar que, con el principio de mínimo privilegio), el cifrado en reposo y en tránsito, la auditoria (registro de quien accedió a que y cuando) y las técnicas de protección de datos personales como la anonimización, la seudonimización y el enmascaramiento.
La privacidad además trae obligaciones regulatorias. En el contexto de telecomunicaciones, los datos de clientes y de trafico están sujetos a marcos legales específicos sobre que puede almacenarse, por cuanto tiempo y con qué fines. El diseño técnico debe contemplar estas restricciones desde el inicio -privacidad por diseño- y no como un parche posterior.
7.4 Big Data on-premise y en la nube
Buena parte de la literatura de Big Data asume la nube, pero muchos entornos productivos -sobre todo en sectores regulados como la banca y las telecomunicaciones- siguen operando on-premise, con clusters propios de Hadoop, motores como Teradata para el data warehouse y herramientas de integración y orquestación instaladas en infraestructura local. Es un contexto plenamente vigente y con lógica propia.
El stack on-premise clásico combina un data warehouse relacional de alto rendimiento (por ejemplo, Teradata) para la analítica estructurada y confiable, un cluster Hadoop para el almacenamiento y procesamiento de grandes volúmenes semi o no estructurados, herramientas de integración (como DataStage) para mover y transformar datos entre sistemas, un orquestador (como Control-M) para coordinar las cadenas de procesos batch, y una capa de BI (como MicroStrategy) para exponer los resultados. Cada una de esas piezas ocupa un lugar preciso en el panorama que este manual describió.
El panorama cloud, en breve
Los proveedores de nube ofrecen servicios gestionados que cubren cada casillero de este manual sin administrar la infraestructura: almacenes de objetos como capa de data lake, servicios de data warehouse elásticos, plataformas de procesamiento distribuido gestionadas y servicios de streaming administrados. Las tres grandes plataformas -AWS, Azure y Google Cloud- tienen equivalentes para casi todo lo visto aquí. La ventaja es operativa (elasticidad, menos administración); la contrapartida son consideraciones de costo variable, dependencia del proveedor y, en sectores regulados, requisitos de residencia y soberanía de los datos que a veces inclinan la balanza de vuelta hacia lo on-premise o hacia esquemas híbridos.
La lección de fondo es que la nube no cambia los conceptos de este manual: cambia quien opera la infraestructura. Las V, el teorema CAP, la distinción batch/streaming, las familias NoSQL y las arquitecturas Lambda y Kappa siguen aplicando igual, se ejecuten en un clúster propio o en servicios gestionados.
7.5 Cierre
Big Data no es una tecnología que haya que adoptar, sino un marco para razonar sobre problemas de datos cuando la escala, la velocidad o la variedad superan lo que un enfoque de un solo nodo resuelve cómodamente. Entender ese marco -las dimensiones del problema, los limites teóricos de los sistemas distribuidos, los paradigmas de procesamiento y las arquitecturas que los combinan- permite tomar decisiones informadas en lugar de seguir modas.
Este manual cierra la serie técnica de JAVIESCA sirviendo de paraguas conceptual a los anteriores. Cada tecnología documentada en los otros manuales encuentra aquí su lugar dentro de un mapa más amplio. La invitación final es a usar este marco como criterio: ante un nuevo problema de datos, preguntarse primero cuáles son sus dimensiones y que exige el caso de negocio, y solo entonces elegir las piezas del panorama que mejor lo resuelven.
Bibliografia y fuentes
Esta sección distingue, como es costumbre en la serie, entre las fuentes directas -artículos y libros originales efectivamente consultados y verificados, que son el origen primario de los conceptos del manual- y las lecturas recomendadas, obras de referencia útiles para profundizar. Todas las fuentes directas fueron verificadas en cuanto a autoría, ano y publicación.
Fuentes directas
Laney, D. (2001). 3D Data Management: Controlling Data Volume, Velocity and Variety. META Group, Application Delivery Strategies, File 949, 6 de febrero de 2001. [Origen de las tres V originales; cap. 1]
Brewer, E. (2000). Towards Robust Distributed Systems. Keynote invitada, ACM Symposium on Principles of Distributed Computing (PODC), Portland, Oregon. [Origen de la conjetura CAP; cap. 2]
Gilbert, S. y Lynch, N. (2002). Brewer’s Conjecture and the Feasibility of Consistent, Available, Partition-Tolerant Web Services. ACM SIGACT News, 33(2), 51-59. DOI: 10.1145/564585.564601. [Formalización y prueba del teorema CAP; cap. 2]
Ghemawat, S., Gobioff, H. y Leung, S.-T. (2003). The Google File System. Proceedings of the 19th ACM Symposium on Operating Systems Principles (SOSP), 29-43. [Sistema de archivos distribuido; cap. 4]
Dean, J. y Ghemawat, S. (2004). MapReduce: Simplified Data Processing on Large Clusters. Proceedings of the 6th USENIX Symposium on Operating Systems Design and Implementation (OSDI), San Francisco, 137-150. (Reeditado en Communications of the ACM, 51(1), 2008, 107-113). [Paradigma MapReduce; cap. 5]
Zaharia, M., Chowdhury, M., Das, T., Dave, A., Ma, J., McCauley, M., Franklin, M. J., Shenker, S. y Stoica, I. (2012). Resilient Distributed Datasets: A Fault-Tolerant Abstraction for In-Memory Cluster Computing. Proceedings of the 9th USENIX Symposium on Networked Systems Design and Implementation (NSDI), San Jose, 15-28. [Abstraccion RDD de Spark; cap. 5]
Marz, N. y Warren, J. (2015). Big Data: Principles and Best Practices of Scalable Realtime Data Systems. Manning Publications. ISBN 978-1-61729-034-3. [Arquitectura Lambda; caps. 3 y 6]
Kleppmann, M. (2017). Designing Data-Intensive Applications: The Big Ideas Behind Reliable, Scalable, and Maintainable Systems. O’Reilly Media. ISBN 978-1-4493-7332-0. (2.a edicion con C. Riccomini, 2026). [Referencia transversal de todo el manual]
Armbrust, M., Ghodsi, A., Xin, R. y Zaharia, M. (2021). Lakehouse: A New Generation of Open Platforms that Unify Data Warehousing and Advanced Analytics. Conference on Innovative Data Systems Research (CIDR). [Concepto de lakehouse; cap. 4]
Dehghani, Z. (2022). Data Mesh: Delivering Data-Driven Value at Scale. O’Reilly Media. ISBN 978-1-4920-9239-1. (Concepto presentado inicialmente en el artículo de 2019 en martinfowler.com). [Data Mesh; cap. 6]
Lecturas recomendadas
Kreps, J. (2014). Questioning the Lambda Architecture. O’Reilly Radar. [Artículo que propone la arquitectura Kappa; cap. 6]
Kleppmann, M. (2015). A Critique of the CAP Theorem. arXiv:1509.05393 [cs.DC]. [Matiza el alcance del teorema CAP; cap. 2]
Sadalage, P. y Fowler, M. (2012). NoSQL Distilled: A Brief Guide to the Emerging World of Polyglot Persistence. Addison-Wesley. [Panorama de familias NoSQL y persistencia poliglota; cap. 4]
White, T. (2015). Hadoop: The Definitive Guide (4.a ed.). O’Reilly Media. [Referencia integral del ecosistema Hadoop; complementa el cap. 5]
Las fuentes directas listadas arriba son los artículos y libros originales de los que provienen los conceptos centrales del manual, verificados en su autoría, año y datos de publicación. Las lecturas recomendadas amplían temas puntuales, pero no fueron la fuente primaria de este texto.