1 - Fundamentos del Data Warehouse
1.1 Que es un Data Warehouse?
Un Data Warehouse (DW o Almacen de Datos) es una base de datos especializada, diseñada exclusivamente para análisis y toma de decisiones. A diferencia de las bases de datos transaccionales (OLTP), que procesan operaciones en tiempo real, el DW integra, consolida y preserva datos históricos provenientes de múltiples fuentes del negocio.
“Un Data Warehouse es una colección de datos orientados al tema, integrados, no volátiles y variables en el tiempo, que están organizados para soportar el proceso de toma de decisiones.”
Las 4 características de Inmon
-
Orientado al tema: los datos se organizan alrededor de temas de negocio (ventas, clientes, productos) y no alrededor de aplicaciones o procesos.
-
Integrado: datos provenientes de múltiples fuentes heterogéneas se unifican bajo convenciones consistentes de nombres, formatos y unidades.
-
No volátil: una vez que los datos entran al DW, no se modifican ni se eliminan (solo se agregan). Esto garantiza consistencia histórica.
-
Variable en el tiempo: el DW almacena datos con perspectiva temporal. Cada registro tiene una dimensión de tiempo que permite análisis de tendencias.
1.2 Breve historia
| Década | Hito |
|---|---|
| 1970s | Primeros reportes de datos transaccionales. Sin separación OLTP/OLAP. |
| 1980s | Surge la idea de separar datos operativos de datos de análisis (Barry Devlin, IBM). |
| 1990s | W.H. Inmon acuna “Data Warehouse”. R. Kimball propone el modelo dimensional. |
| 2000s | Auge de herramientas BI: Business Objects, Cognos, Microstrategy. |
| 2010s | Cloud DW: Amazon Redshift, Google BigQuery, Snowflake. Big Data. |
| 2020s | Data Lakehouse: Delta Lake, Apache Iceberg. IA sobre DW. |
1.3 OLTP vs OLAP
Antes de profundizar en el DW, es fundamental entender la diferencia entre el mundo transaccional y el mundo analítico:
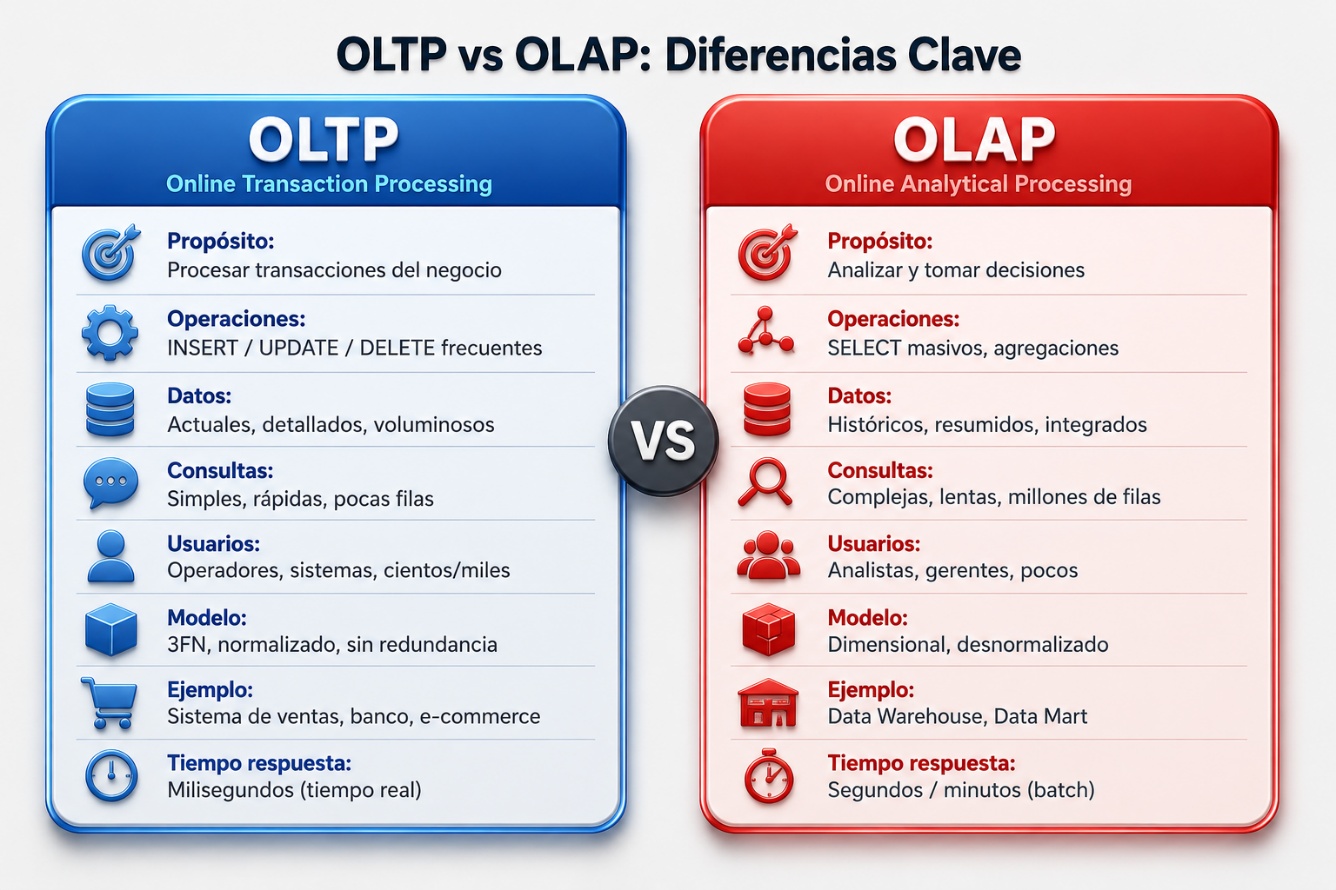
Nunca uses tu base OLTP de producción para generar reportes analíticos complejos. Un SELECT con múltiples JOINs sobre millones de filas puede bloquear las transacciones de usuarios reales. El DW existe exactamente para eso: desacoplar el análisis de la operación.
1.4 Arquitectura general
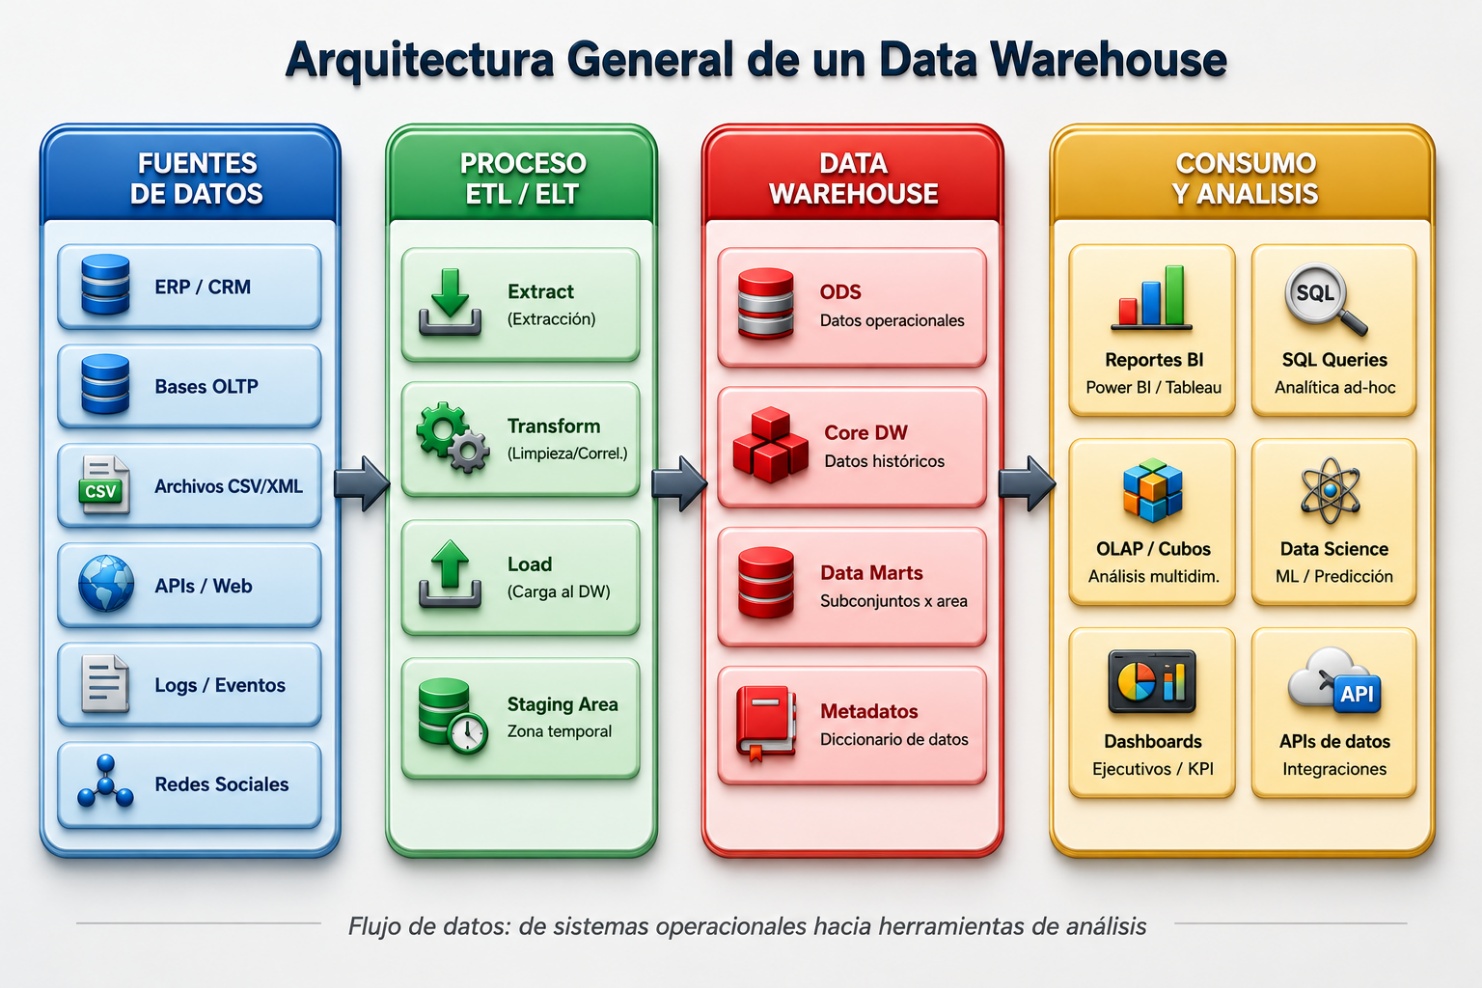
El diagrama siguiente muestra el flujo completo de datos: desde las fuentes operacionales, pasando por el proceso ETL, hasta llegar a las herramientas de consumo y análisis.
Componentes principales
-
Fuentes de datos: ERP, CRM, bases OLTP, archivos CSV/XML, APIs, logs, redes sociales.
-
Staging Area: zona temporal donde los datos se depositan antes de ser procesados.
-
Proceso ETL/ELT: extrae, transforma y carga los datos. Es el corazón de la integración.
-
Core Data Warehouse: repositorio central con datos históricos, integrados y no volátiles.
-
Data Marts: subconjuntos del DW orientados a un área de negocio especifica.
-
Capa de consumo: herramientas BI, reportes SQL, cubos OLAP, dashboards, Data Science.
Muchos proyectos confunden Data Mart con Data Warehouse. Un Data Mart es un subconjunto temático (ej: solo ventas), mientras que el DW es el repositorio corporativo completo. Un DW puede tener múltiples Data Marts alimentándose de él.
Capítulo 2 - Arquitecturas de Data Warehouse
2.1 Enfoque Kimball vs Inmon
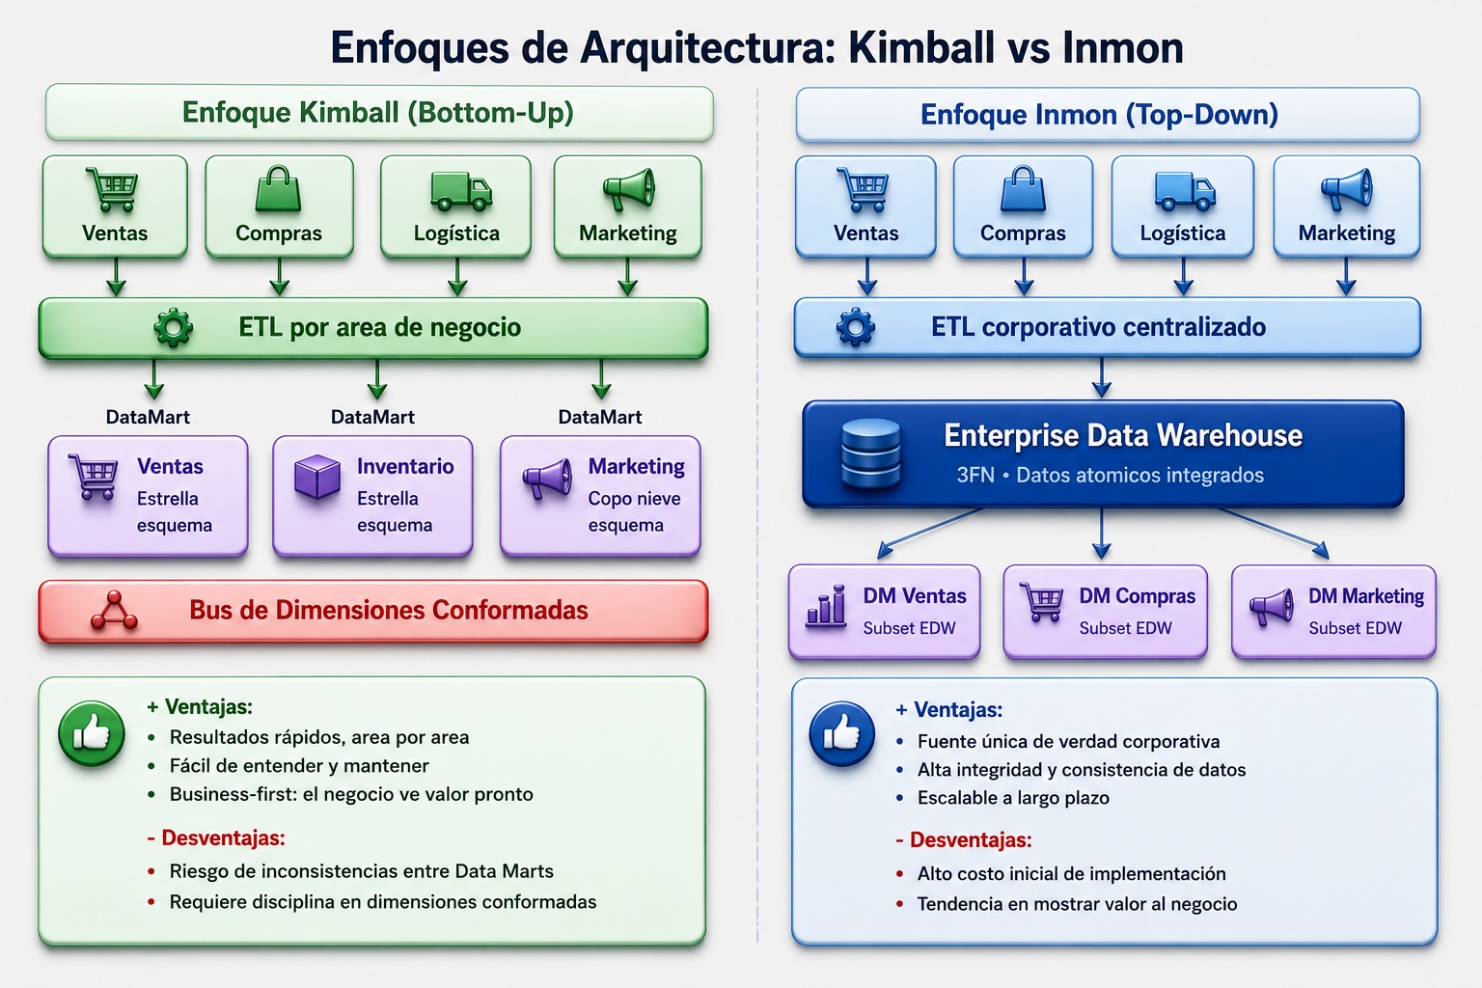
Existen dos escuelas clásicas de diseño de DW, cada una con filosofía y proceso de implementación diferentes. No hay una “correcta”: la elección depende del tamaño de la organización, el presupuesto y la urgencia de resultados.
¿Cuándo usar cada uno?
| Criterio | Kimball (Bottom-Up) | Inmon (Top-Down) |
|---|---|---|
| Tiempo al valor | Semanas/meses | Meses/años |
| Costo inicial | Bajo-Medio | Alto |
| Flexibilidad | Alta por área | Alta corporativa |
| Riesgo | Bajo (iterativo) | Alto (big bang) |
| Ideal para | PyMEs, startups | Corporaciones grandes |
| Modelo de datos | Dimensional (estrella) | Normalizado (3FN) |
La mayoría de las organizaciones modernas adoptan un enfoque hibrido: comienzan con Kimball (Data Marts rápidos) y, con el tiempo, construyen un EDW central estilo Inmon. Herramientas cloud como Snowflake y BigQuery facilitan esta transición.
2.2 Data Vault
Data Vault (Dan Linstedt, 2000) es una metodología de modelado para el DW corporativo que combina la flexibilidad de Kimball con la robustez de Inmon. Está pensado para entornos de alta variabilidad y equipos agiles.
Tres tipos de tablas en Data Vault
-
Hubs: entidades de negocio únicas (clientes, productos, pedidos). Contienen la clave de negocio y metadatos de carga.
-
Links: relaciones entre Hubs. Representan asociaciones como “un pedido pertenece a un cliente”.
-
Satélites: atributos descriptivos y su historial de cambios. Toda la historia queda almacenada.
-- Ejemplo simplificado Data Vault
-- Nota: Teradata no soporta PRIMARY KEY como constraint en tablas regulares.
--       Se usa UNIQUE PRIMARY INDEX para garantizar unicidad.

-- HUB de clientes
CREATE TABLE ecomm.hub_cliente (
    hub_cliente_sk  CHAR(32)        NOT NULL,
    cliente_bk      INTEGER         NOT NULL,
    load_date       TIMESTAMP       NOT NULL,
    record_source   VARCHAR(50)     NOT NULL
)
UNIQUE PRIMARY INDEX (hub_cliente_sk);

-- SATELLITE de atributos del cliente
CREATE TABLE ecomm.sat_cliente_info (
    hub_cliente_sk  CHAR(32)        NOT NULL,
    load_date       TIMESTAMP       NOT NULL,
    nombre          VARCHAR(100),
    email           VARCHAR(150),
    ciudad          VARCHAR(80)
)
PRIMARY INDEX (hub_cliente_sk);
2.3 Data Lakehouse
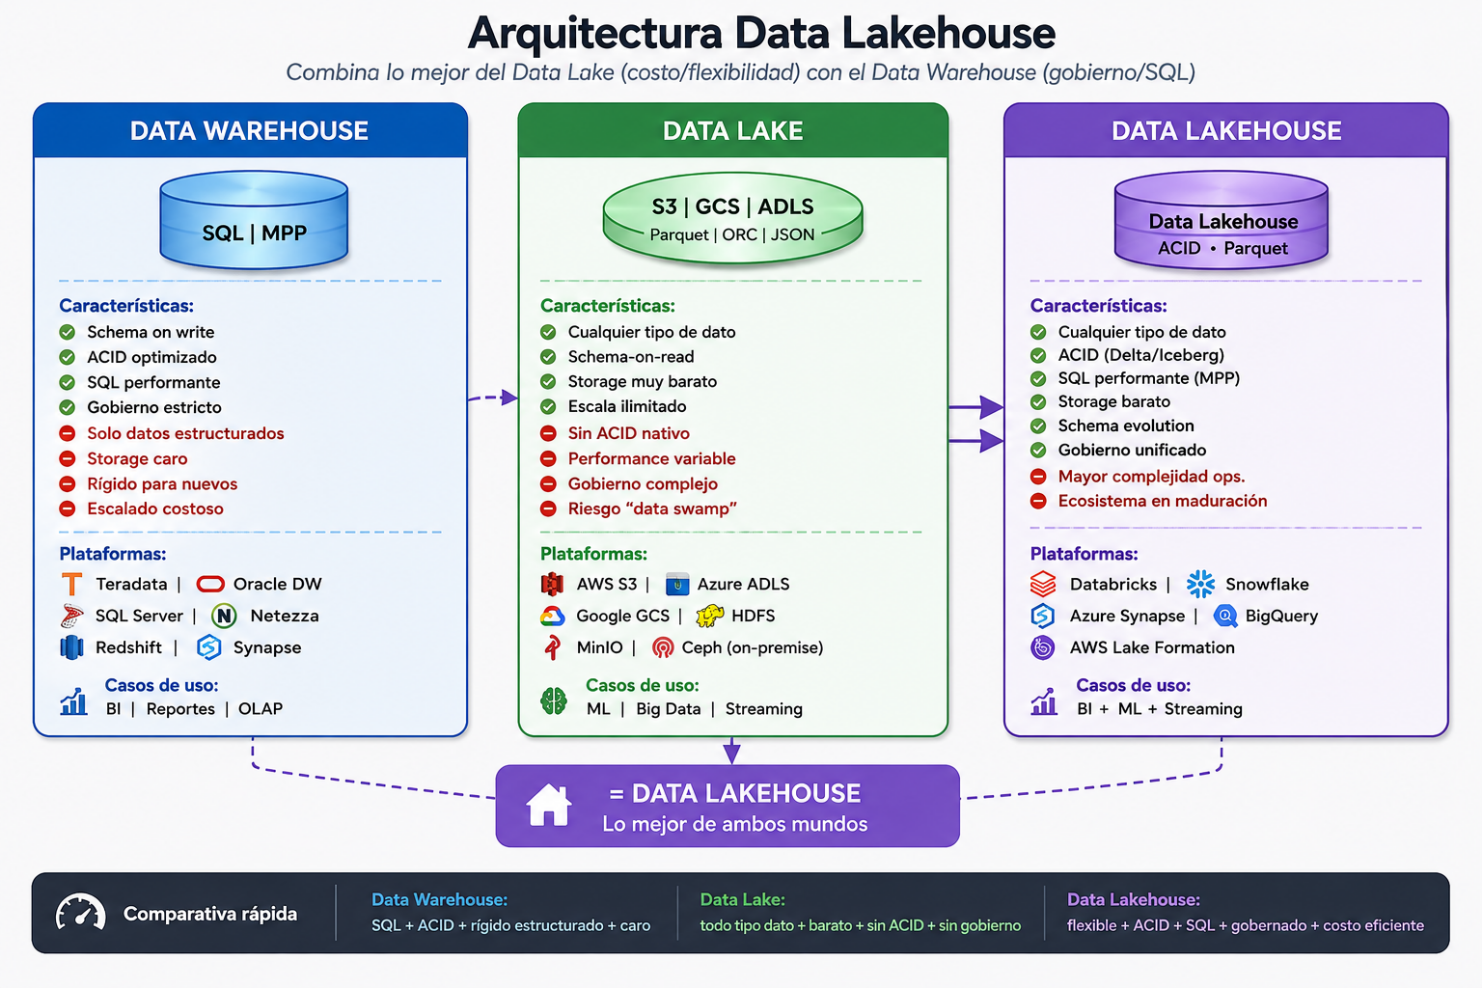
El Data Lakehouse (2020, Databricks) es la arquitectura más moderna, que combina la flexibilidad y bajo costo de un Data Lake con las capacidades analíticas y de gobierno de un Data Warehouse.
| Data Warehouse | Data Lake | Data Lakehouse | |
|---|---|---|---|
| Tipo de dato | Estructurado | Cualquiera | Cualquiera |
| Schema | Schema-on-write | Schema-on-read | Ambos |
| Performance | Alta (SQL) | Variable | Alta |
| Costo | Alto | Bajo | Medio |
| ACID | Si | No | Si (Delta/Iceberg) |
| Casos de uso | BI/Reportes | ML/Big Data | BI + ML + Streaming |
Capítulo 3 - Modelado Dimensional
El modelado dimensional es la técnica de diseño de base de datos predominante en DW. Fue popularizado por Ralph Kimball y esta optimizado para consultas analíticas: intuitivo para el usuario de negocio y eficiente para el motor de base de datos.
3.1 Tablas de Hechos y Dimensiones
Tabla de Hechos (Fact Table)
Contiene las métricas cuantificables del negocio (lo que se mide). Cada fila representa un evento o transacción.
-
Medidas: monto_total, cantidad, descuento, costo, margen_bruto.
-
Claves foraneas (FK): referencias a todas las dimensiones relacionadas.
-
Granularidad: el nivel de detalle de cada fila (ej: una fila por linea de pedido vs una fila por pedido).
Antes de crear la fact table, el equipo debe acordar: ¿que representa EXACTAMENTE una fila? Ejemplo: “una fila = una línea de detalle de pedido” implica que un pedido con 5 productos genera 5 filas. Esta decisión es irreversible sin recargar todo el historial.
Tablas de Dimensiones
-
Alta cardinalidad de atributos: un cliente puede tener nombre, apellido, segmento, ciudad…
-
Generalmente desnormalizadas (en estrella) para facilitar queries simples.
-
Surrogate Key (SK): clave técnica secuencial, independiente del sistema fuente.
3.2 Esquema Estrella (Star Schema)
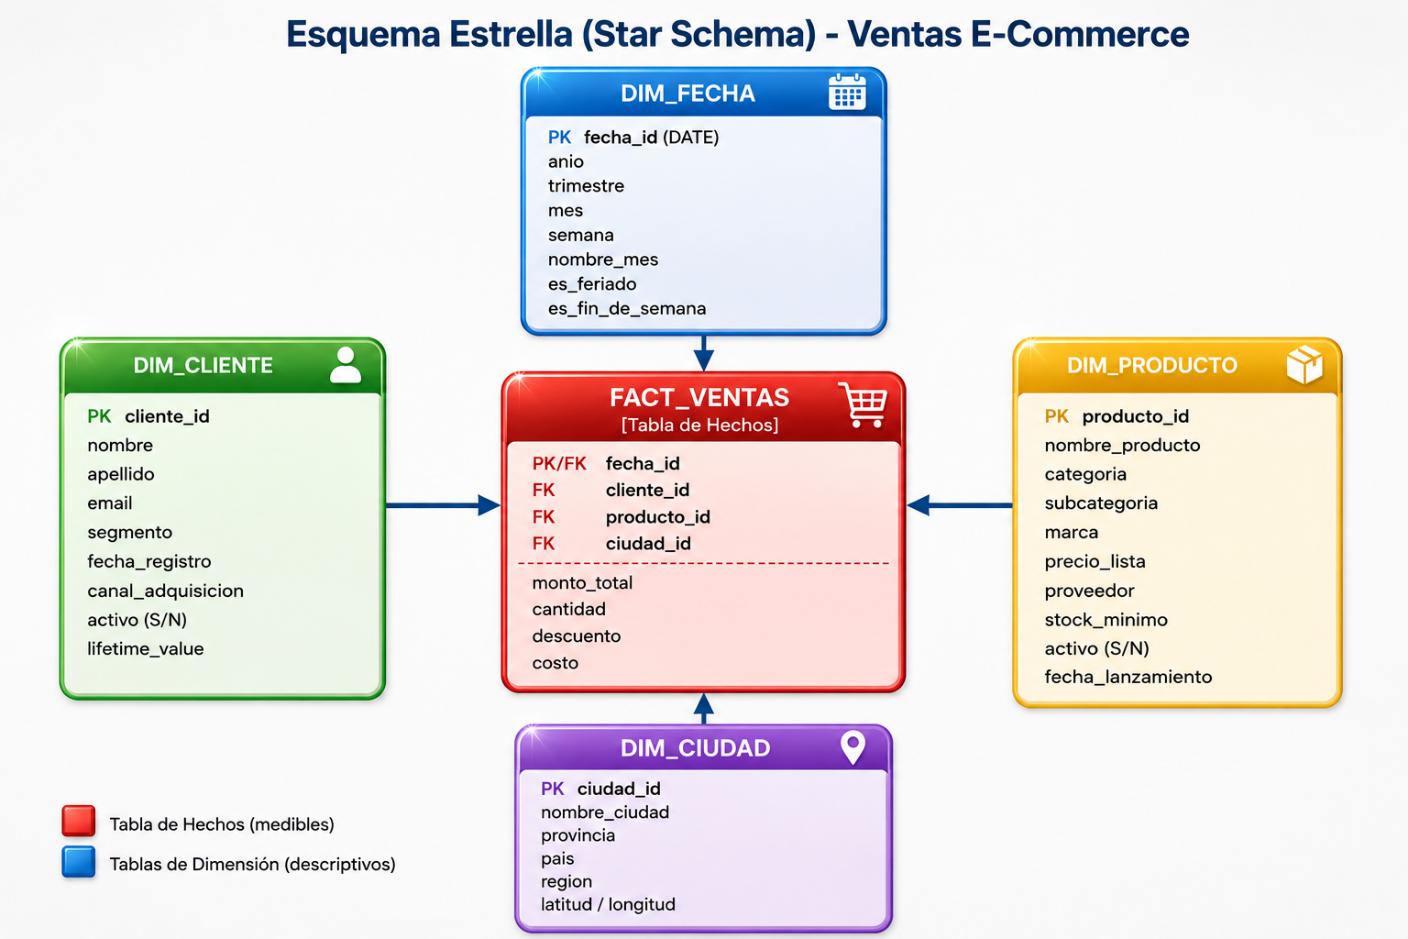
Ventajas del esquema estrella
-
Consultas simples: pocos JOINs necesarios (1 nivel entre fact y dim).
-
Performance optimizada: las dimensiones desnormalizadas evitan JOINs en cascada.
-
Comprensible para el usuario de negocio: la estructura es intuitiva.
-
Compatible con herramientas BI: Power BI, Tableau y similares lo detectan automáticamente.
3.3 Esquema Copo de Nieve (Snowflake Schema)
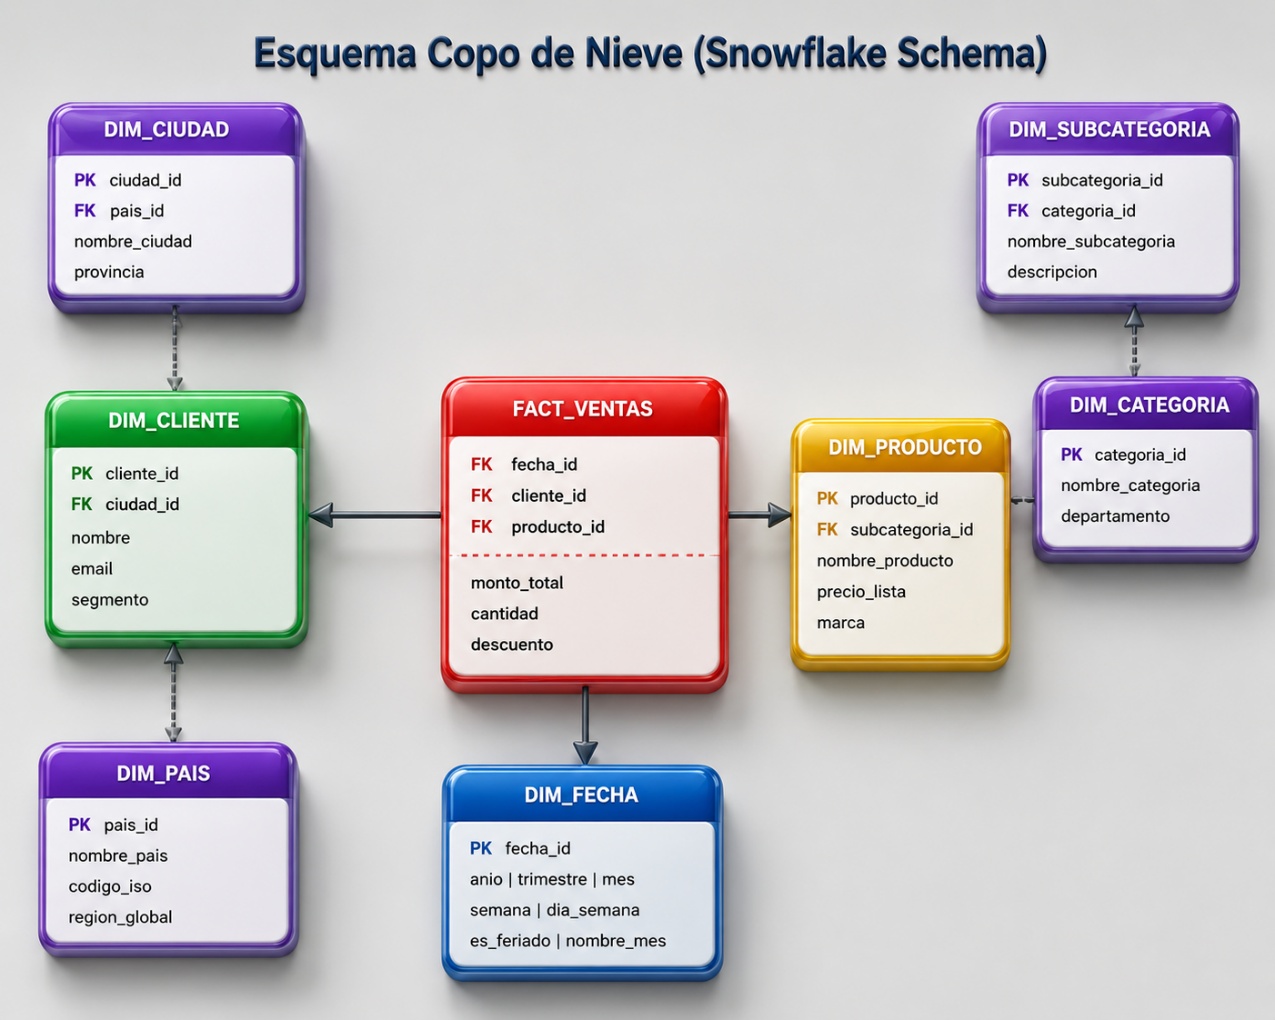
| Aspecto | Estrella | Copo de Nieve |
|---|---|---|
| Normalización | Desnormalizado | Normalizado parcialmente |
| JOINs | Pocos (1 nivel) | Mas JOINs (jerarquías) |
| Storage | Mas espacio | Menos espacio |
| Mantenimiento | Mas simple | Mas complejo |
| Performance | Generalmente mejor | Puede ser mas lento |
| Uso recomendado | DW en producción | DW muy grandes con jerarquías |
3.4 Slowly Changing Dimensions (SCD)
Las dimensiones cambian con el tiempo: un cliente se muda, un producto cambia de categoría. Los SCD definen como el DW gestiona esos cambios preservando (o no) el historial.
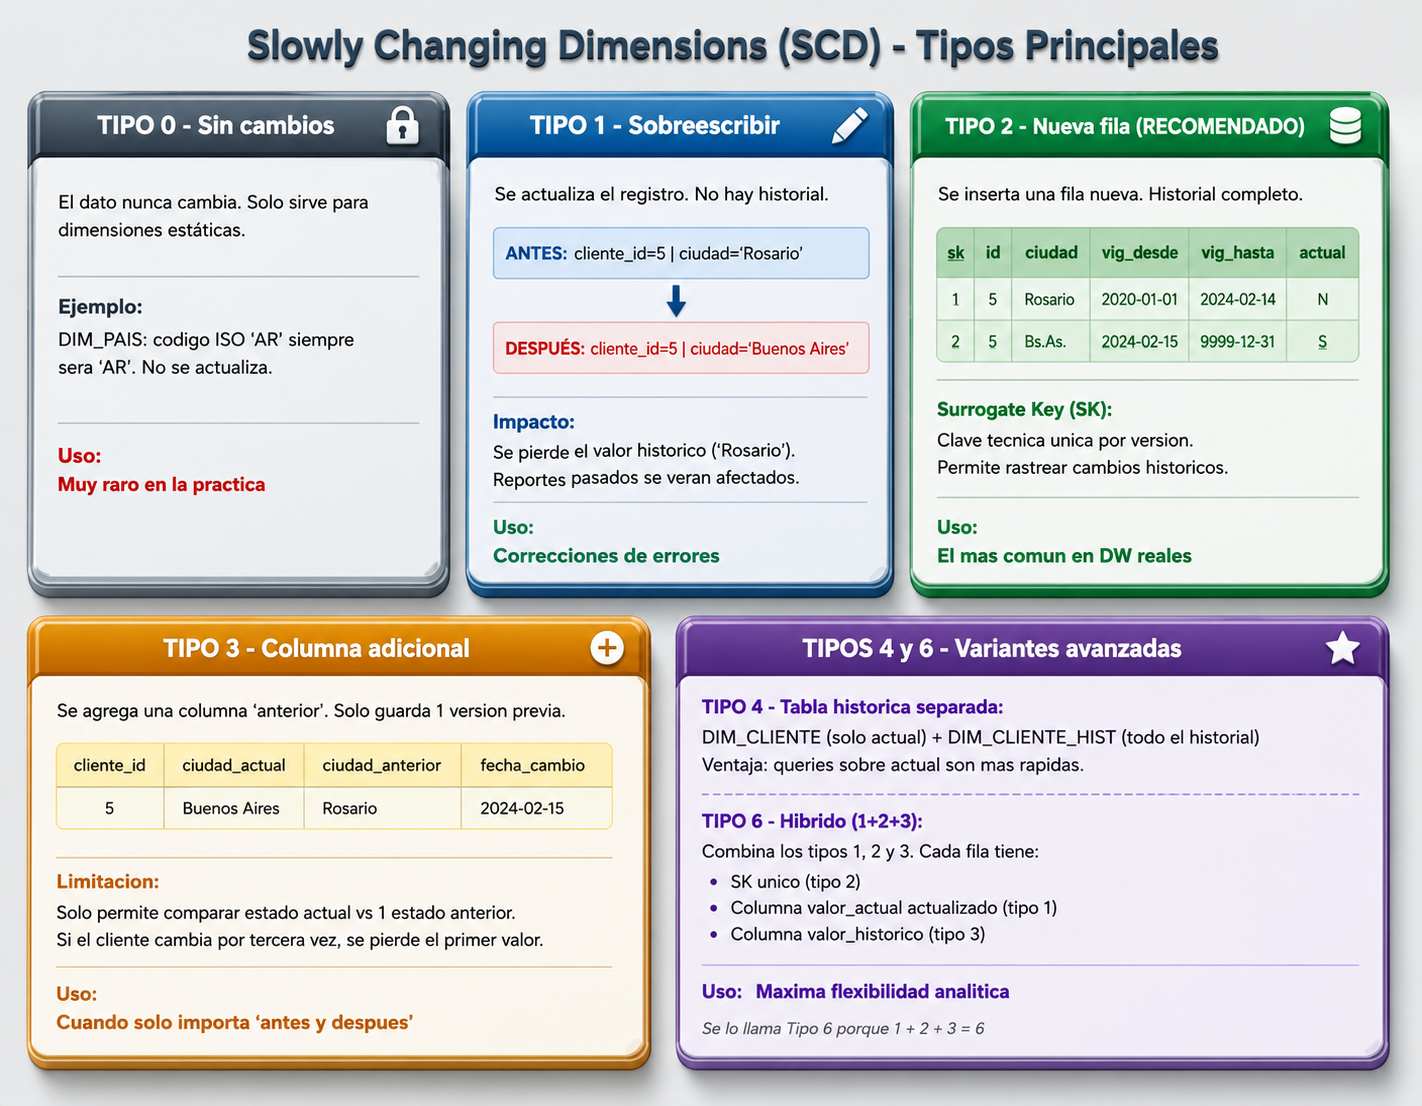
Para la mayoría de los casos, el Tipo 2 es la elección correcta. Agrega una fila por cada cambio, con columnas de vigencia (vig_desde / vig_hasta) y un flag “es_actual”. Esto permite saber cómo era el cliente/producto EN EL MOMENTO de cada venta.
Implementación SCD Tipo 2 en Teradata
-- Detectar clientes que cambiaron de ciudad
-- dim_cliente.ciudad es VARCHAR igual que ecomm.clientes.ciudad
SELECT
    c.cliente_id,
    c.ciudad        AS ciudad_nueva,
    dc.ciudad       AS ciudad_actual,
    dc.sk_cliente
FROM ecomm.clientes    c
JOIN ecomm.dim_cliente dc ON c.cliente_id = dc.cliente_id
                          AND dc.es_actual = 'S'
WHERE c.ciudad <> dc.ciudad;

-- 1. Cerrar fila vigente
UPDATE ecomm.dim_cliente
SET    vig_hasta = CURRENT_DATE - 1,
       es_actual = 'N'
WHERE  cliente_id IN (
    SELECT c.cliente_id
    FROM ecomm.clientes    c
    JOIN ecomm.dim_cliente dc ON c.cliente_id = dc.cliente_id
                              AND dc.es_actual = 'S'
    WHERE c.ciudad <> dc.ciudad
)
AND es_actual = 'S';

-- 2. Insertar nueva version con todos los campos de ecomm.clientes
INSERT INTO ecomm.dim_cliente (
    sk_cliente, cliente_id, nombre, email,
    pais, region, ciudad, segmento,
    fecha_registro, genero, activo,
    vig_desde, vig_hasta, es_actual)
SELECT
    (SELECT COALESCE(MAX(sk_cliente), 0) + 1 FROM ecomm.dim_cliente),
    c.cliente_id, c.nombre, c.email,
    c.pais, c.region, c.ciudad, c.segmento,
    c.fecha_alta    AS fecha_registro,
    c.genero, c.activo,
    CURRENT_DATE, DATE '9999-12-31', 'S'
FROM ecomm.clientes c
WHERE c.cliente_id IN (
    SELECT c2.cliente_id
    FROM ecomm.clientes    c2
    JOIN ecomm.dim_cliente dc ON c2.cliente_id = dc.cliente_id
                              AND dc.es_actual  = 'S'
    WHERE c2.ciudad <> dc.ciudad
);
Capítulo 4 - Procesos ETL y ELT
4.1 Conceptos fundamentales
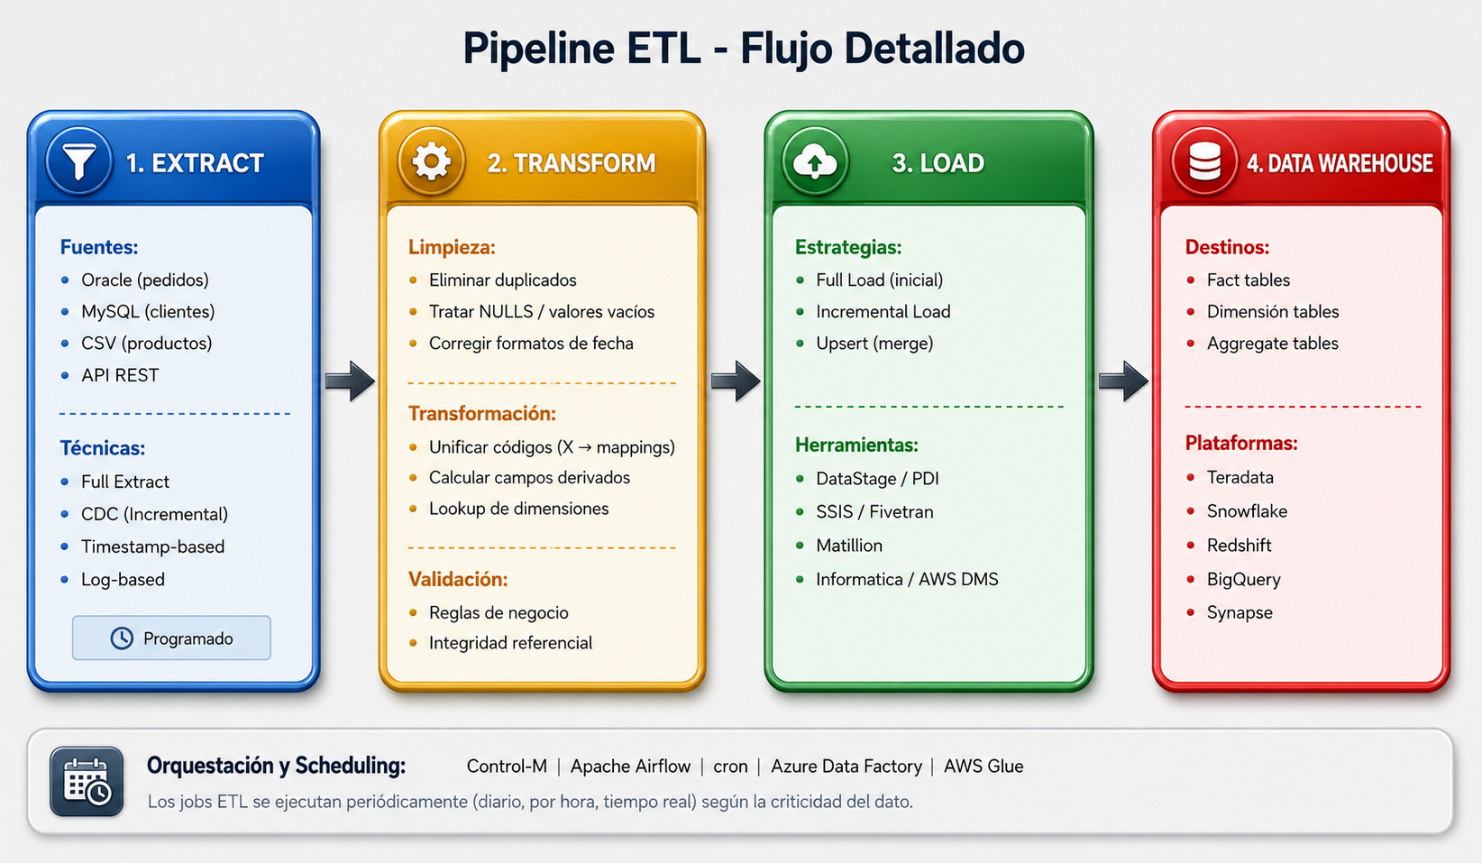
El proceso ETL (Extract, Transform, Load) es el motor que alimenta el Data Warehouse. Es responsable de mover datos desde las fuentes operacionales, limpiarlos, transformarlos segun las reglas del negocio, y cargarlos en el DW.
Pipeline ETL
Pipeline ELT
En el patrón ELT los datos se cargan primero en crudo al DW y las transformaciones se ejecutan dentro del motor, aprovechando su capacidad de procesamiento paralelo (MPP).
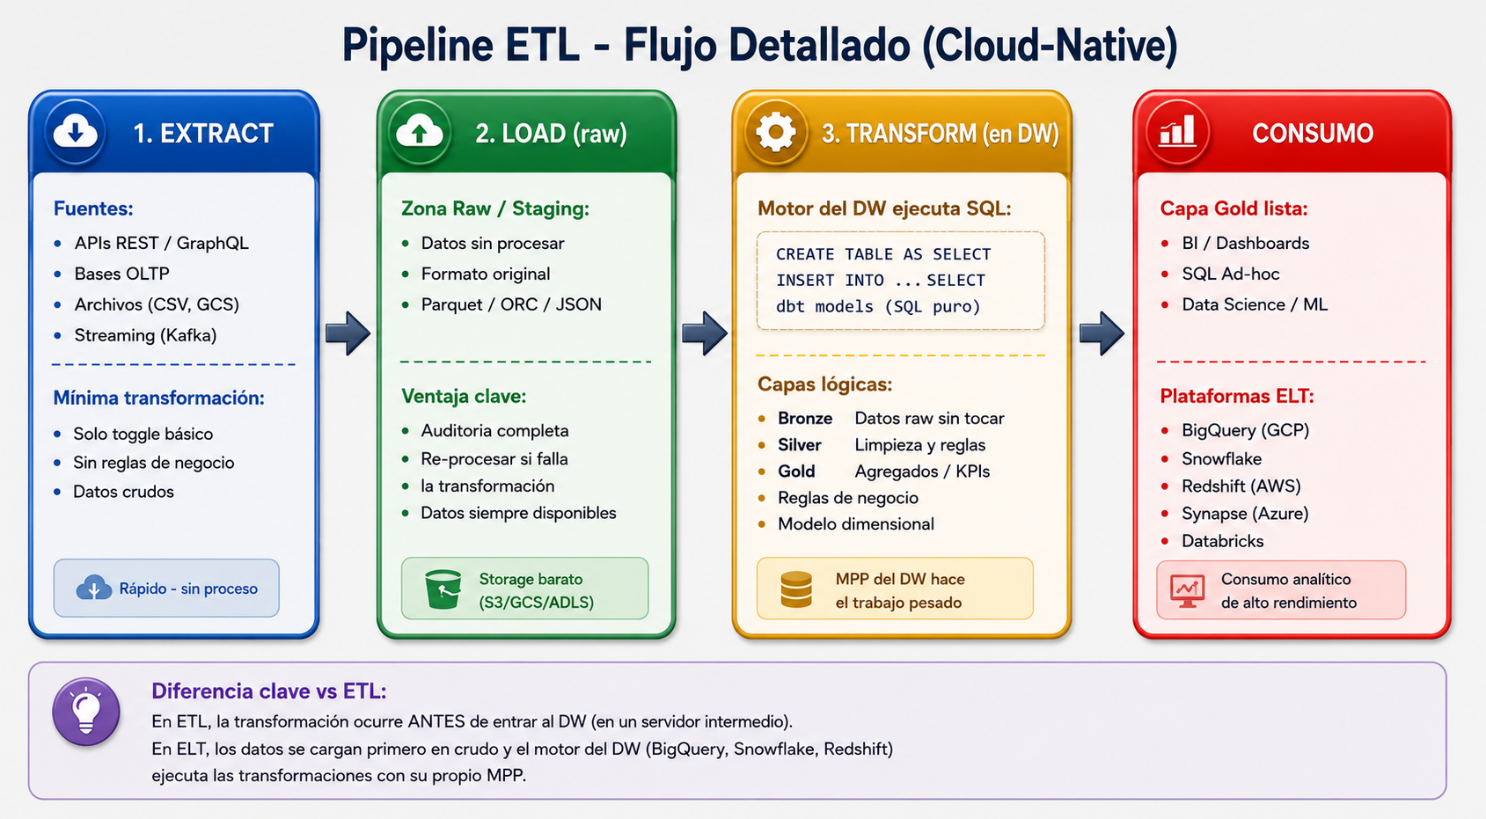
ETL vs ELT
| ETL | ELT | |
|---|---|---|
| Orden | Transformar ANTES de cargar | Cargar primero, transformar en DW |
| Donde transforma | Motor ETL externo | Motor del DW (SQL) |
| Ideal para | On-premise, Teradata | Cloud DW (BigQuery, Snowflake) |
| Velocidad carga | Mas lento | Mas rápido (menos pasos) |
| Auditoria | Dificil en staging | Datos crudos disponibles en DW |
| Herramientas típicas | DataStage, Informatica, SSIS | dbt, Dataform, Spark SQL |
4.2 Extracción (Extract)
Tipos de extracción
-
Full Extract: se extrae toda la tabla fuente en cada ejecución. Simple pero costoso en volumen.
-
CDC (Change Data Capture): solo se extraen los registros nuevos o modificados desde la última ejecución.
-
Timestamp-based: se filtra por una columna de fecha/hora de última modificación.
-
Log-based CDC: se lee el log de transacciones de la base fuente (más preciso, más complejo).
-- Extracción incremental por fecha desde ecomm.pedidos
-- Nota: ecomm.pedidos no tiene columna fecha_modificacion.
--       Se filtra por fecha_pedido. En un entorno real se agregaría
--       una columna fecha_modificacion a la tabla fuente.
SELECT
    pedido_id,
    cliente_id,
    producto_id,
    fecha_pedido,
    cantidad,
    monto_total,
    estado,
    canal
FROM ecomm.pedidos
WHERE fecha_pedido >= DATE '2024-01-01'   -- reemplazar por fecha de control
ORDER BY fecha_pedido;
4.3 Transformación (Transform)
-
Limpieza: eliminar duplicados, corregir formatos de fecha, reemplazar NULLs.
-
Estandarización: “AR” -> “Argentina”, “M” -> “Masculino”.
-
Derivación: calcular nuevas columnas (precio - costo = margen).
-
Lookup: reemplazar códigos por surrogate keys de dimensiones.
-
Validación: verificar que las FK existen en dimensiones.
“Garbage in, garbage out.” Si los datos fuente tienen errores, el DW los ampliara. Implementa siempre una capa de validación en el ETL con reglas claras: ¿Qué hacemos con un registro invalido? ¿Lo rechazamos? ¿Lo corregimos? ¿Lo marcamos? Documenta la decisión y genera tablas de errores para auditoria.
Ejemplo: carga de ecomm.pedidos hacia ecomm.fact_ventas
-- Carga ETL: ecomm.pedidos (operacional) -> ecomm.fact_ventas (DW)
-- fact_ventas incluye los mismos campos de pedidos: canal, estado,
-- precio_unitario, descuento_pct, monto_bruto, monto_descuento
INSERT INTO ecomm.fact_ventas (
    fecha_id, cliente_sk, producto_sk, ciudad_sk,
    pedido_id, cantidad, precio_unitario,
    descuento_pct, monto_bruto, monto_descuento,
    monto_total, costo, margen_bruto, canal, estado)
SELECT
    p.fecha_pedido                              AS fecha_id,
    dc.sk_cliente,
    dp.sk_producto,
    dci.sk_ciudad,
    p.pedido_id,
    p.cantidad,
    p.precio_unitario,
    COALESCE(p.descuento_pct, 0)               AS descuento_pct,
    p.monto_bruto,
    COALESCE(p.monto_descuento, 0)             AS monto_descuento,
    p.monto_total,
    dp.costo_unitario * p.cantidad             AS costo,
    p.monto_total
      - (dp.costo_unitario * p.cantidad)       AS margen_bruto,
    p.canal,
    p.estado
FROM ecomm.pedidos         p
JOIN ecomm.dim_cliente     dc  ON p.cliente_id  = dc.cliente_id
                               AND dc.es_actual = 'S'
JOIN ecomm.dim_producto    dp  ON p.producto_id = dp.producto_id
                               AND dp.es_actual = 'S'
JOIN ecomm.dim_ciudad      dci ON dc.ciudad     = dci.nombre_ciudad
                               AND dci.es_actual = 'S'
WHERE p.estado = 'ENTREGADO'
  AND p.monto_total > 0;
4.4 DataStage en el contexto ETL
IBM DataStage es una herramienta visual de integración de datos ampliamente usada en entornos corporativos con Teradata.
-
Job: unidad de ejecución. Cada job representa un flujo de datos.
-
Stage: componente dentro del job (Connector, Transformer, Aggregator, etc.).
-
Link: conector entre stages que define el flujo de datos.
-
Parallel jobs: jobs que procesan datos en múltiples particiones simultáneamente.
Siempre loguear el inicio y fin de cada job con timestamp en tabla de control. Usar parámetros de fecha: nunca hardcodear fechas dentro del job. Implementar reintentos automáticos para jobs que fallen por locks o timeouts. Monitorear con Control-M: permite dependencias entre jobs y alertas por fallo.
Capítulo 5 - Calidad de Datos y Gobierno
5.1 Dimensiones de calidad de datos
| Dimension | Definición | Ejemplo de problema |
|---|---|---|
| Completitud | Todos los datos requeridos están presentes | Pedidos sin cliente_id (NULL) |
| Precisión | Los datos reflejan la realidad correctamente | Monto_total = -500 (negativo) |
| Consistencia | Mismo dato = mismo valor en todo el DW | ”AR” y “Argentina” para el mismo pais |
| Unicidad | Sin duplicados no intencionados | Cliente_id=123 aparece dos veces |
| Oportunidad | Datos disponibles cuando se necesitan | Ventas de ayer aun no cargadas a las 9AM |
| Validez | Los datos cumplen las reglas de formato | Fecha “31/02/2024” (no existe) |
5.2 Reglas de calidad en el ETL
-- 1. Completitud: pedidos sin cliente_id
SELECT COUNT(*) AS pedidos_sin_cliente
FROM ecomm.pedidos
WHERE cliente_id IS NULL;

-- 2. Unicidad: pedidos duplicados
SELECT pedido_id, COUNT(*) AS cnt
FROM ecomm.pedidos
GROUP BY pedido_id
HAVING cnt > 1;

-- 3. Integridad referencial: pedidos cuyo cliente no existe en dim_cliente
SELECT p.pedido_id, p.cliente_id
FROM ecomm.pedidos     p
LEFT JOIN ecomm.dim_cliente dc ON p.cliente_id = dc.cliente_id
                               AND dc.es_actual = 'S'
WHERE dc.cliente_id IS NULL;

-- 4. Rango de valores: montos invalidos
SELECT COUNT(*) AS montos_invalidos
FROM ecomm.pedidos
WHERE monto_total <= 0 OR monto_total > 10000000;
5.3 Gobierno de datos
Roles clave
-
Data Owner: responsable del negocio por los datos de su área.
-
Data Steward: responsable técnico del mantenimiento de la calidad y el diccionario.
-
Data Engineer: construye y mantiene los pipelines ETL y la infraestructura del DW.
-
Data Analyst / BI Developer: consume los datos para generar insights y reportes.
Capítulo 6 - Herramientas y Tecnologías
6.1 Plataformas de Data Warehouse
| Plataforma | Tipo | Fortalezas | Ideal para |
|---|---|---|---|
| Teradata | On-premise/Cloud | MPP, performance masiva, SQL avanzado | Empresas grandes, banca, telecom |
| Snowflake | Cloud (SaaS) | Escalabilidad dinámica, separación compute/storage | Cloud-first, multi-nube |
| Amazon Redshift | Cloud (AWS) | Integración AWS, columnar, costo-efectivo | Ecosistema AWS |
| Google BigQuery | Cloud (GCP) | Serverless, SQL estándar, ML integrado | Ecosistema GCP, ELT |
| Azure Synapse | Cloud (Azure) | Integracion Office 365, Power BI nativo | Ecosistema Microsoft |
| PostgreSQL | Open source | Gratuito, extensible, SQL estándar | Proyectos pequeños/medianos |
6.2 Teradata: capacidades clave para DW
-- Primary Index: define distribución de filas entre AMPs
-- La partición arranca en 2022 porque es el rango de datos de ecomm.pedidos
CREATE TABLE ecomm.fact_ventas (
    fecha_id        DATE            NOT NULL,
    cliente_sk      INTEGER         NOT NULL,
    producto_sk     INTEGER         NOT NULL,
    ciudad_sk       INTEGER         NOT NULL,
    pedido_id       INTEGER,
    cantidad        SMALLINT,
    precio_unitario DECIMAL(10,2),
    descuento_pct   DECIMAL(5,2)    DEFAULT 0,
    monto_bruto     DECIMAL(12,2),
    monto_descuento DECIMAL(12,2)   DEFAULT 0,
    monto_total     DECIMAL(12,2),
    costo           DECIMAL(12,2),
    margen_bruto    DECIMAL(12,2),
    canal           VARCHAR(30),
    estado          VARCHAR(20)
)
PRIMARY INDEX (cliente_sk)
PARTITION BY RANGE_N(
    fecha_id BETWEEN DATE '2022-01-01'
             AND     DATE '2025-12-31'
    EACH INTERVAL '1' MONTH,
    NO RANGE OR UNKNOWN
);

-- Recolectar estadísticas tras la carga
COLLECT STATISTICS ON ecomm.fact_ventas COLUMN (fecha_id, cliente_sk);
COLLECT STATISTICS ON ecomm.fact_ventas COLUMN (producto_sk);
COLLECT STATISTICS ON ecomm.fact_ventas COLUMN (ciudad_sk);
6.3 Herramientas de BI y visualización
| Herramienta | Empresa | Caracteristica principal |
|---|---|---|
| Power BI | Microsoft | Integración Office 365, DAX, amplia adopcion |
| Tableau | Salesforce | Mejor experiencia de usuario, drag & drop |
| Looker / LookML | Semántica de datos centralizada, SQL-based | |
| MicroStrategy | MicroStrategy | Enterprise, alta seguridad, muy configurable |
| Apache Superset | Apache / OSS | Open source, facil de instalar, SQL + viz |
Capítulo 7 - Optimización y Performance
7.1 Estrategias de optimización
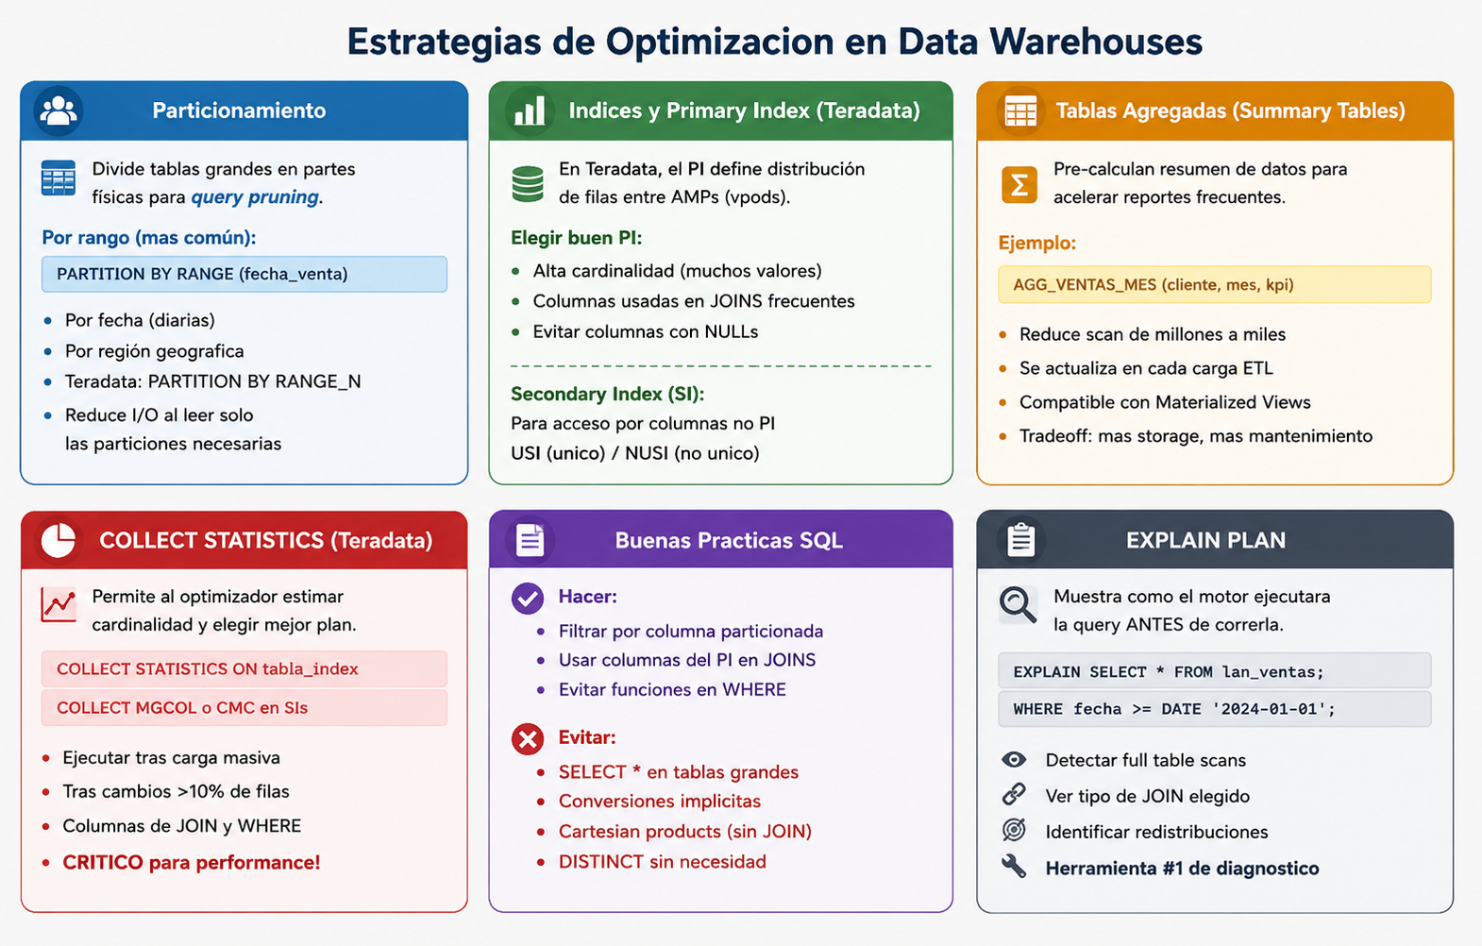
7.2 Particionamiento en Teradata
-- fact_ventas con partición mensual
CREATE TABLE ecomm.fact_ventas (
    fecha_id    DATE            NOT NULL,
    cliente_sk  INTEGER         NOT NULL,
    monto_total DECIMAL(15,2)
)
PRIMARY INDEX (cliente_sk)
PARTITION BY RANGE_N(
    fecha_id BETWEEN DATE '2020-01-01'
             AND     DATE '2030-12-31'
    EACH INTERVAL '1' MONTH,
    NO RANGE OR UNKNOWN
);

-- Query optimizada: solo lee partición de enero 2024
SELECT
    cliente_sk,
    SUM(monto_total) AS total
FROM ecomm.fact_ventas
WHERE fecha_id BETWEEN DATE '2024-01-01'
               AND     DATE '2024-01-31'
GROUP BY cliente_sk;

-- Verificar eliminación de particiones con EXPLAIN
EXPLAIN
SELECT SUM(monto_total)
FROM ecomm.fact_ventas
WHERE fecha_id = DATE '2024-06-15';
7.3 Window Functions para análisis
En Teradata, QUALIFY filtra directamente el resultado de funciones analíticas sin necesidad de un subquery. Es equivalente a hacer WHERE sobre el RANK() o ROW_NUMBER(). Ejemplo: QUALIFY ROW_NUMBER() OVER (PARTITION BY cliente_sk ORDER BY fecha DESC) = 1
Capítulo 8 - Casos Prácticos con SQL
Este capítulo presenta consultas analíticas reales sobre el schema e-Commerce. Todas funcionan en Teradata con las tablas: ecomm.fact_ventas, ecomm.dim_cliente, ecomm.dim_producto, ecomm.dim_fecha, ecomm.dim_ciudad.
Todos los ejercicios de este capítulo y los anteriores se encuentran en el archivo ejercicios_datawarehouse.sql que acompaña este manual. El archivo está en ASCII puro: compatible con cualquier editor de texto o IDE SQL.
8.1 Análisis de ventas por periodo
-- Ventas por trimestre y categoría de producto
SELECT
    df.anio,
    df.trimestre,
    dp.categoria,
    COUNT(DISTINCT fv.cliente_sk)       AS clientes_unicos,
    SUM(fv.cantidad)                    AS unidades_vendidas,
    SUM(fv.monto_total)                 AS ingresos,
    SUM(fv.margen_bruto)                AS margen,
    SUM(fv.margen_bruto)
      / NULLIF(SUM(fv.monto_total), 0)
      * 100                             AS pct_margen
FROM ecomm.fact_ventas    fv
JOIN ecomm.dim_producto   dp ON fv.producto_sk = dp.sk_producto AND dp.es_actual = 'S'
JOIN ecomm.dim_fecha      df ON fv.fecha_id    = df.fecha_id
WHERE df.anio BETWEEN 2022 AND 2024
GROUP BY df.anio, df.trimestre, dp.categoria
ORDER BY df.anio, df.trimestre, margen DESC;
8.2 Analisis RFM (Recency, Frequency, Monetary)
/*NTILE no está disponible en Teradata TD 14.x y versiones anteriores.
 Si la query va a correr en distintos entornos, es más seguro usar RANK() + CASE como se muestra acá.*/

WITH rfm_base AS (
    SELECT
        fv.cliente_sk,
        dc.nombre,
        dc.segmento,
        MAX(fv.fecha_id)                  AS ultima_compra,
        (CURRENT_DATE - MAX(fv.fecha_id)) AS dias_recencia,
        COUNT(DISTINCT fv.pedido_id)      AS frecuencia,
        SUM(fv.monto_total)               AS monetario
    FROM ecomm.fact_ventas   fv
    JOIN ecomm.dim_cliente   dc ON fv.cliente_sk = dc.sk_cliente
                               AND dc.es_actual  = 'S'
    GROUP BY fv.cliente_sk, dc.nombre, dc.segmento
),
rfm_scored AS (
    SELECT
        cliente_sk, nombre, segmento,
        dias_recencia, frecuencia, monetario,
        CASE
            WHEN dias_recencia <=  30 THEN 5
            WHEN dias_recencia <=  90 THEN 4
            WHEN dias_recencia <= 180 THEN 3
            WHEN dias_recencia <= 365 THEN 2
            ELSE 1
        END AS score_r,
        CASE
            WHEN RANK() OVER (ORDER BY frecuencia ASC) * 5
                 / COUNT(*) OVER () <= 1 THEN 1
            WHEN RANK() OVER (ORDER BY frecuencia ASC) * 5
                 / COUNT(*) OVER () <= 2 THEN 2
            WHEN RANK() OVER (ORDER BY frecuencia ASC) * 5
                 / COUNT(*) OVER () <= 3 THEN 3
            WHEN RANK() OVER (ORDER BY frecuencia ASC) * 5
                 / COUNT(*) OVER () <= 4 THEN 4
            ELSE 5
        END AS score_f,
        CASE
            WHEN RANK() OVER (ORDER BY monetario ASC) * 5
                 / COUNT(*) OVER () <= 1 THEN 1
            WHEN RANK() OVER (ORDER BY monetario ASC) * 5
                 / COUNT(*) OVER () <= 2 THEN 2
            WHEN RANK() OVER (ORDER BY monetario ASC) * 5
                 / COUNT(*) OVER () <= 3 THEN 3
            WHEN RANK() OVER (ORDER BY monetario ASC) * 5
                 / COUNT(*) OVER () <= 4 THEN 4
            ELSE 5
        END AS score_m
    FROM rfm_base
)
SELECT
    nombre,
    segmento,
    score_r,
    score_f,
    score_m,
    score_r + score_f + score_m AS rfm_total,
    CASE
        WHEN score_r + score_f + score_m >= 13 THEN 'Champions'
        WHEN score_r >= 4 AND score_f >= 3     THEN 'Loyal'
        WHEN score_r >= 4 AND score_f < 2      THEN 'New Customer'
        WHEN score_r <= 2 AND score_m >= 4     THEN 'At Risk - High Value'
        WHEN score_r <= 2 AND score_m < 2      THEN 'Lost'
        ELSE                                        'Potential Loyalist'
    END AS segmento_rfm
FROM rfm_scored
ORDER BY rfm_total DESC;
8.3 Detección de anomalías en ventas
-- Detectar dias con ventas anómalas (z-score > 2 desviaciones estándar)
WITH stats AS (
    SELECT
        AVG(ventas_dia)            AS media,
        STDDEV_POP(ventas_dia)     AS desvio
    FROM (
        SELECT fecha_id, SUM(monto_total) AS ventas_dia
        FROM ecomm.fact_ventas
        GROUP BY fecha_id
    ) t
)
SELECT
    fv.fecha_id,
    SUM(fv.monto_total)            AS ventas_dia,
    s.media,
    (SUM(fv.monto_total) - s.media)
      / NULLIF(s.desvio, 0)        AS z_score
FROM ecomm.fact_ventas fv
CROSS JOIN stats s
GROUP BY fv.fecha_id, s.media, s.desvio
HAVING ABS(
    (SUM(fv.monto_total) - s.media)
    / NULLIF(s.desvio, 0)
) > 2
ORDER BY z_score DESC;
8.4 Cohorte de clientes (retención mensual)
-- Análisis de cohortes: retención por mes de primera compra
WITH primera_compra AS (
    SELECT
        cliente_sk,
        MIN(fecha_id)   AS fecha_primera_compra,
        CAST(EXTRACT(YEAR  FROM MIN(fecha_id)) AS CHAR(4))
        || '-'
        || CAST(EXTRACT(MONTH FROM MIN(fecha_id)) AS CHAR(2))  AS cohorte
    FROM ecomm.fact_ventas
    GROUP BY cliente_sk
),
actividad AS (
    SELECT
        fv.cliente_sk,
        pc.cohorte,
        CAST((
            (EXTRACT(YEAR  FROM fv.fecha_id)
              - EXTRACT(YEAR  FROM pc.fecha_primera_compra)) * 12
            + (EXTRACT(MONTH FROM fv.fecha_id)
              - EXTRACT(MONTH FROM pc.fecha_primera_compra))
        ) AS INTEGER)  AS periodo
    FROM ecomm.fact_ventas  fv
    JOIN primera_compra      pc ON fv.cliente_sk = pc.cliente_sk
)
SELECT
    cohorte,
    periodo,
    COUNT(DISTINCT cliente_sk)  AS clientes_activos
FROM actividad
GROUP BY cohorte, periodo
ORDER BY cohorte, periodo;
Glosario de Términos
| Termino | Definición |
|---|---|
| AMP | Access Module Processor. Unidad de procesamiento en Teradata responsable de un subconjunto de datos. |
| CDC | Change Data Capture. Técnica que captura solo los cambios desde la última ejecución ETL. |
| Conformed Dimension | Dimensión compartida entre múltiples fact tables o Data Marts con el mismo significado. |
| Data Mart | Subconjunto del DW orientado a un área de negocio especifica (Ventas, RRHH, Finanzas). |
| ELT | Extract, Load, Transform. Variante donde la transformación ocurre dentro del DW. |
| ETL | Extract, Transform, Load. Proceso de integración de datos hacia el DW. |
| Fact Table | Tabla central del modelo dimensional que contiene métricas cuantificables y claves foráneas. |
| Grain / Granularidad | Define que representa exactamente una fila en la fact table. |
| MPP | Massively Parallel Processing. Arquitectura donde múltiples nodos procesan datos en paralelo. |
| OLAP | Online Analytical Processing. Procesamiento de consultas analíticas complejas sobre datos históricos. |
| OLTP | Online Transaction Processing. Procesamiento de transacciones operativas en tiempo real. |
| PPI | Partition Primary Index. Técnica Teradata para particionar tablas y habilitar partition elimination. |
| SCD | Slowly Changing Dimension. Estrategia para manejar cambios en atributos de dimensiones en el tiempo. |
| SK / Surrogate Key | Clave técnica secuencial asignada en el DW, independiente de la clave del sistema fuente. |
| Staging Area | Zona de aterrizaje temporal donde los datos extraídos se depositan antes de ser transformados. |
Referencias Bibliográficas
Las siguientes son las fuentes que fundamentan el contenido técnico de este manual. Se incluyen únicamente obras canónicas de la industria y documentación oficial verificable.
Libros de referencia
Inmon, W. H. (2005). Building the Data Warehouse (4th ed.). Wiley. ISBN: 978-0-7645-9944-6.
Obra fundacional del enfoque Top-Down. Define las 4 características del DW y el Enterprise Data Warehouse. Fuente del Capitulo 1 y 2.
Kimball, R. y Ross, M. (2013). The Data Warehouse Toolkit: The Definitive Guide to Dimensional Modeling (3rd ed.). Wiley. ISBN: 978-1-118-53080-1.
Referencia principal para modelado dimensional, esquemas estrella y copo de nieve, SCD y Bus Architecture. Fuente de los capítulos 3 y 4.
Linstedt, D. y Olschimke, M. (2015). Building a Scalable Data Warehouse with Data Vault 2.0. Morgan Kaufmann. ISBN: 978-0-12-802510-9.
Referencia para la metodología Data Vault 2.0: Hubs, Links y Satellites. Fuente del capítulo 2.2.
Reis, J. y Housley, M. (2022). Fundamentals of Data Engineering. O’Reilly Media. ISBN: 978-1-098-10820-1.
Marco conceptual moderno: ciclo de vida del dato, batch vs streaming, ELT y Data Lakehouse. Fuente del capitulo 2.3 y 4.
Documentación oficial
Teradata Corporation. (2024). Teradata Database SQL Data Definition Language - Detailed Topics. Disponible en: docs.teradata.com
Referencia oficial de DDL, particionamiento PPI, Primary Index, Secondary Index y COLLECT STATISTICS. Fuente de los capítulos 6 y 7.
Teradata Corporation. (2024). Teradata Database SQL Functions, Operators, Expressions and Predicates. Disponible en: docs.teradata.com
Documentación de funciones analíticas (OVER, PARTITION BY, RANK, NTILE, LAG), QUALIFY y RANGE_N. Fuente de los ejercicios SQL de los capítulos 7 y 8.
IBM Corporation. (2024). IBM DataStage Documentation. Disponible en: ibm.com/docs/en/datastage
Manual oficial de IBM DataStage: arquitectura de jobs, tipos de stages, parallel processing y ejecución por línea de comandos. Fuente del capitulo 4.4.
Databricks. (2024). Lakehouse Architecture and Delta Lake. Disponible en: docs.databricks.com
Documentación oficial del patrón Lakehouse, Delta Lake, formato Parquet y ACID transactions. Fuente del capitulo 2.3.
Este manual es de elaboración propia con fines educativos. Los ejemplos SQL fueron desarrollados y probados sobre Teradata 16.x / 17.x. El schema e-Commerce usa la base ecomm, creada en los manuales anteriores de la serie. Serie: Nivel 1 (SQL Básico) | Nivel 2 (SQL Intermedio) | Nivel 3 (SQL Avanzado) | Nivel 4 (Teradata) | Nivel 5 (Data Warehouse) <- este manual
Archivos de práctica
Los scripts y recursos de este manual, para descargar y practicar en tu propio entorno.