Nivel 1 - Capitulo 1: Que es Hadoop y por que existe
Antes de ver que hace Hadoop, conviene entender el problema que intenta resolver.
1.1 El problema del Big Data
Imagina que tenemos una cadena de supermercados con 500 sucursales en todo el país. Cada sucursal registra miles de transacciones por día. Al cabo de un año, el volumen de datos es enorme: imágenes de cámaras, logs de sistemas, ventas, proveedores, reclamos de clientes. La pregunta es: ¿cómo procesamos todo eso de forma eficiente?
Se habla de Big Data cuando los datos tienen estas características (las 3 Vs):
Volumen: cantidades tan grandes que no caben en una sola maquina (TB, PB, EB)
Velocidad: se generan tan rápido que no alcanza con procesarlos de a poco
Variedad: son de distintos tipos: texto, imagenes, logs, JSON, CSV, etc.
Las bases de datos tradicionales (Oracle, SQL Server, Teradata standalone) están diseñadas para manejar grandes volúmenes, pero tienen un límite físico: si la maquina no tiene más RAM o disco, no podemos seguir escalando fácilmente. Hadoop toma un camino distinto.
1.2 La idea central de Hadoop
Hadoop divide el problema en partes más chicas y las distribuye entre muchas maquinas comunes (no se necesita hardware especial). Es como si en vez de tener un camión enorme que lleva toda la carga, tuvieras 100 autos que cada uno lleva una parte.
Pensar Hadoop como una biblioteca enorme:
- El catalogador (NameNode) sabe dónde esta cada libro
- Los estantes (DataNodes) guardan las copias físicas de los libros
- Los empleados (MapReduce/Spark) van a buscar y analizar los libros en paralelo
- El supervisor (YARN) asigna empleados a cada tarea según disponibilidad
1.3 Breve historia de Hadoop
| Ano | Hito |
|---|---|
| 2003 | Google publica paper sobre Google File System (GFS) |
| 2004 | Google publica paper sobre MapReduce |
| 2005 | Doug Cutting y Mike Cafarella crean Hadoop, inspirados en los papers de Google |
| 2006 | Hadoop se convierte en proyecto Apache oficial. Yahoo lo adopta masivamente |
| 2008 | Yahoo ordena 1 TB de datos con Hadoop en 209 segundos (record mundial) |
| 2012 | YARN se incorpora como gestor de recursos (Hadoop 2.0) |
| 2017 | Hadoop 3.0 con mejoras de almacenamiento y soporte para GPUs |
| Hoy | Base de muchos sistemas en la nube: AWS EMR, Google Dataproc, Azure HDInsight |
1.4 Los 4 módulos principales de Hadoop
Hadoop no es una sola herramienta, sino un conjunto de módulos que trabajan juntos:
-
Hadoop Common: librerías y utilitarios compartidos por todos los módulos
-
HDFS (Hadoop Distributed File System): el sistema de archivos distribuido
-
YARN (Yet Another Resource Negotiator): el gestor de recursos del cluster
-
MapReduce: el motor de procesamiento en paralelo
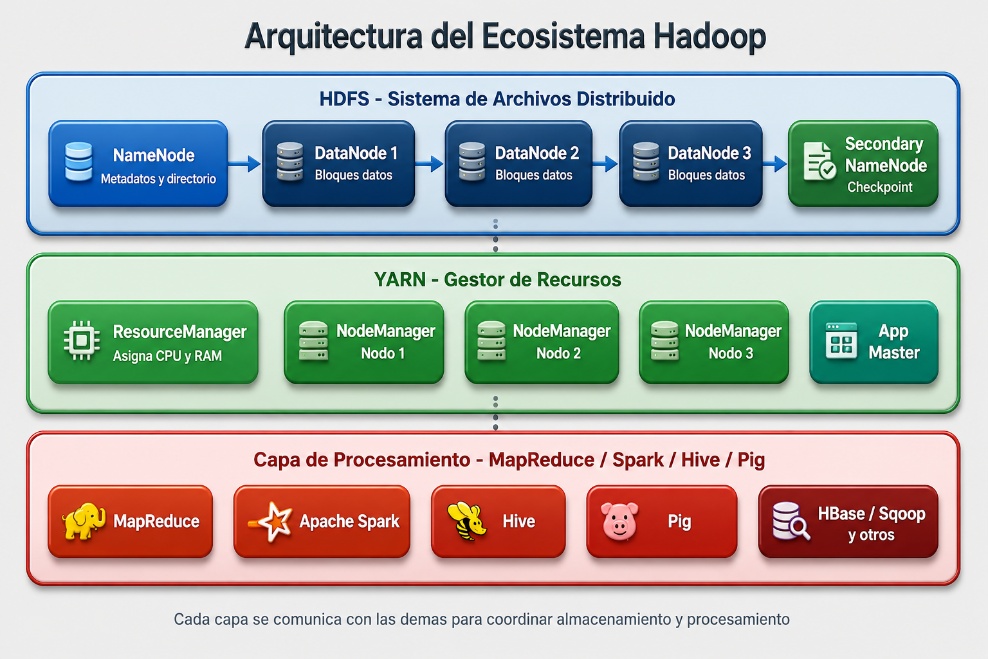
Figura 1: Arquitectura general del ecosistema Hadoop - capas apiladas
Hadoop NO es una base de datos. Es un sistema de almacenamiento y procesamiento distribuido.
No tiene un lenguaje de consulta propio como SQL (aunque Hive agrega esa capacidad).
Su fuerte es procesar grandes volúmenes de datos en lotes (batch processing).
Nivel 1 - Capitulo 2: HDFS - El Sistema de Archivos Distribuido
HDFS es el corazón de Hadoop. Es donde se guardan todos los datos. Entender cómo funciona es fundamental para trabajar con Hadoop.
2.1 Que es un sistema de archivos distribuido?
En una computadora común, los archivos se guardan en un disco rígido local. Si el disco se rompe, perdemos los datos. En un sistema distribuido, los archivos se dividen en bloques y se guardan en muchas maquinas al mismo tiempo. Si una maquina falla, los datos siguen disponibles en las otras.
2.2 Como HDFS divide y guarda los archivos
Cuando subimos un archivo a HDFS (por ejemplo, un CSV de 384 MB), HDFS lo divide automáticamente en bloques de 128 MB (por defecto). Esos bloques se distribuyen entre los DataNodes del cluster, y cada bloque se replica 3 veces en nodos diferentes.
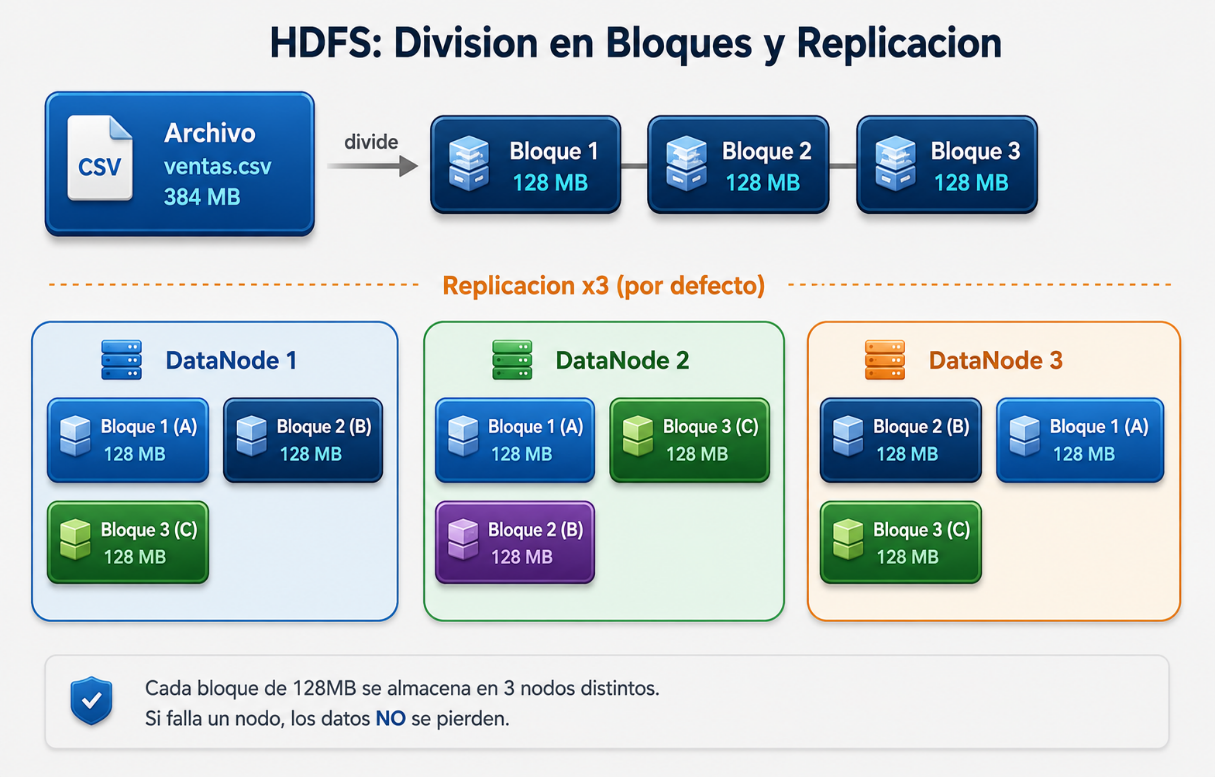
Figura 2: División de un archivo en bloques y replicación en 3 DataNodes
Es un balance entre overhead de red y granularidad de procesamiento.
Bloques muy chicos = demasiados metadatos que manejar
Bloques muy grandes = menos paralelismo al procesar
Se puede configurar según el caso de uso (64MB, 256MB, 512MB)
2.3 NameNode vs DataNode
HDFS tiene dos tipos de componentes con roles muy distintos:
| Componente | Función | Analogía |
|---|---|---|
| NameNode | Guarda los metadatos: que archivos existen, en que bloques se dividen y en que DataNodes están cada bloque | El índice de una biblioteca |
| DataNode | Guarda los bloques de datos reales. Hay muchos DataNodes (uno por nodo físico del cluster) | Los estantes con los libros |
| Secondary NameNode | NO es un NameNode de respaldo. Hace checkpoints del estado del NameNode para agilizar su recuperación | El asistente que archiva las notas del bibliotecario |
El Secondary NameNode NO reemplaza al NameNode si este falla.
Para alta disponibilidad real se usa NameNode HA con ZooKeeper (tema de nivel 3).
En entornos productivos, el NameNode es un punto de falla crítico y debe tener respaldo.
2.4 Comandos básicos de HDFS
HDFS tiene una interfaz de línea de comandos similar a Unix:
# Ver el contenido de un directorio en HDFS
hdfs dfs -ls /user/hadoop/datos
# Subir un archivo local a HDFS
hdfs dfs -put ventas_2025.csv /user/hadoop/datos/
# Descargar un archivo de HDFS al sistema local
hdfs dfs -get /user/hadoop/datos/ventas_2025.csv ./
# Crear un directorio en HDFS
hdfs dfs -mkdir -p /user/hadoop/datos/2025
# Ver el espacio usado
hdfs dfs -du -h /user/hadoop/datos
# Ver el factor de replicación de un archivo
hdfs fsck /user/hadoop/datos/ventas_2025.csv -files -blocksOrganizar HDFS con una estructura de directorios clara:
/raw/ → datos crudos recién ingestados
/staging/ → datos en proceso de transformación
/curated/ → datos limpios y listos para análisis
/archive/ → datos históricos de baja frecuencia de acceso
2.5 Tolerancia a fallos en HDFS
La replicación es el mecanismo clave de tolerancia a fallos. Si un DataNode falla, el NameNode detecta que algunos bloques quedaron con menos réplicas de las configuradas y ordena a los DataNodes sanos que generen nuevas copias. Este proceso se llama re-replication y es completamente automático.
La fórmula para saber cuántos fallos puede tolerar es:
Fallos tolerados = Factor de replicación - 1
Con factor 3: tolera la falla de 2 nodos (los datos siguen en el 3ro)
Con factor 1: ningún fallo tolerado (no se recomienda para producción)
Nivel 1 - Capitulo 3: MapReduce - Procesamiento en Paralelo
MapReduce es el paradigma de programación que usa Hadoop para procesar grandes volúmenes de datos. La idea es simple pero poderosa: dividir el problema, procesar en paralelo, y combinar resultados.
3.1 La filosofía de MapReduce
En vez de mover todos los datos a donde está el código, MapReduce mueve el código a donde están los datos. Esto es clave cuando tenemos petabytes: es mucho más rápido enviar un programa de 10 KB a cada nodo que mover terabytes de datos a un servidor central.
“Mover el computo a los datos, no los datos al cómputo” Este principio reduce drásticamente el tráfico de red en un cluster.
Cada DataNode procesa los bloques que ya tiene almacenados localmente.
3.2 Las tres fases de MapReduce
Todo trabajo de MapReduce pasa por estas fases:
-
MAP: Cada Mapper toma una porción de los datos de entrada y emite pares clave-valor
-
SHUFFLE & SORT: Hadoop agrupa y ordena todos los pares por clave automáticamente
-
REDUCE: Cada Reducer recibe todos los valores de una clave y los procesa juntos
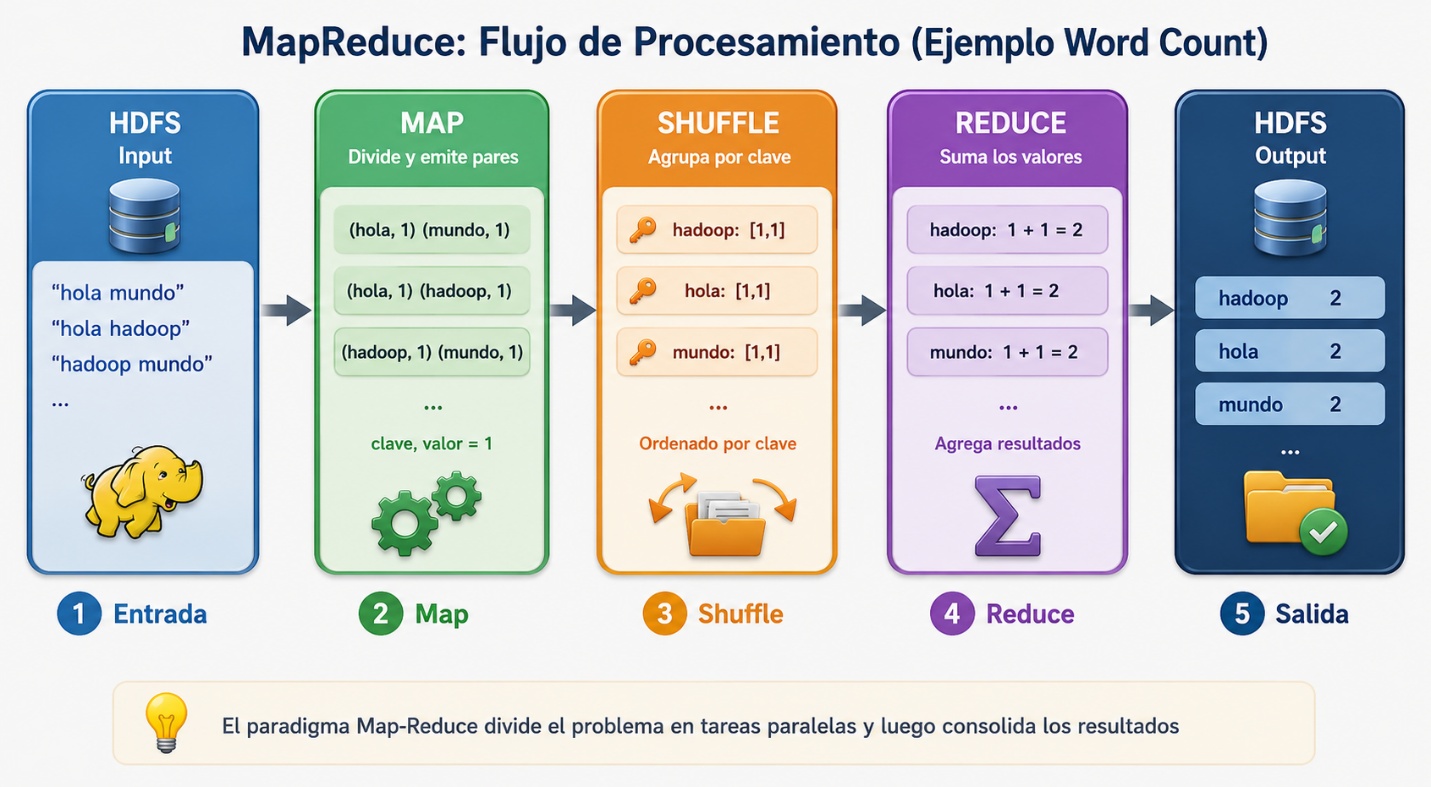
Figura 3: Flujo completo de MapReduce con ejemplo de conteo de palabras
3.3 Ejemplo práctico: contar ventas por categoría
Supongamos que tenemos un CSV con millones de filas de ventas y queremos saber cuánto vendió cada categoría:
# Datos de entrada (simplificado):
Electronica,laptop,1200.00
Ropa,remera,45.00
Electronica,celular,800.00
Ropa,pantalon,90.00
Electronica,auriculares,150.00
# Fase MAP - emite (categoria, monto):
(Electronica, 1200.00)
(Ropa, 45.00)
(Electronica, 800.00)
(Ropa, 90.00)
(Electronica, 150.00)
# Fase SHUFFLE - agrupa por clave:
Electronica: [1200.00, 800.00, 150.00]
Ropa: [45.00, 90.00]
# Fase REDUCE - suma por categoria:
Electronica 2150.00
Ropa 135.00MapReduce es ideal para trabajos batch (no tiempo real) como:
- Generación de reportes históricos
- Transformación masiva de datos (ETL)
- Calculo de agregaciones sobre volúmenes enormes
- Indexación de contenido (como hace Google)
3.4 Limitaciones de MapReduce
MapReduce fue revolucionario, pero tiene desventajas importantes:
-
Escribe resultados intermedios en disco entre cada fase (lento)
-
No es adecuado para procesamiento iterativo (como algoritmos de machine learning)
-
Latencia alta: no sirve para consultas interactivas en tiempo real
-
Código verbose: escribir un job en Java requiere bastante boilerplate
Apache Spark resuelve estas limitaciones procesando en memoria (RAM).
Puede ser hasta 100x más rápido que MapReduce para cargas iterativas.
Veremos Spark en el Nivel 2 como parte del ecosistema Hadoop.
Nivel 1 - Capitulo 4: YARN - El Gestor de Recursos
YARN (Yet Another Resource Negotiator) es el sistema que decide cómo se reparten la CPU y la memoria RAM del cluster entre los distintos trabajos que quieren ejecutarse.
4.1 Porque nació YARN
En Hadoop 1.x, MapReduce hacia dos cosas a la vez: gestionaba los recursos del cluster Y ejecutaba los trabajos. Esto tenía un problema: si quería usar Spark u otras herramientas sobre HDFS, no había forma de coordinar los recursos entre ellas. YARN nace en Hadoop 2.x para separar estas responsabilidades.
| Hadoop 1.x (sin YARN) | Hadoop 2.x+ (con YARN) | |
|---|---|---|
| Gestión de recursos | MapReduce lo hacia todo | YARN gestiona los recursos |
| Procesamiento | Solo MapReduce | MapReduce, Spark, Tez, y otros |
| Concurrencia | Un job a la vez por tipo | Múltiples frameworks simultáneos |
| Escalabilidad | Hasta ~4000 nodos | Hasta 10000+ nodos |
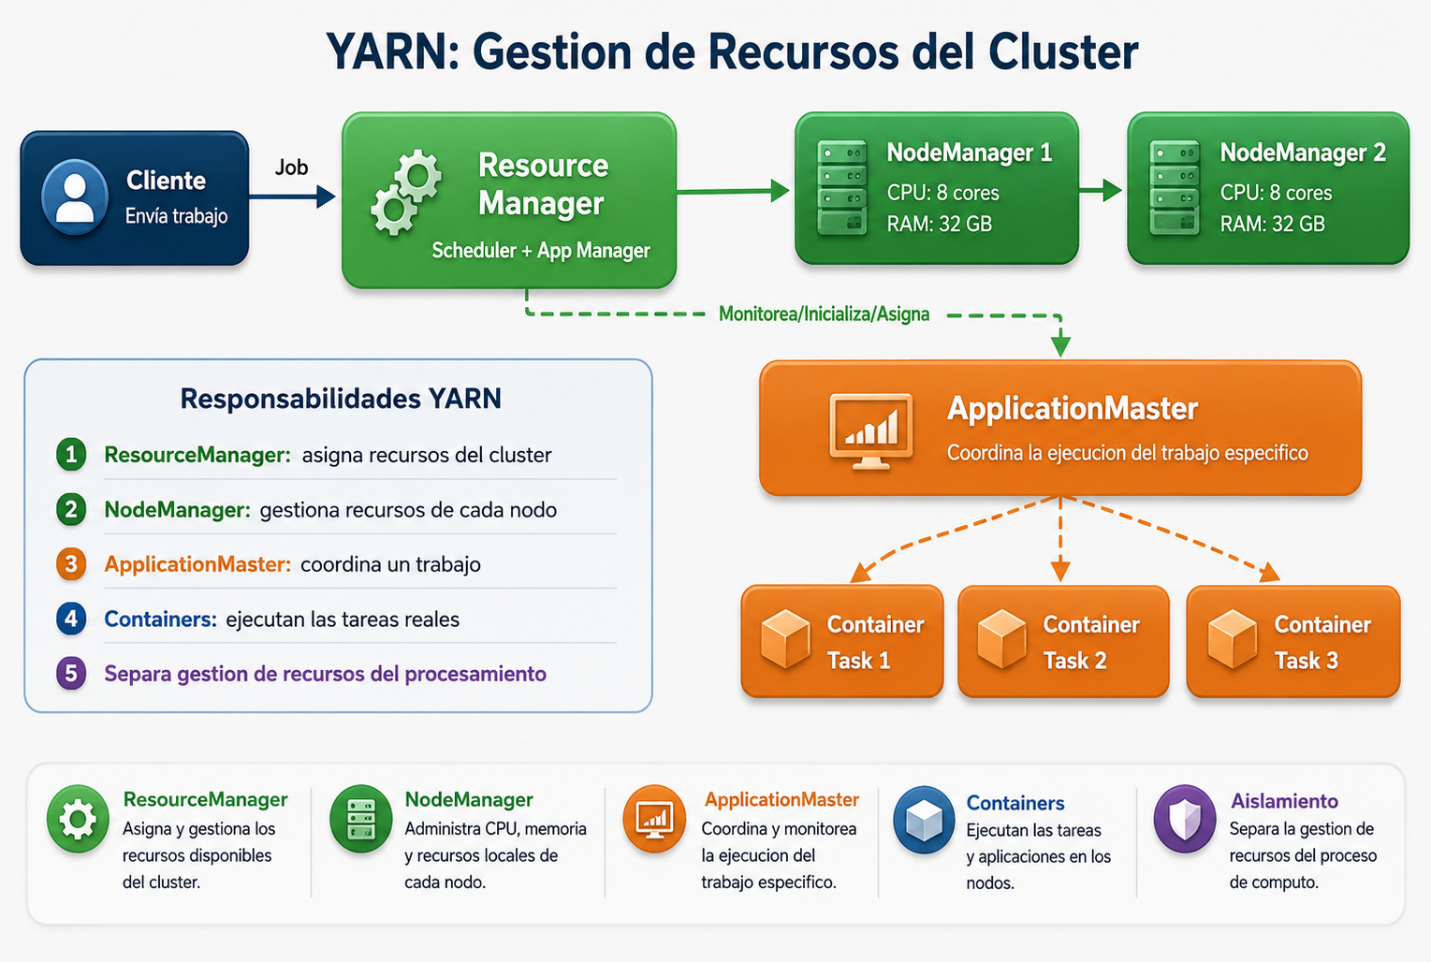
Figura 4: Arquitectura YARN y flujo de asignacion de recursos
4.2 Componentes de YARN
YARN tiene 4 componentes principales:
-
ResourceManager (RM): el jefe del cluster. Sabe cuántos recursos (CPU y RAM) tiene disponibles en total y los asigna a los trabajos que lo soliciten. Solo hay uno por cluster.
-
NodeManager (NM): hay uno en cada nodo worker. Reporta al RM cuantos recursos tiene disponibles y lanza los contenedores cuando el RM se lo indica.
-
ApplicationMaster (AM): se crea uno por cada trabajo que se ejecuta. Su tarea es negociar recursos con el RM y coordinar la ejecución de las tareas del trabajo específico.
-
Container: la unidad básica de ejecución. Es una porción de CPU y RAM asignada en un nodo específico para ejecutar una tarea concreta.
4.3 Flujo de ejecución de un trabajo
Cuando un usuario envía un trabajo a Hadoop, el flujo es el siguiente:
-
El cliente envía la solicitud al ResourceManager
-
El RM busca un nodo con recursos disponibles y lanza el ApplicationMaster
-
El ApplicationMaster analiza el trabajo y solicita Containers al RM
-
El RM asigna Containers en los NodeManagers disponibles
-
Las tareas se ejecutan dentro de esos Containers
-
El AM reporta el progreso al cliente y al RM
-
Al finalizar, los Containers se liberan y los recursos vuelven al pool
Nivel 2 - Capitulo 5: El Ecosistema Hadoop
Hadoop en sí mismo es una base. Sobre ella se construyó un ecosistema enorme de herramientas especializadas, cada una resolviendo un problema concreto. En la industria, cuando alguien dice ‘usamos Hadoop’, generalmente se refiere a este ecosistema completo.
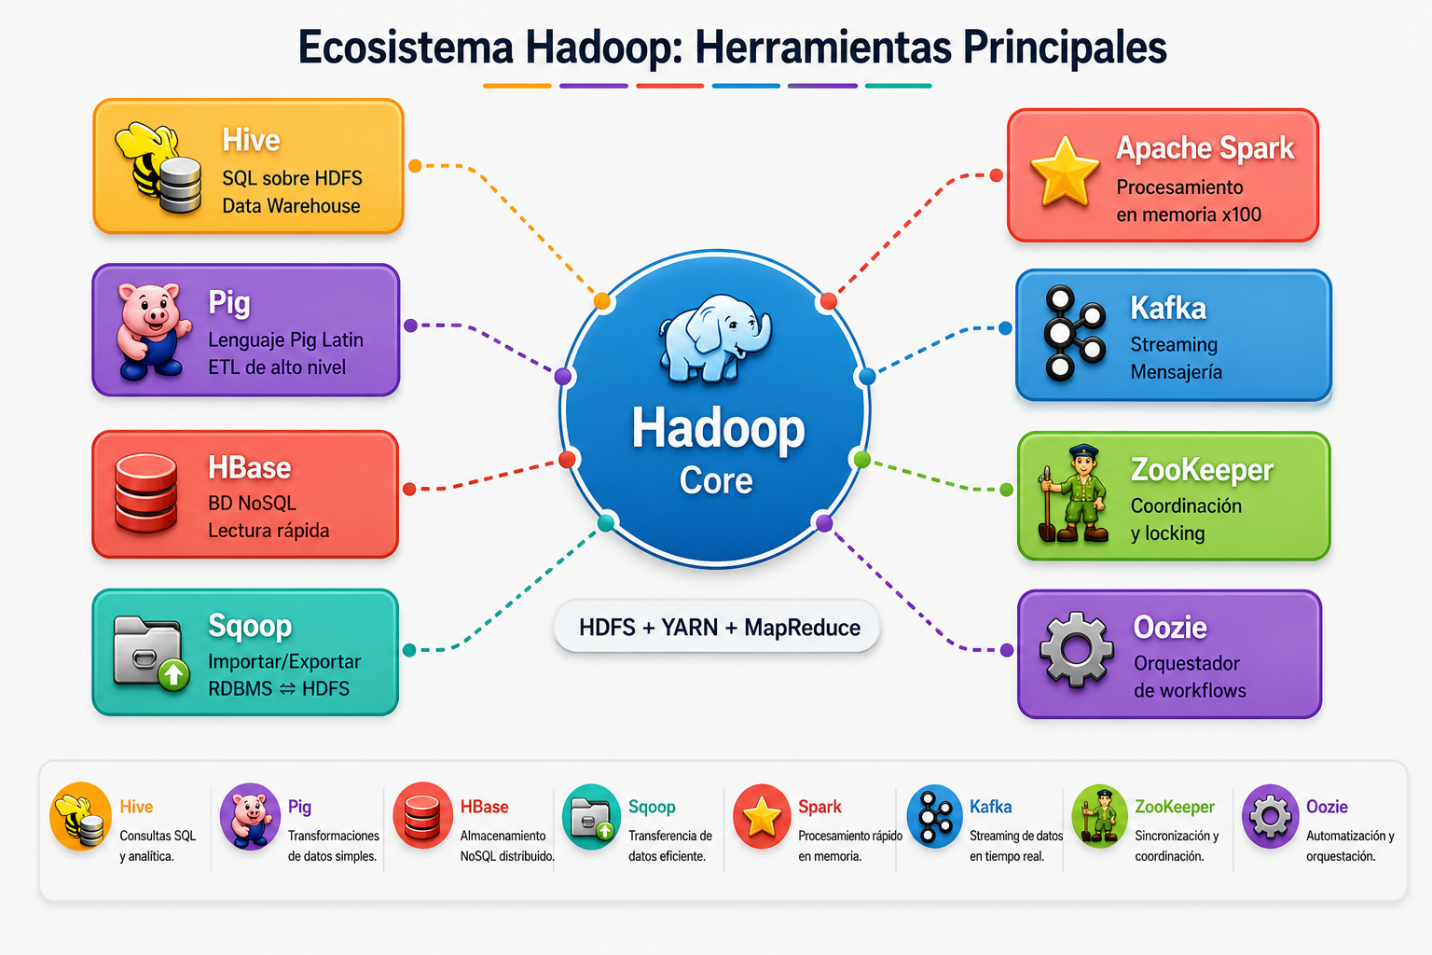
Figura 5: Herramientas del ecosistema Hadoop y su relación con el core
5.1 Hive - SQL sobre Big Data
Hive permite escribir consultas en un dialecto de SQL (llamado HiveQL) que Hadoop traduce internamente a trabajos de MapReduce o Tez. Es ideal para analistas que ya saben SQL y no quieren aprender Java.
-- Crear una tabla en Hive apuntando a datos en HDFS
CREATE EXTERNAL TABLE ventas (
fecha STRING,
categoria STRING,
producto STRING,
monto DOUBLE
)
ROW FORMAT DELIMITED
FIELDS TERMINATED BY ','
STORED AS TEXTFILE
LOCATION '/datos/ventas/';
-- Consultar ventas por categoría (se ejecuta como MapReduce
internamente)
SELECT categoria,
COUNT(*) AS cantidad_ventas,
SUM(monto) AS total_vendido
FROM ventas
WHERE fecha >= '2025-01-01'
GROUP BY categoria
ORDER BY total_vendido DESC;| Característica | Detalle |
|---|---|
| Lenguaje | HiveQL (muy similar a SQL estándar) |
| Motor de ejecución | MapReduce, Tez o Spark (configurable) |
| Caso de uso | Data warehousing, reportes batch, análisis histórico |
| Limitación | Latencia alta (no apto para queries interactivos rápidos) |
| Alternativa moderna | Apache Impala o Spark SQL para queries mas rápidos |
5.2 Apache Spark - Procesamiento en Memoria
Spark es hoy en día la herramienta de procesamiento más popular del ecosistema. A diferencia de MapReduce, trabaja en memoria RAM siempre que sea posible, lo que lo hace drásticamente mas rápido para cargas iterativas.
MapReduce: cada fase escribe en disco. Para 10 iteraciones → 10 lecturas/escrituras de disco
Spark: mantiene los datos en RAM entre iteraciones → hasta 100x mas rápido
Spark también soporta streaming, SQL (Spark SQL), ML (MLlib) y grafos (GraphX)
# Ejemplo en PySpark (Python + Spark)
from pyspark.sql import SparkSession
# Iniciar sesion de Spark
spark = SparkSession.builder \
.appName('analisis_ventas') \
.getOrCreate()
# Leer datos desde HDFS
df = spark.read.csv('hdfs:///datos/ventas/', header=True,
inferSchema=True)
# Analisis: ventas por categoria
from pyspark.sql.functions import sum, count
resultado = df.groupBy('categoria') \
.agg(count('*').alias('cantidad'),
sum('monto').alias('total')) \
.orderBy('total', ascending=False)
resultado.show()
5.3 Sqoop - Importar y Exportar datos
Sqoop (SQL-to-Hadoop) es la herramienta para mover datos entre bases de datos relacionales (Oracle, SQL Server, Teradata, MySQL) y HDFS. Es el puente entre el mundo relacional y el mundo Hadoop.
# Importar tabla completa desde SQL Server a HDFS
sqoop import \
--connect 'jdbc:sqlserver://servidor:1433;database=ventas' \
--username usuario \
--password clave \
--table PEDIDOS \
--target-dir /datos/raw/pedidos \
--num-mappers 4
# Importar solo registros nuevos (incremental)
sqoop import \
--connect 'jdbc:sqlserver://servidor:1433;database=ventas' \
--username usuario \
--password clave \
--table PEDIDOS \
--incremental append \
--check-column FECHA_PEDIDO \
--last-value '2025-12-31' \
--target-dir /datos/raw/pedidos
Sqoop soporta Teradata como origen y destino vía el conector JDBC de Teradata.
Para importaciones masivas, se recomienda ajustar —num-mappers según el paralelismo disponible.
Teradata Connector for Hadoop (TDCH) es la alternativa oficial de Teradata para mayor rendimiento.
5.4 HBase - Base de Datos NoSQL sobre HDFS
HBase es una base de datos NoSQL de tipo columnas que corre sobre HDFS. A diferencia de las consultas batch de MapReduce, HBase esta optimizada para lecturas y escrituras en tiempo real de registros individuales.
| Aspecto | HBase | HDFS / Hive |
|---|---|---|
| Tipo de acceso | Aleatorio (por clave) | Secuencial (scan completo) |
| Latencia | Milisegundos | Segundos a minutos |
| Caso de uso | Perfil de usuario en tiempo real, historial de eventos | Análisis histórico, reportes batch |
| Modelo de datos | Tabla con filas, familias de columnas y versiones | Tabla o archivos planos |
| Escala | Millones de filas con acceso rápido | Petabytes con acceso batch |
5.5 Oozie - Orquestador de Workflows
Oozie es el equivalente a Control-M dentro del ecosistema Hadoop. Permite definir y ejecutar workflows que encadenan multiples jobs: primero Sqoop importa datos, luego un job de Hive los transforma, luego Spark genera el reporte, y así.
Si ya conoces Control-M, podes pensar en Oozie así:
Control-M Job = Oozie Action (una tarea: Hive, Spark, Shell, etc.)
Control-M Flow = Oozie Workflow (secuencia de acciones con dependencias)
Control-M Cyclic = Oozie Coordinator (ejecutar workflow cada N tiempo)
Control-M Folder = Oozie Bundle (agrupar coordinators relacionados)
Nivel 2 - Capitulo 6: Hadoop vs Otras Tecnologias
Hadoop no vive en aislamiento. Es importante entender cuando usarlo y cuando no, y como se compara con otras soluciones que ya conocemos.
6.1 Hadoop vs RDBMS Tradicional
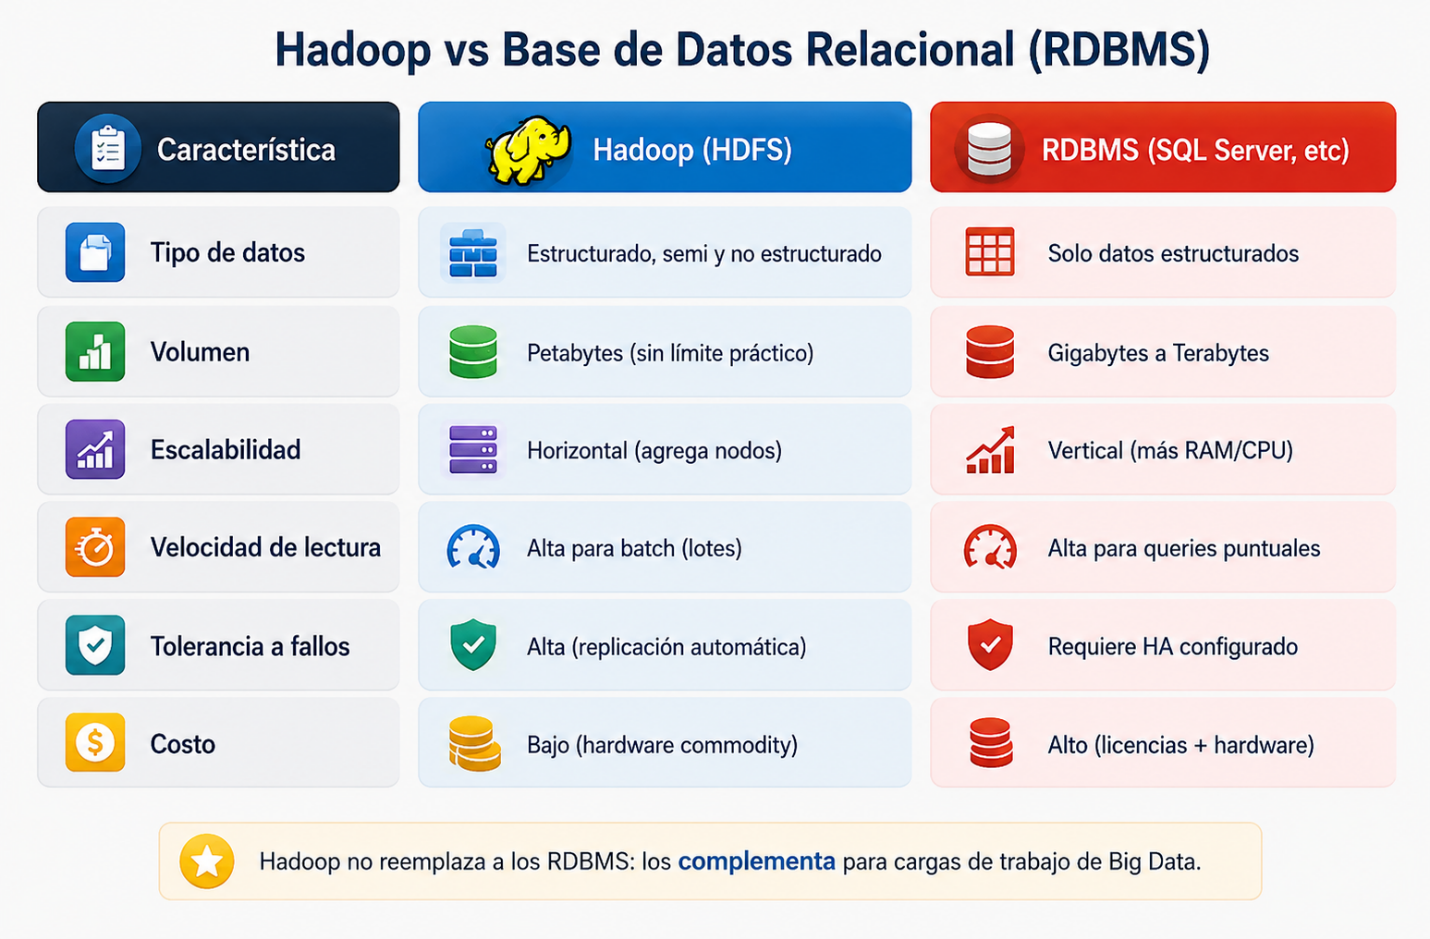
Figura 6: Comparación entre Hadoop y bases de datos relacionales tradicionales
Para datos transaccionales (OLTP) con muchos updates/deletes, usar RDBMS.
Para análisis histórico de grandes volúmenes, usar Hadoop.
En la mayoría de las empresas, ambos coexisten y se complementan.
Sqoop es la herramienta para mover datos entre ambos mundos.
6.2 Hadoop vs Data Warehouse (Teradata, Redshift)
Los Data Warehouses tradicionales como Teradata son excelentes para consultas SQL complejas y tienen motores de query muy optimizados. Hadoop tiene ventajas en costo y flexibilidad de datos:
| Criterio | Teradata / DW Tradicional | Hadoop |
|---|---|---|
| Costo por TB | Alto (licencia + hardware dedicado) | Bajo (hardware commodity) |
| Velocidad de query | Muy alta (optimizador maduro) | Variable (depende de herramienta) |
| Tipos de datos | Principalmente estructurados | Estructurados, semi y no estructurados |
| Schema | Schema-on-write (al cargar) | Schema-on-read (al leer) |
| Latencia | Segundos para consultas complejas | Segundos a minutos (Hive/MapReduce) |
| Actualizaciones | Soporte completo DML | Limitado (HDFS es append-only) |
-
Los datos raw llegan a HDFS (barato, flexible)
-
Se procesan y transforman con Spark/Hive
-
Los datos curados y agregados se cargan al DW (Teradata, Redshift)
-
Los analistas hacen queries SQL sobre el DW
Este patrón se llama Lambda Architecture o Data Lake + Data Warehouse
6.3 Hadoop en la Nube
Con el auge del cloud computing, muchas empresas ya no instalan Hadoop on-premise sino que usan servicios gestionados en la nube:
| Proveedor | Servicio | Descripcion |
|---|---|---|
| Amazon AWS | EMR (Elastic MapReduce) | Cluster Hadoop/Spark gestionado. Se paga por hora de uso |
| Google Cloud | Dataproc | Hadoop/Spark gestionado. Integración nativa con BigQuery |
| Microsoft Azure | HDInsight | Hadoop/Spark/Hive gestionado en Azure |
| Cloudera (on-prem) | CDP (Data Platform) | Distribución Enterprise de Hadoop con soporte comercial |
La mayoría de las empresas nuevas usan Hadoop en la nube (EMR, Dataproc).
Las empresas con datos sensibles o regulación estricta mantienen clusters on-premise.
Apache Spark en la nube esta reemplazando a MapReduce en muchos casos de uso.
Los Data Lakehouses (Delta Lake, Apache Iceberg) combinan lo mejor de Data Lake y DW.
Nivel 2 - Capitulo 7: Instalación y Configuración Básica
En este capítulo vemos como instalar Hadoop en modo pseudo-distribuido (una sola máquina que simula un cluster). Es el entorno ideal para aprender antes de trabajar con un cluster real.
7.1 Modos de ejecución de Hadoop
| Modo | Descripción | Uso |
|---|---|---|
| Local (Standalone) | Todo en un solo proceso Java, sin HDFS. Para debugging rápido | Desarrollo y testing |
| Pseudo-distribuido | Un solo nodo pero con HDFS y YARN activos como si fuera un cluster real | Aprendizaje y desarrollo |
| Totalmente distribuido | Múltiples nodos reales o VMs. Entorno productivo | Producción |
7.2 Pre-requisitos
Para instalar Hadoop se necesita:
-
Java JDK 8 o 11 (Hadoop está escrito en Java)
-
SSH configurado para login sin password (Hadoop se conecta a sus propios nodos vía SSH)
-
Al menos 4 GB de RAM para modo pseudo-distribuido
-
Sistema operativo Linux o macOS
-
En Windows se usa WSL2 o Docker - link para instalación de Docker : https://docs.docker.com/desktop/setup/install/windows-install/ )
# Verificar Java instalado
java -version
# Deberia mostrar: openjdk version '11.x.x' o '1.8.x'
# Instalar Java (Ubuntu/Debian)
sudo apt update
sudo apt install openjdk-11-jdk -y
# Configurar SSH sin password (para el propio host)
ssh-keygen -t rsa -P '' -f ~/.ssh/id_rsa
cat ~/.ssh/id_rsa.pub >> ~/.ssh/authorized_keys
chmod 0600 ~/.ssh/authorized_keys
# Verificar SSH local
ssh localhost
7.3 Descarga e instalación
# Descargar Hadoop 3.3.x desde Apache
wget
https://downloads.apache.org/hadoop/common/hadoop-3.3.6/hadoop-3.3.6.tar.gz
# Descomprimir
tar -xzf hadoop-3.3.6.tar.gz
sudo mv hadoop-3.3.6 /usr/local/hadoop
# Configurar variables de entorno en ~/.bashrc
export HADOOP_HOME=/usr/local/hadoop
export HADOOP_INSTALL=$HADOOP_HOME
export HADOOP_MAPRED_HOME=$HADOOP_HOME
export HADOOP_COMMON_HOME=$HADOOP_HOME
export HADOOP_HDFS_HOME=$HADOOP_HOME
export YARN_HOME=$HADOOP_HOME
export HADOOP_COMMON_LIB_NATIVE_DIR=$HADOOP_HOME/lib/native
export PATH=$PATH:$HADOOP_HOME/sbin:$HADOOP_HOME/bin
export JAVA_HOME=$(readlink -f /usr/bin/java | sed
's:/bin/java::')
# Aplicar los cambios
source ~/.bashrc
# Verificar instalacion
hadoop version
7.4 Archivos de configuración clave
Hadoop se configura a través de archivos XML ubicados en $HADOOP_HOME/etc/hadoop/. Los más importantes son:
# core-site.xml - URI del filesystem y configuracion base

fs.defaultFS
hdfs://localhost:9000

# hdfs-site.xml - Factor de replicacion y rutas de datos

dfs.replication
1

dfs.namenode.name.dir
/usr/local/hadoop/data/namenode

dfs.datanode.data.dir
/usr/local/hadoop/data/datanode
# yarn-site.xml - Configuracion del ResourceManager
yarn.nodemanager.aux-services
mapreduce_shuffle
yarn.nodemanager.env-whitelist
JAVA_HOME,HADOOP_COMMON_HOME,HADOOP_HDFS_HOME,HADOOP_CONF_DIR,CLASSPATH_PREPEND_DISTCACHE,HADOOP_YARN_HOME,HADOOP_MAPRED_HOME7.5 Iniciar y detener el cluster
# Formatear el NameNode (solo la primera vez)
hdfs namenode -format
# Iniciar HDFS (NameNode + DataNode)
start-dfs.sh
# Iniciar YARN (ResourceManager + NodeManager)
start-yarn.sh
# Verificar que todos los procesos estén corriendo
jps
# Deberia mostrar:
# NameNode
# DataNode
# SecondaryNameNode
# ResourceManager
# NodeManager
# Interfaces web disponibles:
# HDFS NameNode UI: http://localhost:9870
# YARN ResourceManager UI: http://localhost:8088
# Detener todo
stop-yarn.sh
stop-dfs.sh
Nivel 2 - Capitulo 8: Ejercicios Prácticos con Cloudera VM
En este capítulo practicamos todo lo aprendido en un entorno real: la Cloudera QuickStart VM corriendo sobre VMware Workstation Player 17. Usamos el dataset completo de TechStore (los mismos CSVs de la serie de manuales JAVIESCA) y ejecutamos el flujo completo HDFS → Hive vía Hue.
- VMware Workstation Player 17 con Cloudera QuickStart VM (CDH 5.x)
- Se puede descargar desde https://downloads.cloudera.com/demo_vm/virtualbox/cloudera-quickstart-vm-5.13.0-0-virtualbox.zip
- Hue accesible en http://quickstart.cloudera:8888 — login: cloudera / cloudera
- 6 CSVs del dataset TechStore copiados a /home/cloudera/datasets/
- HDFS activo — hdfs dfs -ls / devuelve /benchmarks /hbase /solr /tmp /user /var
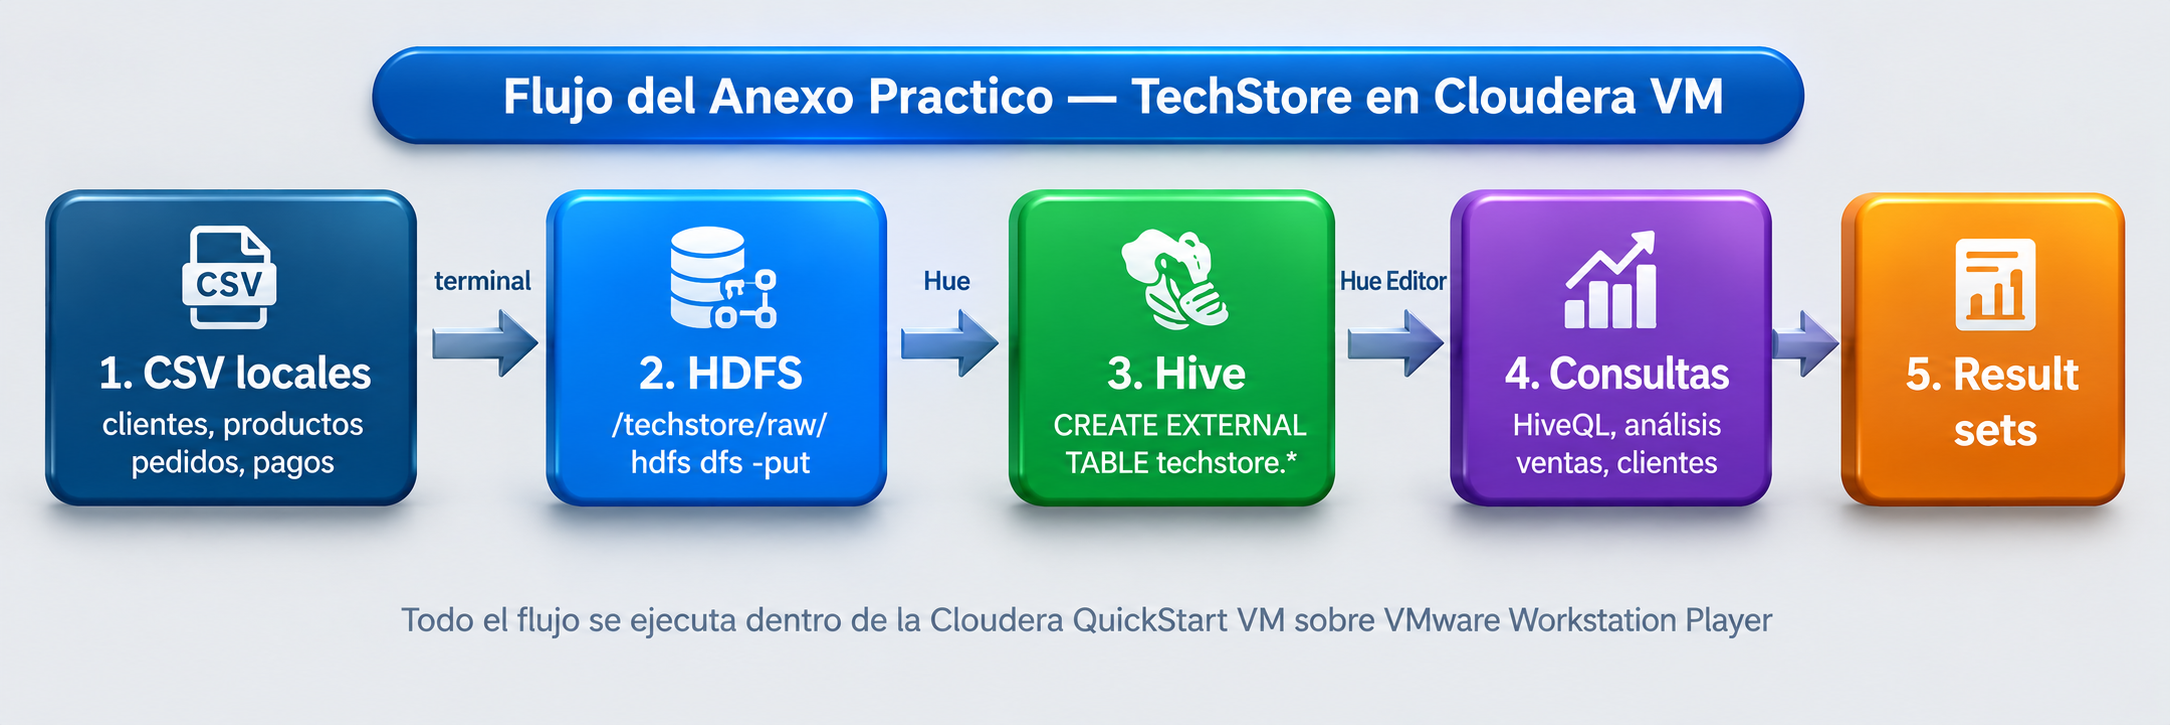
Figura 8.1: Flujo completo del anexo — de los CSV locales a las consultas en Hue
8.1 Estructura HDFS para TechStore
El primer paso es crear un directorio por tabla en HDFS. Hive necesita que cada tabla apunte a su propio directorio.
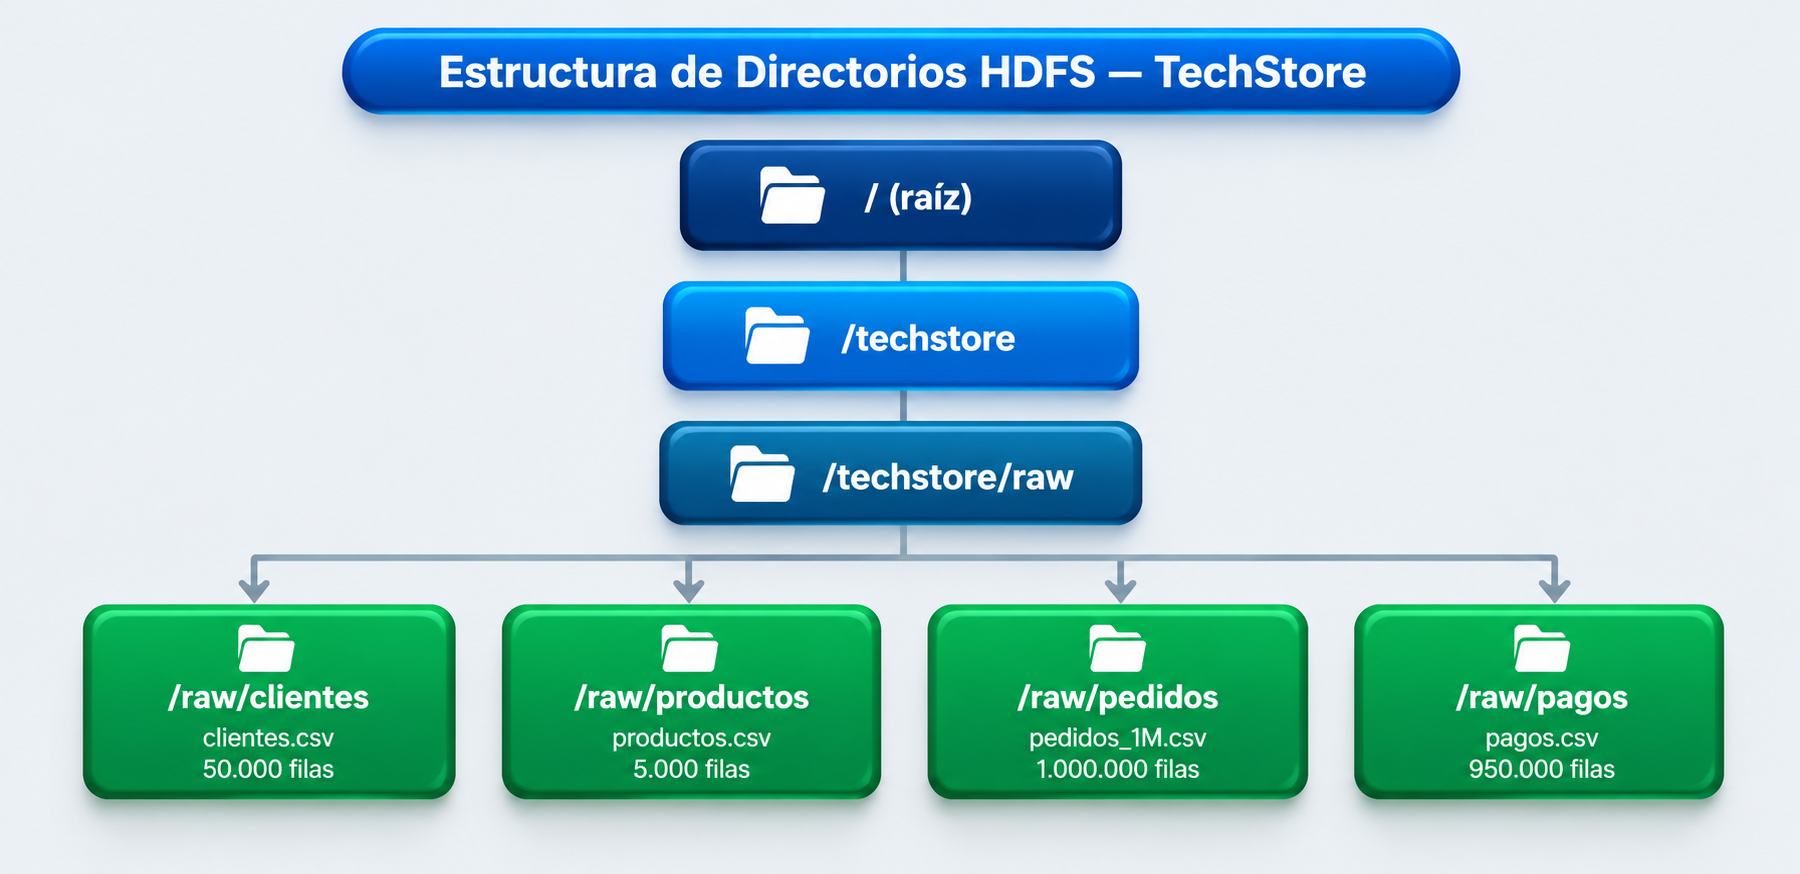
Figura 8.2: Estructura de directorios HDFS que vamos a crear para TechStore
# Crear la estructura de directorios en HDFS
hdfs dfs -mkdir -p /techstore/raw/clientes
hdfs dfs -mkdir -p /techstore/raw/productos
hdfs dfs -mkdir -p /techstore/raw/pedidos
hdfs dfs -mkdir -p /techstore/raw/pagos

# Verificar
hdfs dfs -ls /techstore/raw/
# Found 4 items
# drwxr-xr-x  - cloudera supergroup  0 ... /techstore/raw/clientes
# drwxr-xr-x  - cloudera supergroup  0 ... /techstore/raw/pagos
# drwxr-xr-x  - cloudera supergroup  0 ... /techstore/raw/pedidos
# drwxr-xr-x  - cloudera supergroup  0 ... /techstore/raw/productos
8.2 Subir los CSVs a HDFS
Con los 6 CSVs en /home/cloudera/datasets/, los subimos a sus directorios correspondientes:
hdfs dfs -put /home/cloudera/datasets/clientes.csv   /techstore/raw/clientes/
hdfs dfs -put /home/cloudera/datasets/productos.csv  /techstore/raw/productos/
hdfs dfs -put /home/cloudera/datasets/pedidos_1M.csv /techstore/raw/pedidos/
hdfs dfs -put /home/cloudera/datasets/pagos.csv      /techstore/raw/pagos/

# Verificar el header de pedidos (1 millon de filas)
hdfs dfs -cat /techstore/raw/pedidos/pedidos_1M.csv | head -2
# pedido_id,cliente_id,producto_id,fecha_pedido,cantidad,precio_unitario,
# descuento_pct,monto_bruto,monto_descuento,monto_total,estado,canal,region,tiempo_entregaHive mapea cada tabla EXTERNAL a un directorio de HDFS. Si ponemos todos los CSV juntos en /techstore/raw/, Hive no puede separarlos. Un directorio por tabla = una tabla Hive por directorio. Es la convención estándar.
8.3 Crear la base de datos y tablas en Hive
Desde el editor Hive de Hue (Query → Editor → Hive), ejecutar de a una sentencia:

Figura 8.3: Esquema de las 4 tablas Hive apuntando a los directorios HDFS
-- Base de datos
CREATE DATABASE IF NOT EXISTS techstore
COMMENT 'Dataset e-commerce TechStore';

USE techstore;

-- Tabla clientes (50.000 filas)
CREATE EXTERNAL TABLE IF NOT EXISTS clientes (
    cliente_id   INT,
    nombre       STRING,
    email        STRING,
    pais         STRING,
    region       STRING,
    ciudad       STRING,
    segmento     STRING,
    fecha_alta   STRING,
    genero       STRING,
    activo       INT
)
ROW FORMAT DELIMITED
FIELDS TERMINATED BY ','
STORED AS TEXTFILE
LOCATION '/techstore/raw/clientes/'
TBLPROPERTIES ('skip.header.line.count'='1');

-- Tabla productos (5.000 filas)
CREATE EXTERNAL TABLE IF NOT EXISTS productos (
    producto_id  INT,
    nombre       STRING,
    categoria    STRING,
    subcategoria STRING,
    marca        STRING,
    precio_base  DOUBLE,
    costo        DOUBLE,
    activo       INT
)
ROW FORMAT DELIMITED
FIELDS TERMINATED BY ','
STORED AS TEXTFILE
LOCATION '/techstore/raw/productos/'
TBLPROPERTIES ('skip.header.line.count'='1');

-- Tabla pedidos (1.000.000 filas)
CREATE EXTERNAL TABLE IF NOT EXISTS pedidos (
    pedido_id       INT,
    cliente_id      INT,
    producto_id     INT,
    fecha_pedido    STRING,
    cantidad        INT,
    precio_unitario DOUBLE,
    descuento_pct   INT,
    monto_bruto     DOUBLE,
    monto_descuento DOUBLE,
    monto_total     DOUBLE,
    estado          STRING,
    canal           STRING,
    region          STRING,
    tiempo_entrega  INT
)
ROW FORMAT DELIMITED
FIELDS TERMINATED BY ','
STORED AS TEXTFILE
LOCATION '/techstore/raw/pedidos/'
TBLPROPERTIES ('skip.header.line.count'='1');

-- Tabla pagos (~950.000 filas)
CREATE EXTERNAL TABLE IF NOT EXISTS pagos (
    pago_id      INT,
    pedido_id    INT,
    cliente_id   INT,
    fecha_pago   STRING,
    monto_pagado DOUBLE,
    metodo_pago  STRING,
    cuotas       INT,
    estado_pago  STRING
)
ROW FORMAT DELIMITED
FIELDS TERMINATED BY ','
STORED AS TEXTFILE
LOCATION '/techstore/raw/pagos/'
TBLPROPERTIES ('skip.header.line.count'='1');

-- Confirmar las 4 tablas
SHOW TABLES;
8.4 Consultas HiveQL sobre TechStore
Con las tablas creadas, ejecutar estas consultas desde el editor Hive de Hue. Cada una se traduce internamente a un job de MapReduce visible en http://quickstart.cloudera:8088.
USE techstore;

-- Q01: Conteo de filas por tabla
SELECT 'clientes'  AS tabla, COUNT(*) AS filas FROM clientes  UNION ALL
SELECT 'productos' AS tabla, COUNT(*) AS filas FROM productos UNION ALL
SELECT 'pedidos'   AS tabla, COUNT(*) AS filas FROM pedidos   UNION ALL
SELECT 'pagos'     AS tabla, COUNT(*) AS filas FROM pagos;

-- Q02: Distribución de clientes por segmento
SELECT   segmento,
         COUNT(*)                            AS cantidad,
         ROUND(COUNT(*) * 100.0 / 50000, 1) AS porcentaje
FROM     clientes
GROUP BY segmento
ORDER BY cantidad DESC;

-- Q03: Ventas por canal (excluyendo cancelados)
SELECT   canal,
         COUNT(*)                   AS pedidos,
         ROUND(SUM(monto_total), 2) AS venta_total,
         ROUND(AVG(monto_total), 2) AS ticket_promedio
FROM     pedidos
WHERE    estado != 'CANCELADO'
GROUP BY canal
ORDER BY venta_total DESC;

-- Q04: Ventas por categoría de producto (JOIN)
SELECT   pr.categoria,
         COUNT(pe.pedido_id)          AS pedidos,
         ROUND(SUM(pe.monto_total),2) AS venta_total
FROM     pedidos  pe
JOIN     productos pr ON pe.producto_id = pr.producto_id
WHERE    pe.estado != 'CANCELADO'
GROUP BY pr.categoria
ORDER BY venta_total DESC;

-- Q05: Resumen ejecutivo — monto pedido vs cobrado por región
SELECT   pe.region,
         COUNT(DISTINCT pe.pedido_id)  AS pedidos,
         ROUND(SUM(pe.monto_total),2)  AS monto_pedido,
         ROUND(SUM(pa.monto_pagado),2) AS monto_cobrado,
         ROUND(SUM(pa.monto_pagado) * 100.0 / SUM(pe.monto_total), 1) AS pct_cobrado
FROM     pedidos pe
JOIN     pagos   pa ON pe.pedido_id = pa.pedido_id
WHERE    pe.estado     != 'CANCELADO'
AND      pa.estado_pago = 'APROBADO'
GROUP BY pe.region
ORDER BY monto_cobrado DESC;Mientras corre una consulta en Hue, abrí una nueva pestaña y navegá a:
http://quickstart.cloudera:8088 → YARN ResourceManager UI (jobs activos y completados)
http://quickstart.cloudera:50070 → HDFS NameNode UI (espacio usado, DataNodes activos)
Impala: ejecutar las mismas consultas en el editor de Impala para comparar velocidad con Hive
Spark SQL: conectarse al shell de PySpark y consultar los mismos datos en memoria
Oozie: crear un workflow que encadene la carga a HDFS y las consultas Hive
Formatos columnarizados: convertir las tablas de TEXTFILE a ORC o Parquet para mejor performance
Referencias y Fuentes
A continuacion se listan las fuentes reales utilizadas para construir este manual, separadas por tipo de uso.
Fuentes Directas (contenido del manual)
Estas son las fuentes que se consultaron efectivamente para escribir el contenido de cada capitulo:
**Apache Hadoop Official Documentation ** hadoop.apache.org/docs/
Fuente principal para los Capitulos 2 (HDFS), 3 (MapReduce) y 4 (YARN). Usada para arquitectura, parametros de configuracion, comandos hdfs dfs y flujo de ejecucion de jobs.
Apache HDFS Architecture Guide
https://hadoop.apache.org/docs/stable/hadoop-project-dist/hadoop-hdfs/HdfsDesign.html — Fuente especifica para el Capitulo 2: division en bloques, factor de replicacion, rol del NameNode y DataNode, y tolerancia a fallos.
Apache MapReduce Tutorial
https://hadoop.apache.org/docs/stable/hadoop-mapreduce-client/hadoop-mapreduce-client-core/MapReduceTutorial.html — Fuente especifica para el Capitulo 3: fases Map, Shuffle y Reduce, ejemplo WordCount y flujo de ejecucion.
Apache YARN Architecture
https://hadoop.apache.org/docs/stable/hadoop-yarn/hadoop-yarn-site/YARN.html — Fuente especifica para el Capitulo 4: ResourceManager, NodeManager, ApplicationMaster y Containers.
Apache Hive Language Manual cwiki.apache.org/confluence/display/Hive
Fuente para el Capitulo 5 (seccion Hive) y el Ejercicio 3 del Capitulo 8: sintaxis HiveQL, CREATE EXTERNAL TABLE, LOCATION, TBLPROPERTIES y motores de ejecucion.
Apache Sqoop Documentation — sqoop.apache.org/docs/
Fuente para el Capitulo 5 (seccion Sqoop): comandos sqoop import, parametros —incremental, —check-column y —num-mappers.
Conocimiento de entrenamiento del modelo
La mayor parte del contenido conceptual, las analogias, los diagramas, los ejemplos de codigo PySpark, las comparaciones Hadoop vs RDBMS/DW y la descripcion del ecosistema (HBase, Oozie, Kafka, ZooKeeper) se construyeron desde el conocimiento incorporado al modelo durante el entrenamiento, basado en documentacion tecnica, libros y recursos de la industria.
Lecturas Recomendadas para Profundizar
Estas fuentes NO fueron consultadas directamente durante la redaccion del manual, pero son altamente recomendadas para quien quiera profundizar en cada tema:
Hadoop: The Definitive Guide — Tom White (O’Reilly, 4ta edicion)
La referencia mas completa sobre Hadoop. Ideal para profundizar en HDFS internals, tuning de MapReduce y administracion de clusters. Recomendado para Niveles 3 y 4.
Learning Spark — Jules Damji et al. (O’Reilly, 2da edicion)
Guia practica de Apache Spark con Python y Scala. Recomendado como lectura complementaria al Capitulo 5 (seccion Spark) para quienes quieran reemplazar MapReduce con Spark.
Programming Hive — Edward Capriolo, Dean Wampler, Jason Rutherglen (O’Reilly)
Guia completa de HiveQL y optimizacion de consultas sobre HDFS. Recomendado para profundizar en el Capitulo 5 (seccion Hive) y los ejercicios del Capitulo 8.
Cloudera Blog — blog.cloudera.com
Articulos tecnicos sobre administracion de clusters, tuning y novedades del ecosistema Hadoop. Util para mantenerse actualizado mas alla del contenido de este manual.
Versión del manual: 1.0 - Junio 2026
Elaborado para formación interna. Nivel 1 (Fundamentos) y Nivel 2 (Arquitectura y Ecosistema).
Archivos de práctica
Los scripts y recursos de este manual, para descargar y practicar en tu propio entorno.