Introducción
Detrás de cada número que aparece en un reporte hay una pregunta implícita: ¿de quién, de qué, cuándo, dónde y por qué? Un total de ventas, solo, no dice nada; recién cobra sentido cuando se lo puede cruzar con el cliente que compró, el producto que llevó, la fecha en que lo hizo y el lugar donde ocurrió. Esa es, en el fondo, la tarea de una dimensión: traducir un identificador anónimo en algo que una persona pueda leer y entender sin abrir el diccionario de datos.
Ralph Kimball, que introdujo el modelado dimensional a la industria del data warehousing en 1996 con The Data Warehouse Toolkit, planteó una distinción que sigue siendo el corazón de este enfoque: por un lado están los hechos, los números que se miden (una venta, un envío, un reclamo); por el otro, las dimensiones, el contexto descriptivo que responde el quién, el qué, el cuándo, el dónde y el por qué de cada hecho. Las tablas de hechos son angostas y profundas: crecen sin parar, fila tras fila, con pocas columnas. Las dimensiones son anchas y estables: muchas columnas descriptivas, relativamente pocas filas, y son justamente esas columnas las que alguien del negocio usa para filtrar, agrupar y darle sentido a un reporte.
Ese es el hilo que atraviesa todo este manual: no alcanza con guardar los datos, hay que guardarlos de una forma que una persona pueda recorrer de manera intuitiva, sin depender de quien los cargó ni de cómo los cargó. El esquema estrella —con sus tablas de hechos rodeadas de dimensiones— es la respuesta de Kimball a esa necesidad, y es también el mapa que vamos a seguir capítulo a capítulo.
1. Fundamentos: del OLTP al OLAP
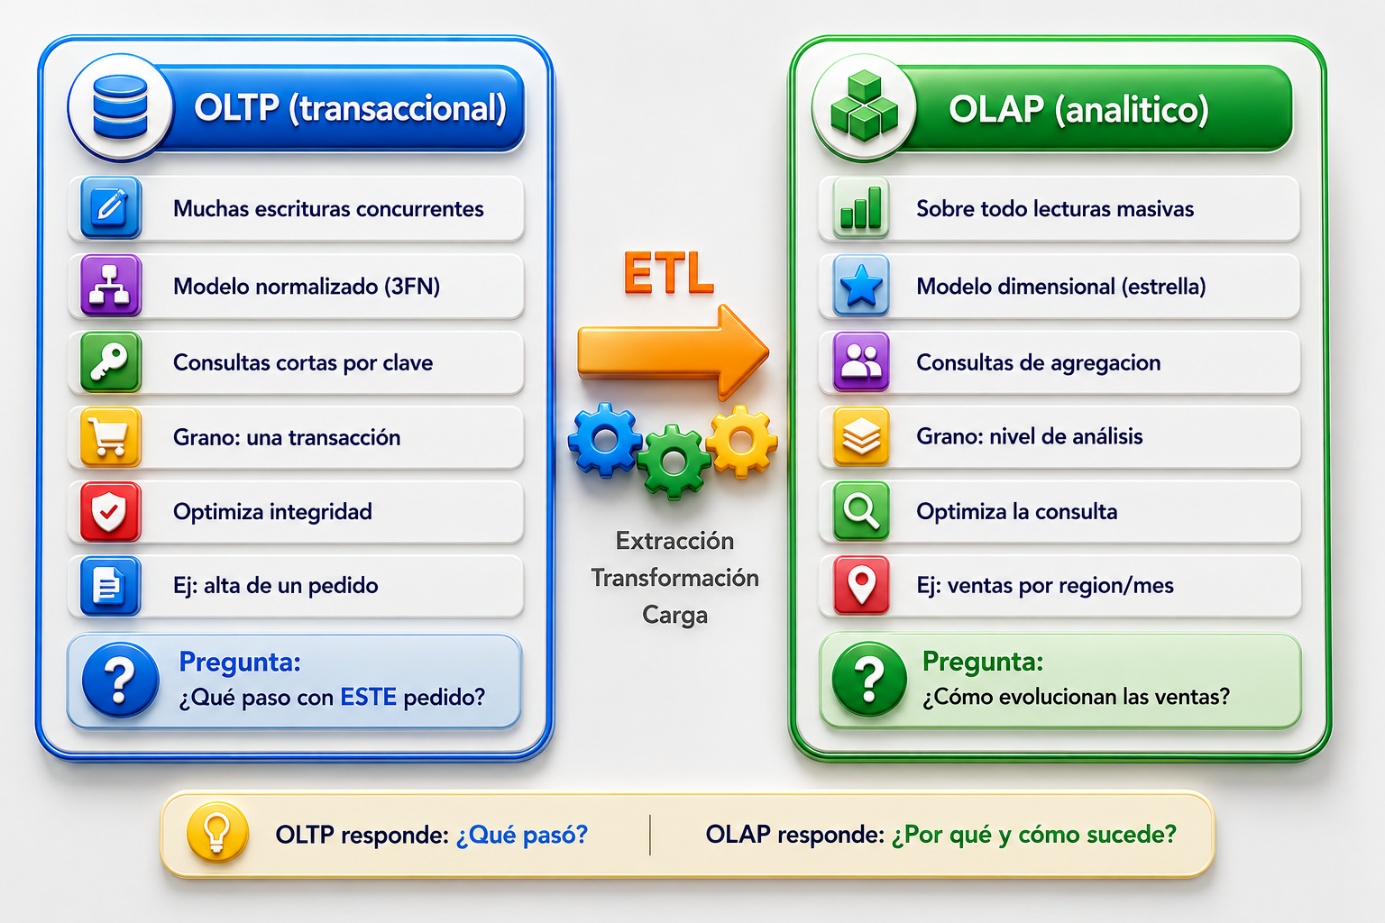
Todo sistema de información nace resolviendo operaciones del día a día: dar de alta un pedido, registrar un pago, actualizar el stock. Ese mundo transaccional esta optimizado para escribir con precisión y para responder preguntas sobre un registro puntual. El problema aparece cuando el negocio deja de preguntar ¿qué paso con este pedido? y empieza a preguntar ¿cómo evolucionan las ventas por región y por mes? Para esa segunda clase de preguntas, el diseño que sirve para operar se vuelve un obstáculo. El modelado dimensional es la respuesta a ese cambio de pregunta.
1.1 Que problema resuelve el modelado dimensional
Una base transaccional normalizada (tercera forma normal) reparte la información en muchas tablas para evitar redundancia y garantizar integridad. Eso es exactamente lo que se necesita al operar, pero cuando queremos analizar tendencias, cada consulta debe reconstruir el contexto uniendo media docena de tablas. La consulta se vuelve larga de escribir, difícil de leer y costosa de ejecutar.
Veamos el mismo análisis en los dos mundos. En un modelo normalizado, obtener las ventas por categoría y mes obliga a encadenar joins entre pedidos, líneas, productos, categorías y una tabla de calendario derivada de la fecha:
-- ILUSTRATIVO: esquema OLTP normalizado hipotetico (no es EDW_ECOMM).
-- Estas tablas (pedidos, detalle_pedido, productos, subcategorias,
-- categorias) NO existen en nuestra base: solo muestran como se
-- resolveria la misma pregunta en un modelo normalizado clasico.
-- No ejecutar contra EDW_ECOMM.
SELECT c.nombre_categoria,
EXTRACT(MONTH FROM p.fecha_pedido) AS mes,
SUM(dp.cantidad * dp.precio_unitario) AS ventas
FROM pedidos p
JOIN detalle_pedido dp ON dp.id_pedido = p.id_pedido
JOIN productos pr ON pr.id_producto = dp.id_producto
JOIN subcategorias s ON s.id_subcat = pr.id_subcat
JOIN categorias c ON c.id_categoria = s.id_categoria
GROUP BY c.nombre_categoria, EXTRACT(MONTH FROM p.fecha_pedido);
En el modelo dimensional la misma pregunta se apoya en una tabla de hechos rodeada de dimensiones ya desnormalizadas. La categoría vive como un atributo más dentro de dim_producto y el mes ya viene calculado en dim_fecha, así que la consulta se vuelve directa:
DATABASE EDW_ECOMM;

-- OLAP dimensional: la estructura ya esta pensada para esto
SELECT pr.categoria,
f.nombre_mes,
SUM(v.importe_total) AS ventas
FROM fact_ventas v
JOIN dim_producto pr ON pr.producto_sk = v.producto_sk
JOIN dim_fecha f ON f.fecha_sk = v.fecha_pedido_sk
GROUP BY pr.categoria, f.nombre_mes;
No es solo cuestión de escribir menos. El patrón de acceso en estrella (una tabla de hechos grande unida a dimensiones chicas por claves enteras) es el que los motores analíticos como Teradata saben optimizar mejor. La forma del modelo y la forma en que el motor consulta van de la mano.
1.2 OLTP vs OLAP: dos mundos, dos diseños
Conviene tener presente que no se trata de que un enfoque sea mejor que el otro, sino de que resuelven problemas distintos. El sistema operacional y el analítico coexisten: el primero alimenta al segundo a través de procesos de ETL. La siguiente tabla resume las diferencias que más impactan en el diseño:
| Aspecto | OLTP (operar) | OLAP (analizar) |
|---|---|---|
| Objetivo | Registrar transacciones | Responder preguntas de negocio |
| Modelo | Normalizado (3FN) | Dimensional (estrella) |
| Operación típica | Insert/Update por clave | Agregación sobre millones de filas |
| Grano | Una transacción | Nivel de análisis elegido |
| Optimiza | Integridad y concurrencia | Velocidad de consulta |
| Redundancia | Mínima | Controlada y deliberada |
Gráficamente, el sistema operacional y el analítico se ubican en dos extremos que conecta el ETL:
1.3 El esquema estrella como respuesta
El modelado dimensional organiza los datos en dos tipos de tabla. En el centro, la tabla de hechos guarda las medidas del negocio (lo que se cuenta o se suma) al grano elegido. Alrededor, las tablas de dimensión guardan el contexto descriptivo que da sentido a esas medidas: quien compro, que producto, cuando, donde. Al dibujar la tabla de hechos rodeada de sus dimensiones, el resultado tiene forma de estrella, y de ahí el nombre.
Este es el esquema estrella que usaremos como hilo conductor de todo el manual. Esta construido sobre un caso de e-commerce y será el ancla de cada ejemplo de acá en adelante:
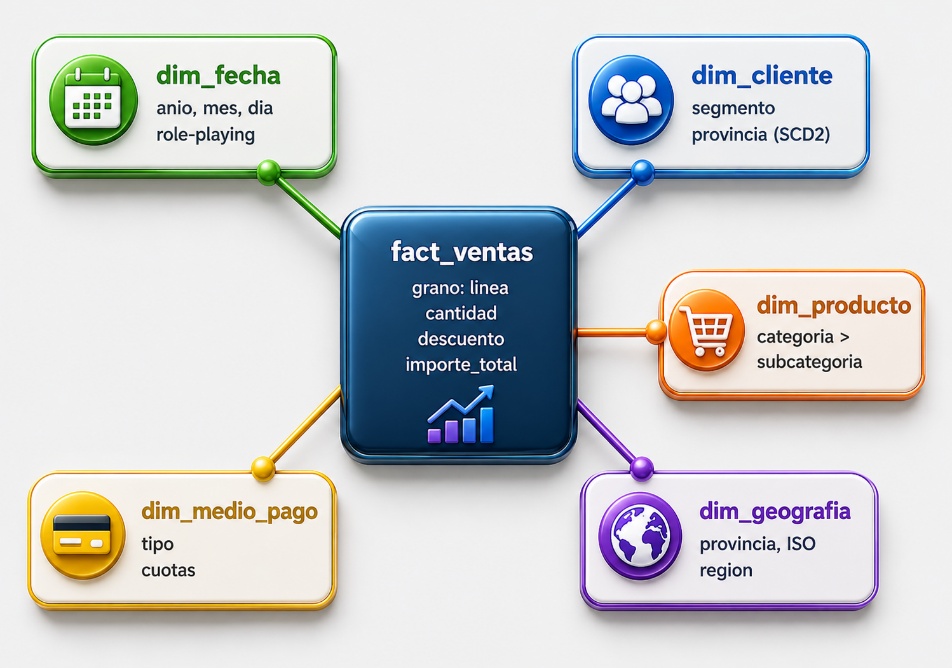
En el centro esta fact_ventas, con grano de una línea de pedido. A su alrededor, cinco dimensiones: dim_fecha (que además cumple varios roles, como veremos), dim_cliente (que guarda historia de cambios), dim_producto (con su jerarquía de categorías), dim_geografia y dim_medio_pago. Cada uno de los capítulos siguientes va a profundizar en una pieza de esta estrella, siempre con este mismo dataset a la vista para que los conceptos se puedan tocar.
Nota sobre la base de este manual. El esquema estrella de este manual vive en una base propia y separada,
EDW_ECOMM, distinta de la baseecommusada en el manual de Data Warehouse. No son la misma base ni el mismo diseño:ecommnace sobre tablas operacionales ya existentes (ecomm.clientes,ecomm.productos,ecomm.pedidos, etc.) y sus dimensionales llevan el Primary Index sobre la clave de negocio (PRIMARY INDEX (cliente_id)).EDW_ECOMM, en cambio, es un esquema nuevo pensado solo para este manual, con el Primary Index sobre la clave subrogada (PRIMARY INDEX (cliente_sk)) y columnas propias comodim_geografiaydim_medio_pago. Aunque algunas tablas compartan nombre entre ambos manuales (dim_cliente,dim_producto), son estructuras distintas: no hay que mezclarlas.El DDL completo esta en
00_ddl_estrella_ecomm.sqly los datos de ejemplo se generan congenerar_dataset_ecomm.py, que produce los CSV de cada tabla (incluido el caso de SCD Tipo 2 del Capítulo 5) endataset/csv/.
2. Grano, hechos y dimensiones
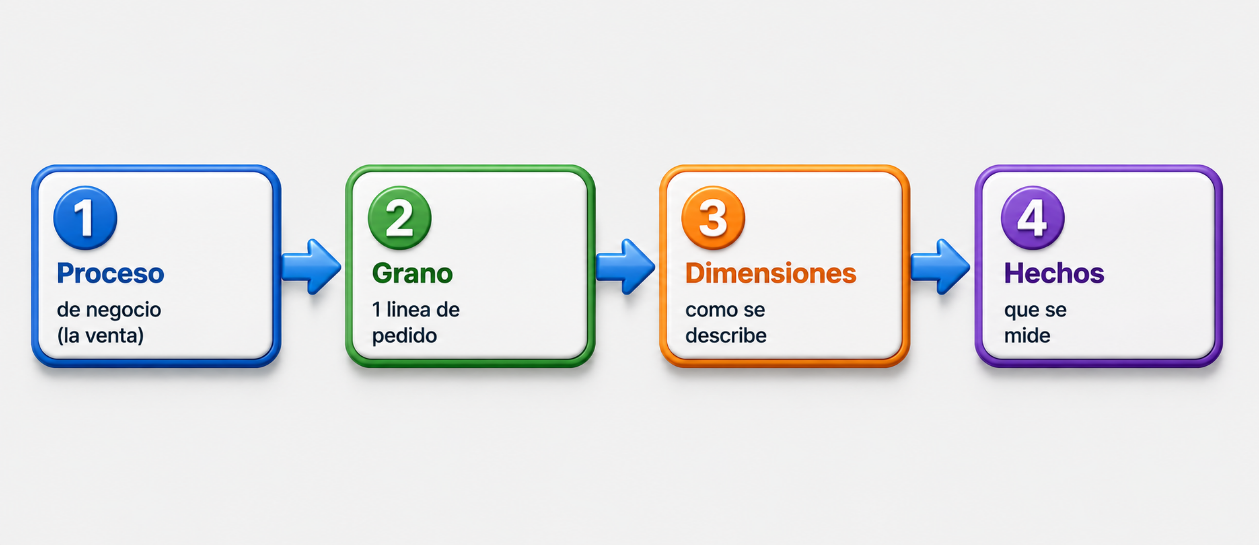
Kimball propone un método de cuatro pasos para diseñar cualquier estrella. No es una receta rígida sino un orden de decisiones que evita los errores más comunes. Lo importante es respetar la secuencia: cada paso se apoya en el anterior, y saltearse el segundo (declarar el grano) es la causa número uno de modelos que después no cierran.
2.1 Los cuatro pasos de Kimball
Los cuatro pasos, en orden, son:
-
Elegir el proceso de negocio a modelar. No una tabla ni un reporte, sino una actividad medible del negocio (la venta, el envío, el pago).
-
Declarar el grano: que representa exactamente una fila de la tabla de hechos. Esta es la decisión más crítica de todo el diseño.
-
Identificar las dimensiones: como se describe y se filtra ese proceso (por cliente, por producto, por fecha, por lugar).
-
Identificar los hechos: que se mide numéricamente en cada fila (cantidad, importe, descuento).
El orden no es casual. Recién cuando el grano está fijado tiene sentido preguntarse qué dimensiones aplican, porque toda dimensión valida debe ser consistente con ese grano. Y solo entonces se definen las medidas, que deben poder expresarse a ese mismo nivel de detalle.
2.2 Aplicado al proceso ‘venta e-commerce’
Sigamos los cuatro pasos sobre nuestro caso. El proceso de negocio es la venta online. Para el grano, la pregunta clave es: cual es el nivel de detalle más fino que necesitamos analizar. Un pedido puede tener varios productos, y queremos poder analizar hasta el nivel de producto, así que declaramos el grano como una línea de pedido: un producto dentro de un pedido.
Declarar el grano al nivel más fino posible es una buena práctica: siempre se puede agregar hacia arriba (sumar líneas para obtener el total del pedido), pero nunca se puede desagregar lo que no se guardó. Un grano demasiado grueso cierra puertas que después no se reabren.
Con el grano fijado, las dimensiones caen solas: quien compro (dim_cliente), que producto (dim_producto), cuando (dim_fecha), donde (dim_geografia) y como pago (dim_medio_pago). Y los hechos son las medidas que existen a nivel de línea: la cantidad, el precio unitario, el descuento y el importe total de esa línea.
2.3 Del proceso al esquema estrella inicial
La tabla de hechos resultante mezcla dos cosas: las claves foráneas hacia las dimensiones (una por cada ‘como se describe’) y las medidas (una por cada ‘que se mide’). Además, incluye el número de pedido como dimensión degenerada, un concepto que veremos en el Capítulo 4. Así queda la definición, ya en el grano de línea:
DATABASE EDW_ECOMM;

-- fact_ventas: grano = una línea de pedido
-- Claves foráneas (el 'como se describe') + medidas (el 'que se mide')
-- Nota: la tabla real ya se crea con 00_ddl_estrella_EDW_ecomm.sql;
-- esto es solo para mostrar la estructura, no la crees dos veces.
CREATE TABLE fact_ventas (
fecha_pedido_sk INTEGER NOT NULL, -- FK dim_fecha (rol pedido)
fecha_pago_sk INTEGER NOT NULL, -- FK dim_fecha (rol pago)
cliente_sk INTEGER NOT NULL, -- FK dim_cliente
producto_sk INTEGER NOT NULL, -- FK dim_producto
geografia_sk INTEGER NOT NULL, -- FK dim_geografia
medio_pago_sk INTEGER NOT NULL, -- FK dim_medio_pago
nro_pedido INTEGER NOT NULL, -- dimensión degenerada
cantidad INTEGER NOT NULL, -- medida aditiva
precio_unitario DECIMAL(10,2) NOT NULL, -- medida no aditiva
descuento DECIMAL(10,2) NOT NULL, -- medida aditiva
importe_total DECIMAL(12,2) NOT NULL -- medida aditiva
);
Una prueba útil para validar el grano: toda fila de la tabla de hechos debe poder describirse con la misma frase. Acá seria ‘el cliente C compro Q unidades del producto P, en el pedido N, pagando con el medio M’. Si alguna medida no encaja en esa frase (por ejemplo, un total que corresponde al pedido entero y no a la línea), esa medida está en el grano equivocado y hay que sacarla o llevarla a otra tabla de hechos.
3. Tablas de hechos
La tabla de hechos es el corazón de la estrella. Guarda las medidas del negocio y las claves que la conectan con el contexto. Es típicamente la tabla más grande del modelo (crece con la actividad) y la más angosta en variedad de columnas: casi todo son claves e importes. Entender sus tipos y la aditividad de sus medidas es lo que separa un modelo que suma bien de uno que engaña con totales incorrectos.
3.1 Tipos de tabla de hechos
Existen tres tipos principales, y la elección depende de que pregunta responde el proceso:
| Tipo | Que guarda | Ejemplo en e-commerce |
|---|---|---|
| Transaccional | Una fila por evento, al ocurrir | Cada línea de pedido (nuestra fact_ventas) |
| Snapshot periódico | Una foto del estado cada periodo | Saldo de stock al cierre de cada día |
| Snapshot acumulativo | Una fila por proceso, que se va actualizando | Ciclo del pedido: creado, pagado, enviado, entregado |
Nuestra fact_ventas es transaccional: una fila por cada línea, insertada cuando la venta ocurre, y nunca modificada. Es el tipo más común y el más flexible, porque conserva el máximo detalle. Los otros dos tipos responden preguntas que el transaccional no responde cómodamente, como ¿cuánto stock había el martes? (snapshot periodico) o ¿cuánto tarda un pedido entre pago y entrega? (snapshot acumulativo).
3.2 Aditividad de las medidas
No todas las medidas se pueden sumar en cualquier dimensión, y este es uno de los errores más caros del modelado. Según cómo se comportan al agregar, las medidas se clasifican en tres grupos:
| Aditividad | Se puede sumar… | Ejemplo |
|---|---|---|
| Aditiva | En todas las dimensiones | cantidad, descuento, importe_total |
| Semiaditiva | En algunas, no en el tiempo | saldo de stock (no se suma entre dias) |
| No aditiva | En ninguna; se recalcula | precio_unitario, margen (%) |
El caso más traicionero es el de precio_unitario. Esta guardado en fact_ventas, pero sumarlo no tiene ningún sentido: el promedio tampoco es confiable si no se pondera por cantidad. Lo correcto es tratarlo como una medida no aditiva y, cuando se necesita un valor agregado, recalcularlo a partir de medidas aditivas. Por ejemplo, el precio promedio real por unidad se obtiene así:
DATABASE EDW_ECOMM;

-- Medida NO aditiva: nunca sumar precio_unitario directamente.
-- El promedio correcto se recalcula desde medidas aditivas.
SELECT pr.categoria,
SUM(v.importe_total) AS ventas,
SUM(v.cantidad) AS unidades,
SUM(v.importe_total) / SUM(v.cantidad) AS precio_prom_real
FROM fact_ventas v
JOIN dim_producto pr ON pr.producto_sk = v.producto_sk
GROUP BY pr.categoria;
La regla practica: diseñar la tabla de hechos privilegiando medidas aditivas, y derivar las razones y porcentajes en la consulta o en la herramienta de BI, nunca guardándolas precalculadas al grano de la fila.
3.3 Tablas de hechos sin medidas (factless)
Existe un caso especial: tablas de hechos que no tienen ninguna medida numérica. Parecen un contrasentido, pero son útiles para registrar que un evento ocurrió o que una relación existe, y responder preguntas de cobertura y conteo. En nuestro dominio, una factless podría registrar que promociones estuvieron vigentes para que productos en cada fecha, sin importe asociado:
DATABASE EDW_ECOMM;

-- Factless: registra la ocurrencia, no un importe.
-- Responde 'que productos estuvieron en promoción en marzo?'
CREATE TABLE fact_promocion_vigente (
fecha_sk INTEGER NOT NULL, -- FK dim_fecha
producto_sk INTEGER NOT NULL, -- FK dim_producto
promocion_sk INTEGER NOT NULL -- FK dim_promocion
-- sin columnas de medida: el hecho es la vigencia misma
);
La ‘medida’ de una factless suele ser el conteo de filas: cuantos productos estuvieron en promoción, en cuantos días, etc. Son la herramienta indicada cuando lo relevante es la ocurrencia de un evento y no una cantidad asociada a él.
4. Tablas de dimensión
Si la tabla de hechos dice cuanto, las dimensiones dicen quien, que, cuando y donde. Son las tablas que le dan sentido a los números y las que el usuario usa para filtrar, agrupar y etiquetar. A diferencia de los hechos, las dimensiones son anchas (muchos atributos descriptivos) y relativamente chicas en cantidad de filas. Una buena dimensión está llena de atributos textuales ricos, porque cada atributo es una forma potencial de cortar el análisis.
4.1 Atributos y jerarquías
Los atributos de una dimensión suelen organizarse en jerarquías naturales que permiten navegar de lo general a lo particular. En dim_producto, un producto pertenece a una subcategoría, que a su vez pertenece a una categoría. Esa jerarquía es la que habilita el roll-up y el drill-down que veremos en el Capítulo 9.
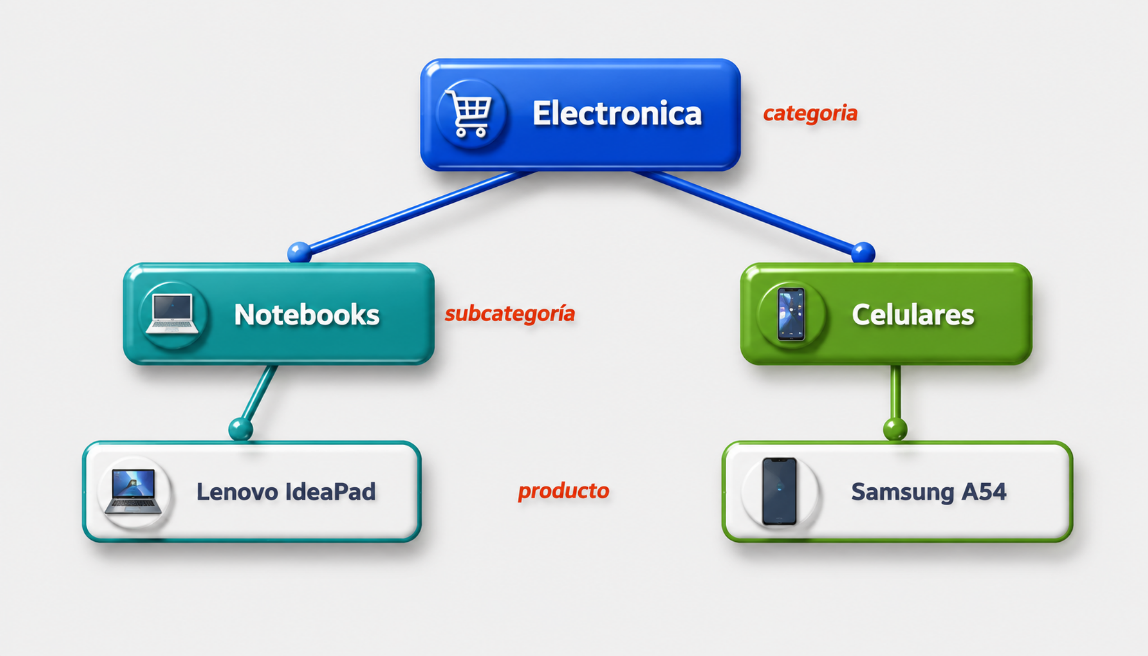
Un punto clave del enfoque Kimball: la jerarquía se guarda desnormalizada, con las tres columnas (categoría, subcategoría, producto) en la misma tabla dim_producto. No se separan en tablas distintas. Esto es deliberado: sacrifica un poco de espacio a cambio de evitar joins y de simplificar las consultas. La dimensión carga la redundancia para que la estrella quede limpia:
DATABASE EDW_ECOMM;

-- Jerarquía desnormalizada dentro de la MISMA dimensión.
-- categoria y subcategoria se repiten fila a fila: es intencional.
SELECT producto_sk, nombre_producto, subcategoria, categoria
FROM dim_producto
ORDER BY categoria, subcategoria, nombre_producto;

-- Roll-up trivial: la jerarquía ya está en la tabla
SELECT categoria, COUNT(*) AS productos
FROM dim_producto
GROUP BY categoria;
4.2 Dimensiones degeneradas
A veces un identificador operacional es útil para agrupar, pero no tiene atributos propios que justifiquen una tabla de dimensión aparte. El número de pedido es el caso típico: sirve para reunir todas las líneas de un mismo pedido, pero más allá del número no hay nada que describir. En lugar de crear una dim_pedido vacia, se deja el identificador dentro de la tabla de hechos. Eso es una dimensión degenerada:
DATABASE EDW_ECOMM;

-- nro_pedido vive en la fact, sin tabla de dimensión propia.
-- Permite reconstruir el pedido completo agrupando líneas.
SELECT v.nro_pedido,
COUNT(*) AS lineas,
SUM(v.importe_total) AS total_pedido
FROM fact_ventas v
GROUP BY v.nro_pedido
HAVING COUNT(*) > 1;
4.3 Role-playing, junk y conformadas
Tres patrones habituales completan el panorama de las dimensiones.
Role-playing: una misma tabla de dimensión puede cumplir varios roles en la misma tabla de hechos. dim_fecha es el ejemplo clásico: la fecha de pedido, la de pago y la de envío son todas fechas, y se resuelven con una sola dim_fecha referenciada varias veces. En la consulta se le da un alias distinto a cada rol:
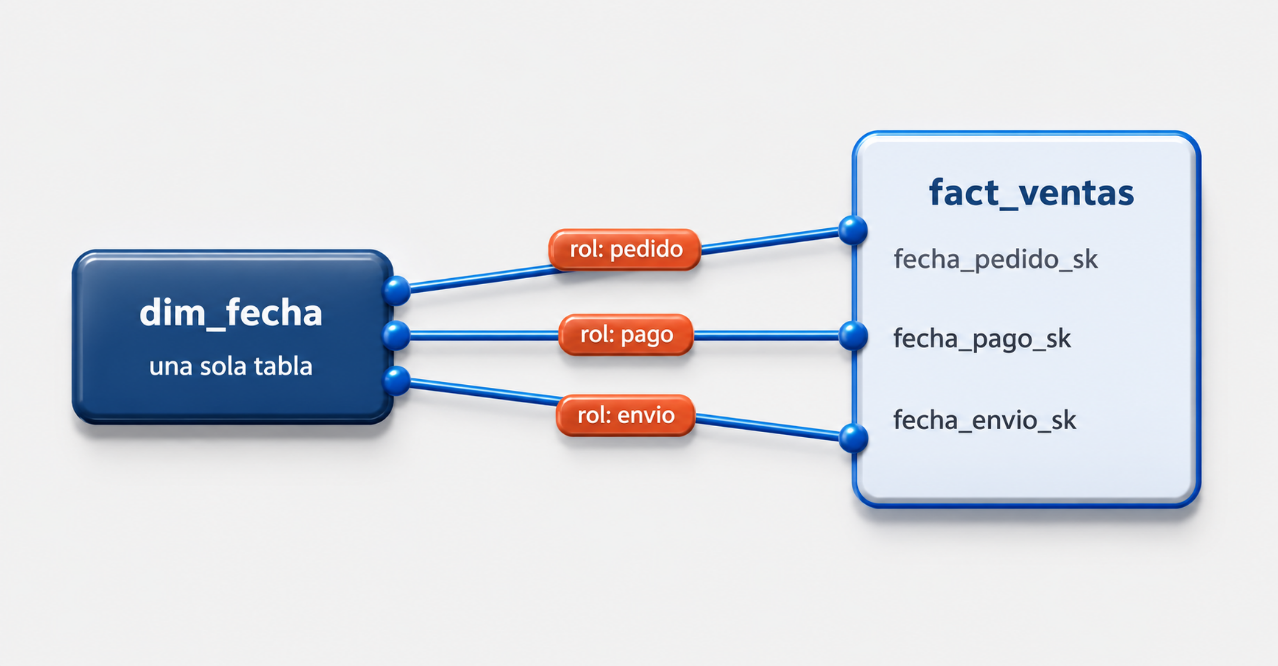
DATABASE EDW_ECOMM;

-- Una sola dim_fecha, dos roles: pedido y pago.
-- El alias distingue el rol en cada join.
SELECT fp.anio_mes AS mes_pedido,
fg.anio_mes AS mes_pago,
SUM(v.importe_total) AS ventas
FROM fact_ventas v
JOIN dim_fecha fp ON fp.fecha_sk = v.fecha_pedido_sk
JOIN dim_fecha fg ON fg.fecha_sk = v.fecha_pago_sk
GROUP BY fp.anio_mes, fg.anio_mes;
Junk: los flags y atributos de baja cardinalidad que no merecen dimensión propia (un indicador de si/no, un estado corto) suelen agruparse en una única dimensión ‘junk’ que combina todas sus posibles combinaciones. Evita ensuciar la tabla de hechos con columnas sueltas y evita multiplicar dimensiones diminutas.
Conformadas: una dimensión es conformada cuando se comparte, idéntica, entre varias tablas de hechos. Si más adelante agregamos un proceso de envíos con su propia fact, dim_geografia y dim_fecha deberian ser exactamente las mismas que usa fact_ventas. Esa consistencia es la que permite comparar procesos distintos con el mismo vocabulario, y es la base de la bus matrix que veremos en el Capítulo 7.
5. Slowly Changing Dimensions (SCD)
Los atributos de una dimensión cambian con el tiempo: un cliente se muda de provincia, un producto cambia de categoría, un vendedor cambia de zona. La pregunta clave del modelado es: cuando un atributo cambia, que hacemos con la historia. Conservar el valor viejo o pisarlo cambia por completo el resultado de los análisis históricos. Las técnicas de Slowly Changing Dimensions (SCD) son las distintas respuestas a esa pregunta.
5.1 Panorama de tipos
Kimball numera las estrategias. Estas son las que se usan en la práctica:
| Tipo | Que hace ante un cambio | Efecto en la historia |
|---|---|---|
| Tipo 0 | No cambia nunca (fijo) | Se conserva el valor original |
| Tipo 1 | Pisa el valor viejo | Se pierde la historia |
| Tipo 2 | Agrega una fila nueva (versión) | Se conserva toda la historia |
| Tipo 3 | Guarda valor anterior en otra columna | Historia limitada (un paso atrás) |
| Tipo 4 | Mueve la historia a una tabla aparte | Historia separada del actual |
| Tipo 6 | Combina 1 + 2 + 3 (hibrido) | Versión + valor actual a mano |
El Tipo 1 y el Tipo 2 son los dos caballos de batalla. El Tipo 1 sirve para correcciones (un error de tipeo en el nombre no merece una versión nueva). El Tipo 2 sirve cuando el cambio es real y la historia importa: es el que usamos para la provincia del cliente, porque queremos que una venta vieja se siga atribuyendo a la provincia que el cliente tenía en ese momento.
5.2 SCD Tipo 2 paso a paso
Nuestro dataset ya trae el caso armado. El cliente 1005 arranco en Neuquén y en julio de 2024 se mudó a Buenos Aires. En lugar de pisar la provincia, la dimensión guarda dos filas, cada una con su propia clave subrogada y su ventana de vigencia:
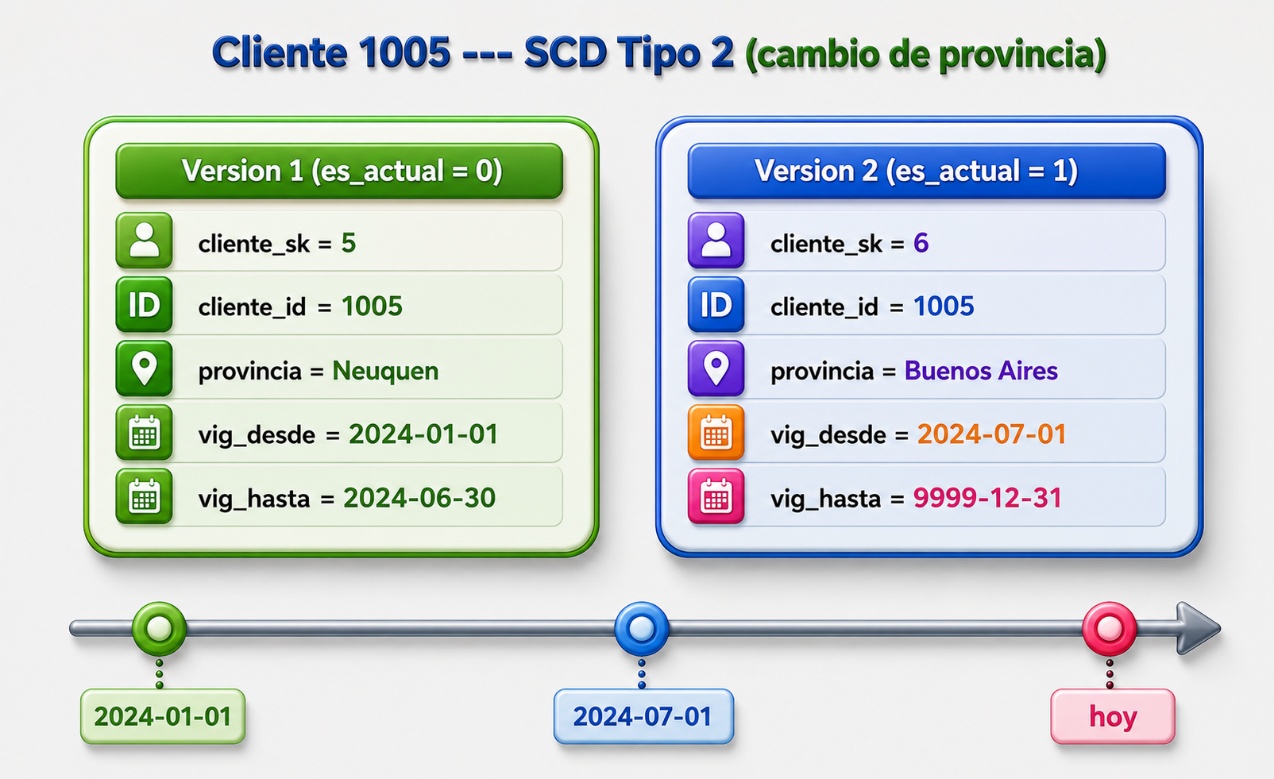
Las tres columnas de control hacen toda la magia: vig_desde y vig_hasta delimitan cuando estuvo vigente cada versión, y es_actual marca de un vistazo cual es la fila viva. La fila cerrada usa 9999-12-31 mientras sigue vigente y recibe una fecha real de cierre cuando aparece la versión siguiente. Así se ve la historia completa de ese cliente:
DATABASE EDW_ECOMM;

-- Historia completa del cliente 1005 (SCD Tipo 2)
SELECT cliente_sk, cliente_id, provincia,
vig_desde, vig_hasta, es_actual
FROM dim_cliente
WHERE cliente_id = 1005
ORDER BY vig_desde;
-- cliente_sk | provincia | vig_desde | vig_hasta | es_actual
-- 5 | Neuquen | 2024-01-01 | 2024-06-30 | 0
-- 6 | Buenos Aires | 2024-07-01 | 9999-12-31 | 1
La consecuencia analítica es la que importa: como la fact_ventas apunta al cliente_sk (no al cliente_id), una venta de marzo quedo ligada a la versión Neuquén y una de agosto a la versión Buenos Aires. El reporte de ventas por provincia refleja la realidad de cada momento, sin reescribir el pasado. Para ver solo el estado actual del cliente, se filtra por es_actual:
DATABASE EDW_ECOMM;

-- Estado vigente de cada cliente: filtrar es_actual = 1
SELECT cliente_id, provincia
FROM dim_cliente
WHERE es_actual = 1;
-- Ventas atribuidas a la provincia VIGENTE AL MOMENTO de la venta
-- (join natural por SK: cada venta ya trae su versión correcta)
SELECT c.provincia, SUM(v.importe_total) AS ventas
FROM fact_ventas v
JOIN dim_cliente c ON c.cliente_sk = v.cliente_sk
GROUP BY c.provincia;
5.3 Carga de SCD Tipo 2 con DataStage / SQL
En un job de DataStage el Tipo 2 se resuelve con un patrón de lookup y captura de cambios: se compara la fila entrante contra la versión vigente en la dimensión; si un atributo Tipo 2 difiere, se cierra la fila actual (se le pone vig_hasta y es_actual = 0) y se inserta la versión nueva con una clave subrogada fresca. En SQL puro sobre Teradata, la parte de cierre y alta se puede expresar así:
DATABASE EDW_ECOMM;

-- Paso 1: cerrar la versión vigente que cambio de provincia
UPDATE dim_cliente
SET vig_hasta = DATE '2024-06-30',
es_actual = 0
WHERE cliente_id = 1005
AND es_actual = 1;
-- Paso 2: insertar la versión nueva (SK nueva, vigencia abierta)
DATABASE EDW_ECOMM;
INSERT INTO dim_cliente
(cliente_sk, cliente_id, nombre, apellido, email, segmento,
provincia, vig_desde, vig_hasta, es_actual)
VALUES
(6, 1005, 'Sofia', 'Gomez', 'sofia.gomez@mail.com', 'VIP',
'Buenos Aires', DATE '2024-07-01', DATE '9999-12-31', 1);El orden importa: primero se cierra la versión vieja, después se abre la nueva, de modo que en ningún instante queden dos filas con es_actual = 1 para el mismo cliente. Esa invariante (una sola versión vigente por clave de negocio) es la que hay que cuidar en la carga.
6. Claves subrogadas (surrogate keys)
Cada dimensión de nuestra estrella tiene una columna terminada en _sk: cliente_sk, producto_sk, fecha_sk. Son claves subrogadas: enteros sin significado de negocio, generados por el data warehouse, que actúan como clave primaria de la dimensión y como clave foránea en la fact. No son un capricho: sostienen buena parte de lo que vimos en el capítulo anterior.
6.1 Porque no usar la clave del origen
La tentación es usar directamente la clave del sistema operacional (el cliente_id 1005) como clave en el DW. Es un error por varias razones. La clave de negocio puede cambiar de formato tras una migración, puede repetirse entre distintos orígenes que hay que integrar, y sobre todo no puede representar dos versiones del mismo cliente, que es justo lo que necesita el SCD Tipo 2. La clave subrogada resuelve las tres cosas de un saque:
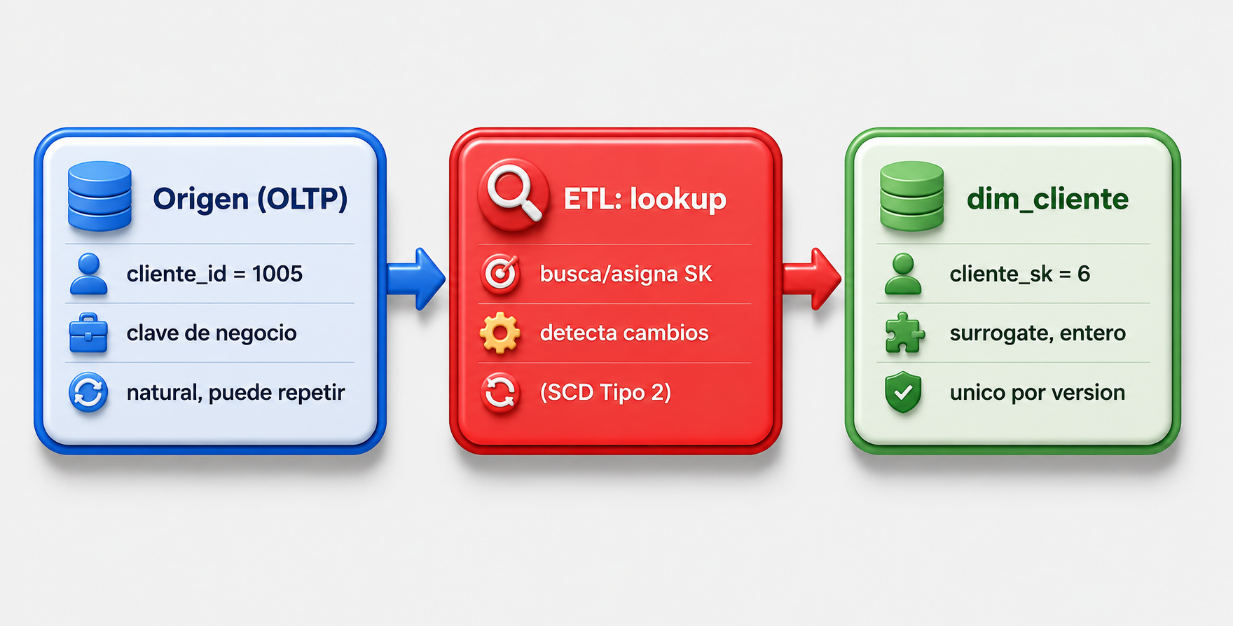
El diagrama muestra la separación de responsabilidades: el origen aporta la clave de negocio (cliente_id), el ETL asigna la clave subrogada (cliente_sk) y detecta los cambios, y la dimensión queda con ambas. La fact_ventas se une a la dimensión por el cliente_sk, nunca por el cliente_id. Recordemos las dos versiones del cliente 1005 del capítulo anterior: comparten cliente_id = 1005 pero tienen cliente_sk 5 y 6. Sin clave subrogada, esa distinción sería imposible.
6.2 Generación de la clave subrogada
Hay dos formas de generar la SK: dejar que la base la genere con una columna identidad, o generarla en el proceso de ETL. En Teradata, la columna identidad se declara así:
DATABASE EDW_ECOMM;

-- Opcion A: Teradata genera la SK con GENERATED ALWAYS AS IDENTITY
-- (tabla de demo con otro nombre para no chocar con tu dim_cliente real)
-- OJO: NOT NULL va ANTES de GENERATED ALWAYS AS IDENTITY, no despues;
-- ponerlo despues es lo que tira el error 3704 de sintaxis en Teradata.
CREATE TABLE dim_cliente_identity_demo (
cliente_sk INTEGER NOT NULL GENERATED ALWAYS AS IDENTITY
(START WITH 1 INCREMENT BY 1),
cliente_id INTEGER NOT NULL,
provincia VARCHAR(60) NOT NULL,
vig_desde DATE NOT NULL,
vig_hasta DATE NOT NULL,
es_actual BYTEINT NOT NULL
)
PRIMARY INDEX (cliente_sk);
La otra opción es generar la SK en el ETL, típicamente con un surrogate key generator en DataStage o con una función de ventana al cargar. Generarla en el ETL da más control (por ejemplo, para reservar rangos por origen), a costa de más lógica en el job. En ambos casos la SK debe ser un entero: los joins de la fact contra las dimensiones se hacen sobre enteros, que es lo que el motor procesa más rápido.
6.3 La clave -1 ‘Desconocido’
Toda dimensión del dataset incluye una fila especial con SK igual a -1 y valores ‘Desconocido’. Su razón de ser es no perder filas de hechos cuando falta el contexto. Si llega una venta cuyo medio de pago no se pudo resolver, en lugar de dejar la FK en nulo (que rompe los joins internos y descuadra los totales), el ETL apunta esa venta al miembro -1. La venta se conserva, el importe suma, y el análisis muestra honestamente una categoría ‘Desconocido’:
DATABASE EDW_ECOMM;

-- El miembro -1 evita perder hechos por contexto faltante.
-- Un JOIN normal (no LEFT) sigue trayendo estas ventas.
SELECT mp.tipo, SUM(v.importe_total) AS ventas
FROM fact_ventas v
JOIN dim_medio_pago mp ON mp.medio_pago_sk = v.medio_pago_sk
GROUP BY mp.tipo;
-- Las ventas sin medio resuelto caen en tipo 'Desconocido', no se pierden.
Este patrón se combina con el manejo de dimensiones que llegan tarde (late arriving dimensions): cuando un hecho llega antes que su fila de dimensión, se lo apunta temporalmente a -1 o a una fila placeholder, y un proceso posterior lo reasigna cuando la dimensión aparece. La regla de fondo es simple: nunca dejar una clave foránea en nulo en la tabla de hechos.
7. La bus matriz del DW empresarial
Hasta acá modelamos un solo proceso: la venta. Pero un data warehouse real cubre muchos procesos (ventas, envíos, stock, devoluciones) y todos comparten contexto. La bus matriz es la herramienta de planificación de Kimball que ordena ese crecimiento y garantiza que las piezas encajen entre si en lugar de convertirse en islas.
7.1 Arquitectura de bus de Kimball
La idea central es la dimensión conformada: una dimensión que se define una sola vez y se reutiliza, idéntica, en todos los procesos que la necesiten. Si ventas y envíos usan exactamente la misma dim_fecha y la misma dim_geografia, entonces se pueden comparar y combinar sus resultados con el mismo vocabulario. Esa reutilización es el ‘bus’ (por analogía con el bus de una computadora, un canal compartido al que se conectan componentes).
El bus matriz se dibuja como una grilla: los procesos de negocio en las filas, las dimensiones conformadas en las columnas, y una marca en cada cruce donde el proceso usa esa dimensión. Leerla de izquierda a derecha dice con que se describe cada proceso; leerla de arriba hacia abajo dice que procesos comparten una dimensión (y por lo tanto se pueden cruzar).
7.2 Bus matriz del caso e-commerce
Así queda el bus matriz partiendo de nuestra venta y proyectando los procesos que naturalmente vendrían después. Las marcas indican que dimensión conformada aplica a cada proceso:
| Proceso \ Dimensión | Fecha | Cliente | Producto | Geografía | Medio pago |
|---|---|---|---|---|---|
| Ventas | Si | Si | Si | Si | Si |
| Envíos | Si | Si | Si | Si | - |
| Stock (snapshot) | Si | - | Si | Si | - |
| Devoluciones | Si | Si | Si | Si | - |
| Pagos | Si | Si | - | - | Si |
La matriz revela dos cosas de un vistazo. Primero, que dim_fecha es la dimensión más conformada de todas: la comparten los cinco procesos, así que definirla bien una sola vez paga en todos lados. Segundo, que ventas y devoluciones comparten cuatro dimensiones, lo que anticipa que se podrán cruzar sin fricción (por ejemplo, tasa de devolución por categoría y región) precisamente porque hablan el mismo idioma dimensional.
El valor practico del bus matriz es que se arma antes de construir, como mapa de ruta. Cada proceso se implementa como una estrella independiente, pero al compartir dimensiones conformadas el conjunto se comporta como un único data Waterhouse integrado, y no como una colección de reportes que no se pueden comparar entre sí.
8. Temas avanzados de modelado
Con los fundamentos firmes, hay tres patrones que aparecen cuando el modelo se enfrenta a situaciones que la estrella básica no cubre cómodamente: relaciones muchos-a-muchos, atributos que cambian demasiado seguido, y la tentación de normalizar dimensiones. Conocerlos evita forzar la estrella o, peor, romper el grano.
8.1 Relaciones muchos-a-muchos y bridge tables
La estrella asume que cada hecho se relaciona con una sola fila de cada dimensión. Pero a veces la relación es muchos-a-muchos: un producto puede participar de varias promociones a la vez, y una promoción agrupa varios productos. Meter eso directo en la fact romperia el grano (habría que duplicar la línea de venta por cada promoción, y los importes se contarían de más). La solución es una tabla puente (bridge) que se intercala entre la fact y la dimensión:
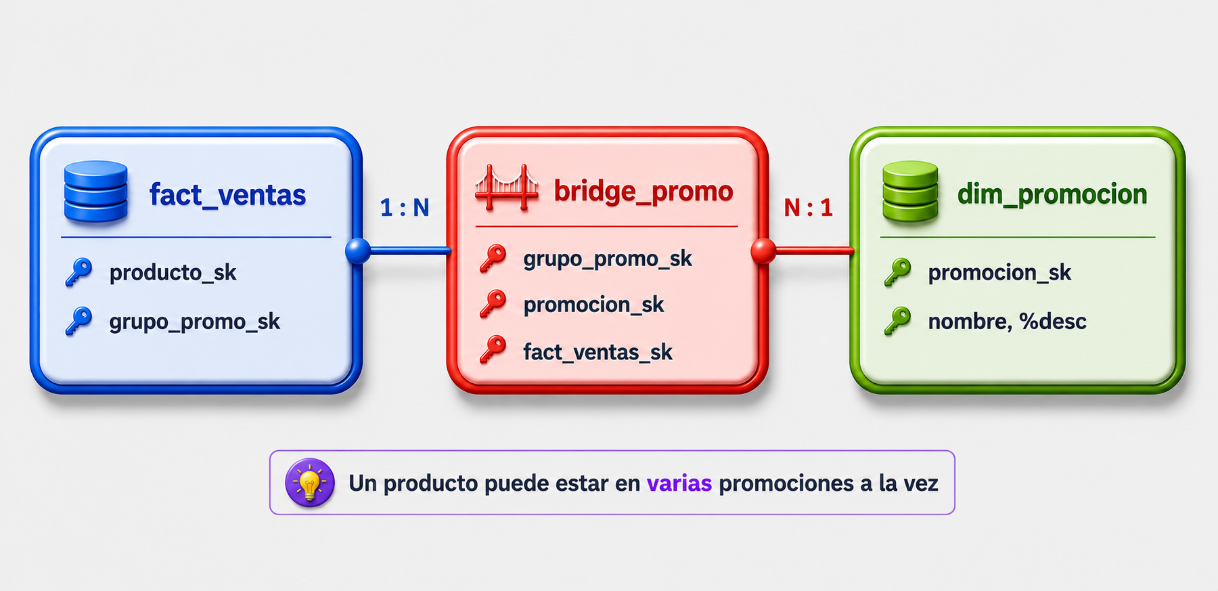
La fact apunta a un grupo de promociones (grupo_promo_sk), y la bridge expande ese grupo en sus promociones individuales. Así la línea de venta sigue siendo una sola fila (grano intacto) y, cuando se necesita abrir el análisis por promoción, se pasa por la bridge. El costo a vigilar es el doble conteo: al unir por la bridge, sumar importe_total puede inflar los totales si una venta pertenece a varias promociones, por lo que a veces se agrega un factor de asignación en la bridge para repartir el importe.
8.2 Mini-dimensiones
Un problema típico del SCD Tipo 2 es que ciertos atributos cambian tan seguido que generan una explosión de versiones. Si a dim_cliente le agregamos rangos de edad, nivel de ingresos y scoring, y esos valores se recalculan a menudo, cada cliente acumularía decenas de versiones y la dimensión crecería sin control. La mini-dimensión separa esos atributos volátiles en una dimensión aparte, con una fila por cada combinación posible de rangos:
DATABASE EDW_ECOMM;

-- Mini-dimensión: combinaciones de atributos volátiles.
-- No versiona por cliente; el cambio se refleja en la FK de la fact.
CREATE TABLE dim_perfil_cliente (
perfil_sk INTEGER NOT NULL,
rango_edad VARCHAR(15) NOT NULL, -- 18-25, 26-35, ...
rango_ingreso VARCHAR(15) NOT NULL, -- bajo, medio, alto
scoring VARCHAR(10) NOT NULL -- A, B, C
)
PRIMARY INDEX (perfil_sk);
La fact_ventas lleva entonces dos claves hacia el cliente: cliente_sk (identidad estable, SCD Tipo 2 para lo que cambia poco) y perfil_sk (la combinación de rangos en el momento de la venta). El cambio de perfil no genera una versión nueva del cliente; simplemente la próxima venta apunta a otro perfil_sk. Es una forma de capturar el cambio sin versionar la dimensión principal.
8.3 Outriggers
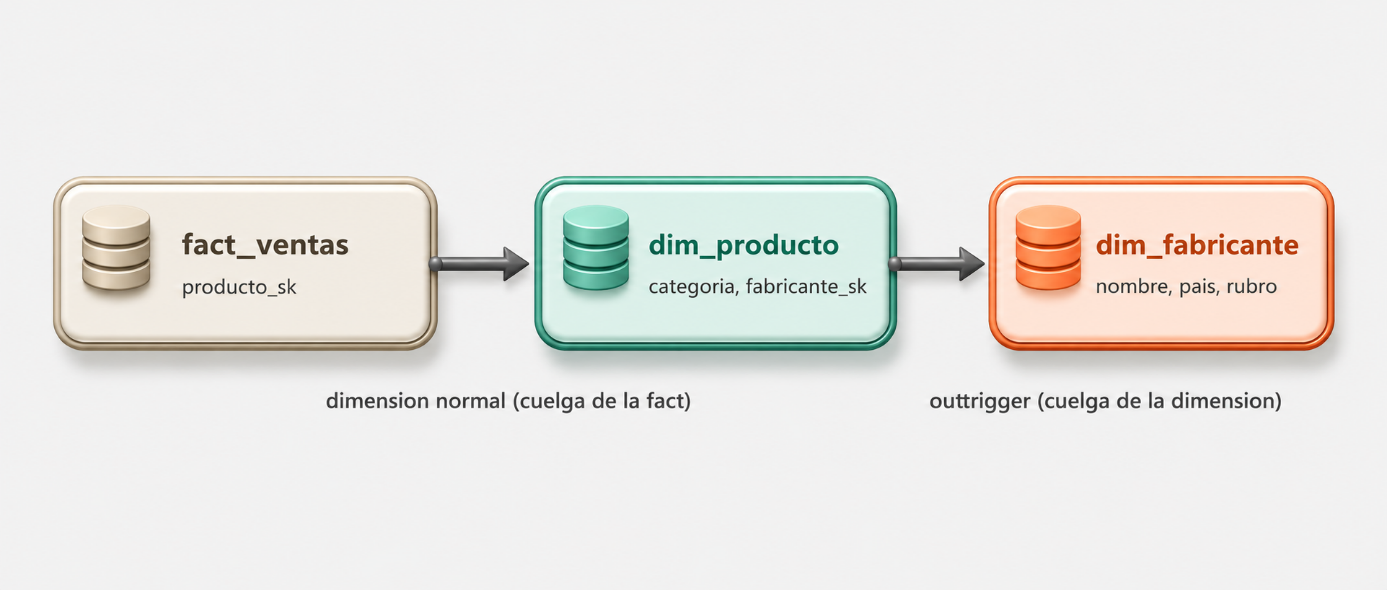
Un outrigger es una dimensión que cuelga de otra dimensión en lugar de colgar de la fact. Por ejemplo, si dim_producto tuviera una referencia a una dim_fabricante con muchos atributos propios, se podría dejar esa dim_fabricante como outrigger de dim_producto. Es la puerta de entrada al esquema copo de nieve (snowflake), y por eso conviene tratarlo con cuidado.
La recomendación de Kimball es usar outriggers con moderación. En la mayoría de los casos es preferible desnormalizar (traer los atributos del fabricante a dim_producto, aunque se repitan) para mantener la estrella plana y las consultas simples. El outrigger se justifica solo cuando el conjunto de atributos es grande, se comparte entre varias dimensiones y tiene su propia vida; fuera de ese caso, suele ser un anti patrón que agrega joins sin beneficio real.
9. Del modelo dimensional al cubo OLAP
Este capítulo es el puente entre el modelado y el consumo. Hasta acá diseñamos la estrella; ahora vemos como esa estrella se explota analíticamente y como esa forma de explotarla se materializa, en el mundo real, en la herramienta de BI. Es la bisagra que conecta este manual con el de Business Intelligence.
9.1 Modelo lógico vs capa de consumo
Conviene desactivar una confusión frecuente de entrada: el modelo dimensional y el cubo no son lo mismo. El modelo dimensional (la estrella) es el diseño lógico de las tablas. El cubo es una forma de consumir ese modelo, una vista multidimensional de los datos donde cada medida se puede mirar según varias dimensiones a la vez. Se puede tener la estrella perfecta y consultarla con SQL puro, sin ningún cubo de por medio. El cubo es una capa de conveniencia sobre la estrella, no un reemplazo de ella.
9.2 Operaciones OLAP
Pensar en cubo significa pensar en operaciones sobre un espacio de varias dimensiones. Imaginemos las ventas como un cubo cuyos ejes son tiempo, producto y geografía; cada celda guarda una medida (el importe). Las cinco operaciones clásicas navegan ese cubo:
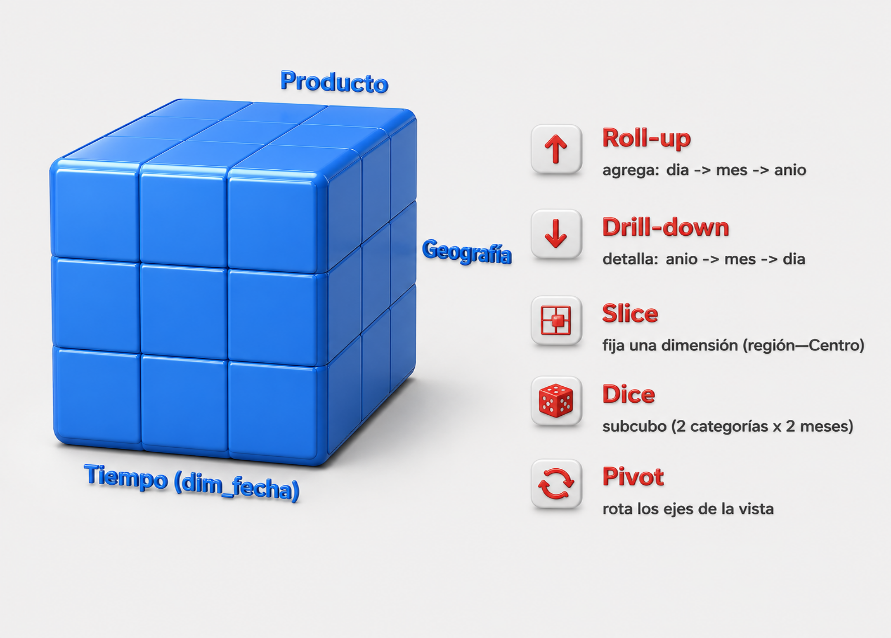
Roll-up y drill-down se mueven por las jerarquías que definimos en las dimensiones. El roll-up agrega hacia arriba (de día a mes a año); el drill-down hace lo inverso. Lo importante es que ambas operaciones se apoyan directamente en la jerarquía desnormalizada de dim_fecha y dim_producto del Capítulo 4. Sobre la estrella, un roll-up es simplemente cambiar el nivel del GROUP BY:
DATABASE EDW_ECOMM;

-- Drill-down: del año al mes (bajar un nivel de la jerarquía fecha)
SELECT f.anio, f.nombre_mes, SUM(v.importe_total) AS ventas
FROM fact_ventas v
JOIN dim_fecha f ON f.fecha_sk = v.fecha_pedido_sk
GROUP BY f.anio, f.nombre_mes;
-- Slice: fijar una dimensión (solo región Centro)
SELECT pr.categoria, SUM(v.importe_total) AS ventas
FROM fact_ventas v
JOIN dim_producto pr ON pr.producto_sk = v.producto_sk
JOIN dim_geografia g ON g.geografia_sk = v.geografia_sk
WHERE g.region = 'Centro'
GROUP BY pr.categoria;
Slice fija una dimensión en un valor (una tajada del cubo); Slice selecciona un subcubo acotando varias dimensiones a la vez; y pivot rota los ejes para mirar los mismos datos desde otra perspectiva. Todas se expresan, sobre la estrella, como combinaciones de WHERE y GROUP BY. El cubo no agrega poder expresivo que la estrella no tenga: agrega comodidad y, sobre todo, velocidad.
9.3 ROLAP vs MOLAP vs HOLAP
Donde viven físicamente esos agregados define tres enfoques, y acá es donde el capítulo aterriza en el stack real:
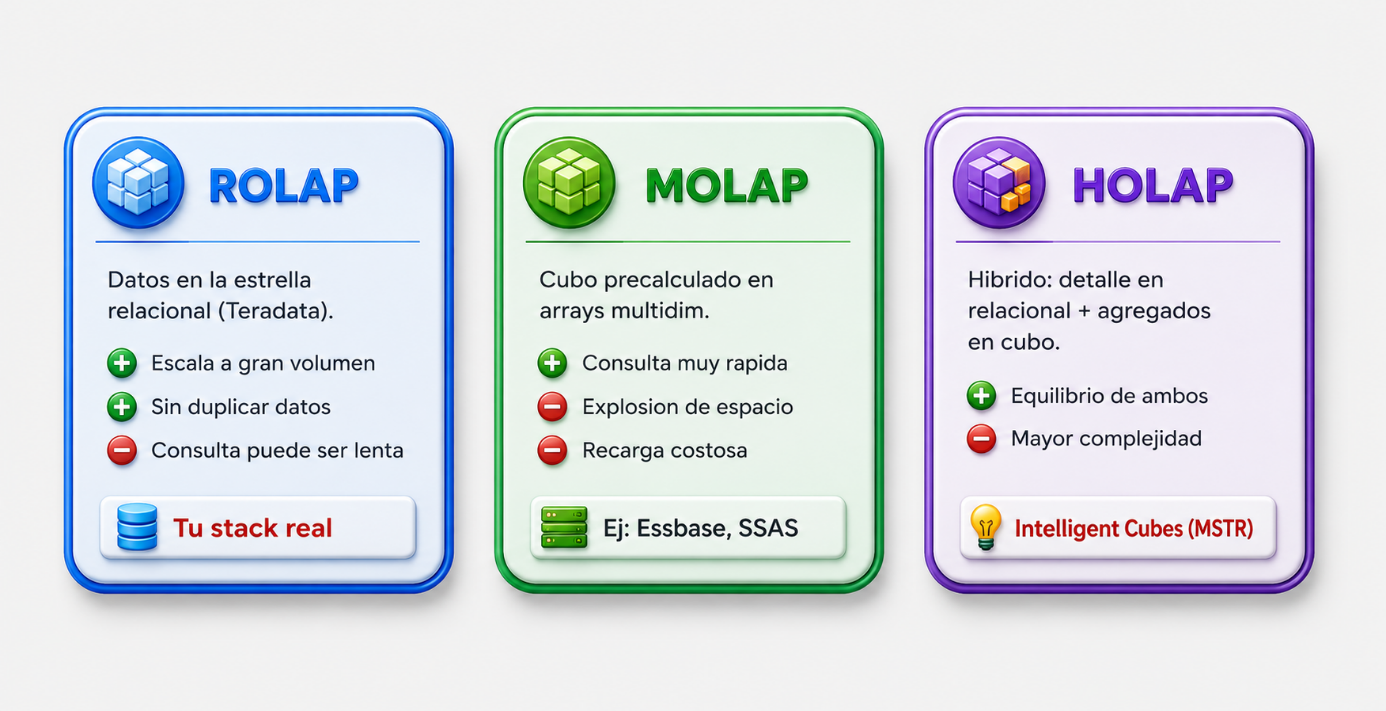
En ROLAP el cubo es virtual: los datos quedan en la estrella relacional y cada consulta se traduce a SQL contra Teradata. Escala a volúmenes enormes y no duplica datos, a cambio de que la consulta pesada pueda tardar. En MOLAP el cubo se precálculo y se guarda en estructuras multidimensionales, con consultas muy rápidas, pero explosión de espacio y recargas costosas. HOLAP combina ambos.
En el stack de Teradata más MicroStrategy, el enfoque de base es ROLAP: las consultas pegan contra la estrella en Teradata. Encima de eso, los Intelligent Cubes de MicroStrategy son cubos en memoria que cachean conjuntos de datos frecuentes para acelerar los reportes, funcionando en la práctica como una capa hibrida. No es MOLAP clásico de almacenamiento en arrays, sino cache multidimensional sobre la estrella relacional.
9.4 Puente hacia el manual de BI
Con esto cierra el recorrido del modelado: diseñamos la estrella, versionamos su historia con SCD, la estabilizamos con claves subrogadas, la integramos con el bus matriz y ahora vimos cómo se consume en forma de cubo. El paso siguiente (como se construyen esos Intelligent Cubes, como se definen métricas y atributos, como se arman los reportes y dashboards sobre esta misma estrella) es el territorio del manual de BI, que retoma exactamente desde este punto.
Bibliografía recomendada
Fuentes directas (modelado dimensional)
Kimball, Ralph y Ross, Margy. The Data Warehouse Toolkit: The Definitive Guide to Dimensional Modeling. 3ra edición, Wiley, 2013. Obra de referencia del enfoque dimensional (grano, hechos, dimensiones, SCD, bus matriz).
Kimball Group. Dimensional Modeling Techniques (kimballgroup.com). Colección de técnicas y design tips que resumen el método; consultar la versión en línea vigente.
Documentación de producto (verificar versión)
Teradata. Documentación oficial (docs.teradata.com): diseño de base de datos, Primary Index, Partitioned Primary Index y Join Index. Verificar contra la versión de Teradata en uso.
MicroStrategy. Documentación oficial (community.microstrategy.com): Intelligent Cubes y capa OLAP. Verificar contra la versión del entorno.
Nota
Cada entrada debe cotejarse con su fuente antes de darla por fija (edición, año, URL vigente). Se listan solo obras y documentación reales y comprobables; no se incluyen referencias sin verificar.
Archivos de práctica
Con la teoría ya recorrida, esta es la parte para poner las manos en el modelo. Los archivos de abajo arman, de punta a punta, la misma estrella de e-commerce que usamos como ejemplo en todo el manual — la idea es levantarla en tu propio Teradata y poder correr ahí mismo las consultas de cada capítulo.
La base de destino es EDW_ECOMM, separada de cualquier otra base
que tengas de otros manuales de la serie. Hay dos archivos sueltos y
dos carpetas, y conviene usarlos en este orden:
00_ddl_estrella_EDW_ecomm.sqlcrea la baseEDW_ECOMMy las seis tablas del esquema estrella: las cinco dimensiones (dim_fecha,dim_geografia,dim_cliente,dim_producto,dim_medio_pago) yfact_ventas, con sus claves subrogadas y su Primary Index ya definidos. Se corre una sola vez, primero que todo.generar_dataset_EDW_ecomm.pygenera los datos de ejemplo: un script en Python que arma cada dimensión y la fact con datos coherentes entre sí. Incluye el caso de SCD Tipo 2 del Capítulo 5 (dos clientes con historia de cambio de provincia), el miembro-1“Desconocido” en cada dimensión, y el role-playing dedim_fechaentre fecha de pedido y fecha de pago. Al correrlo, deja los CSV listos.Archivos dataset csv/trae esos mismos CSV ya generados, por si preferís no correr el script y arrancar directo con los datos listos.Fastload - carga/trae los seis scripts de FastLoad (uno por tabla) que cargan esos CSV a Teradata. Van en orden: primero las cinco dimensiones, yfact_ventasal final — recién ahí la fact puede resolver sus claves foráneas contra dimensiones que ya existen.
Con los cuatro pasos hechos tenés la estrella completa y cargada, lista para correr las consultas de cada capítulo tal cual aparecen en el manual.
Archivos de práctica
Los scripts y recursos de este manual, para descargar y practicar en tu propio entorno.