MANUAL DE SQL
Desde Principiante hasta Avanzado
Con ejercicios prácticos y base de datos de ejemplo
- Compatible con: PostgreSQL 13+
Base de Datos: TechStore — Tienda de Electrónica
INTRODUCCIÓN AL MANUAL
Este manual está diseñado para acompañarte desde tus primeros pasos en SQL hasta las técnicas más avanzadas de consulta y gestión de bases de datos. Está organizado en tres grandes niveles:
-
Principiante: Fundamentos, creación de tablas y consultas básicas.
-
Intermedio: Joins, agrupaciones, subconsultas y vistas.
-
Avanzado: Expresión (WITH), funciones ventana, optimización, transacciones y procedimientos.
PARTE 1 — NIVEL PRINCIPIANTE
En esta sección aprenderás los conceptos fundamentales de SQL: qué es, cómo funciona y las instrucciones más básicas para crear tablas, insertar datos y hacer tus primeras consultas.
1.1 ¿Qué es SQL?
SQL (Structured Query Language) es el lenguaje estándar para comunicarse con bases de datos relacionales. Permite crear estructuras de datos, insertar, actualizar, eliminar y consultar información de forma eficiente.
-
SQL es declarativo: le decís QUÉ querés, no CÓMO obtenerlo.
-
Es compatible con la mayoría de los motores: MySQL, PostgreSQL, SQL Server, Oracle, SQLite.
-
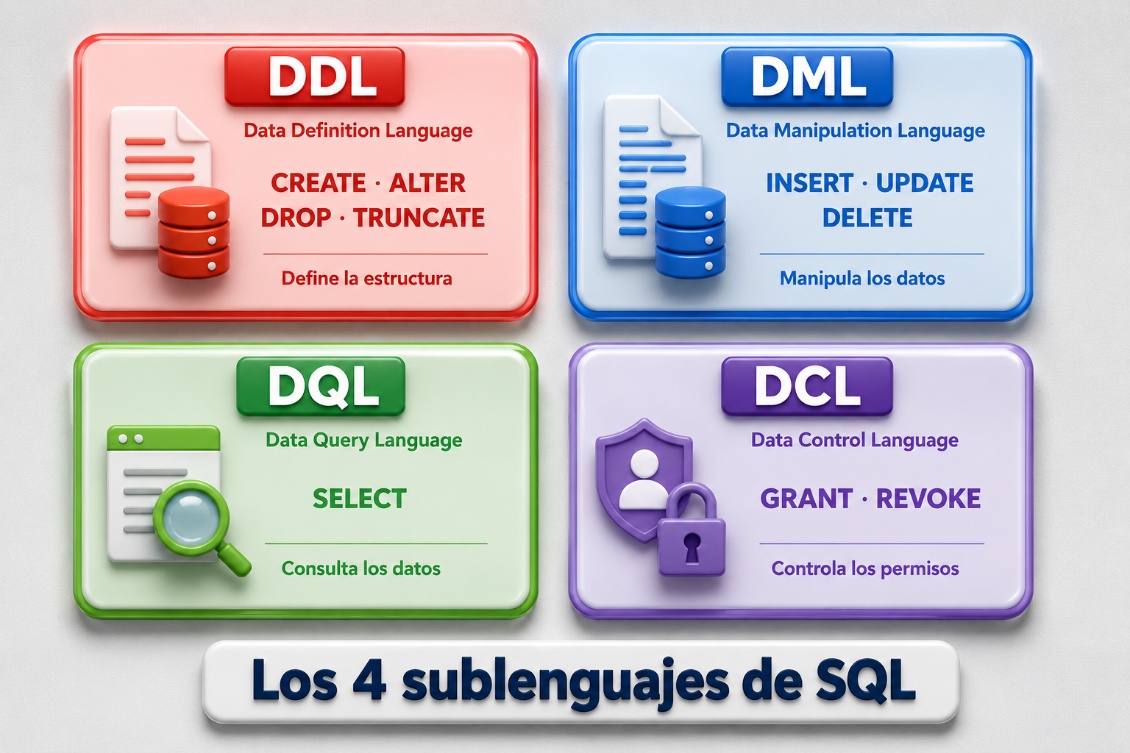
Se divide en sublenguajes: DDL, DML, DQL, DCL.
| Sublenguaje | Sigla | Comandos principales |
|---|---|---|
| Data Definition Language | DDL | CREATE, ALTER, DROP, TRUNCATE |
| Data Manipulation Language | DML | INSERT, UPDATE, DELETE |
| Data Query Language | DQL | SELECT |
| Data Control Language | DCL | GRANT, REVOKE |
1.2 DDL — Creación y modificación de tablas
Los comandos DDL sirven para definir la estructura de la base de datos.
CREATE TABLE
Crea una tabla nueva con sus columnas y tipos de datos.
CREATE TABLE clientes (
id_cliente INT PRIMARY KEY,
nombre VARCHAR(80) NOT NULL,
email VARCHAR(100) UNIQUE NOT NULL,
ciudad VARCHAR(60),
fecha_registro DATE NOT NULL
);
Tipos de datos más comunes
| Tipo | Descripción | Ejemplo |
|---|---|---|
| INT / INTEGER | Número entero | 42 |
| DECIMAL(p,s) | Número decimal con precisión | 1299.99 |
| VARCHAR(n) | Texto variable hasta n caracteres | ’Samsung Galaxy’ |
| CHAR(n) | Texto fijo de n caracteres | ’AR’ |
| DATE | Fecha (AAAA-MM-DD) | 2025-06-01 |
| DATETIME / TIMESTAMP | Fecha y hora | 2025-06-01 10:30:00 |
| BOOLEAN | Verdadero / Falso | TRUE / FALSE |
ALTER TABLE — Modificar una tabla existente
-- Agregar columna
ALTER TABLE clientes ADD COLUMN telefono VARCHAR(20);
-- Cambiar tipo de dato
ALTER TABLE clientes MODIFY COLUMN telefono VARCHAR(30);
-- Eliminar columna
ALTER TABLE clientes DROP COLUMN telefono;
DROP TABLE — Eliminar una tabla
-- Elimina la tabla y todos sus datos (¡irreversible!)
DROP TABLE clientes;
-- Elimina solo si existe (evita errores)
DROP TABLE IF EXISTS clientes;DROP TABLE borra la tabla permanentemente. Usá TRUNCATE si solo querés vaciar los datos sin eliminar la estructura.
Base de Datos de Ejemplo: TechStore
A lo largo de todo el manual trabajaremos con una base de datos de una tienda de electrónica llamada TechStore - Compatible con: PostgreSQL 13+. Todas las consultas, ejercicios y ejemplos usan estas tablas, para que puedas practicar con datos reales y coherentes.
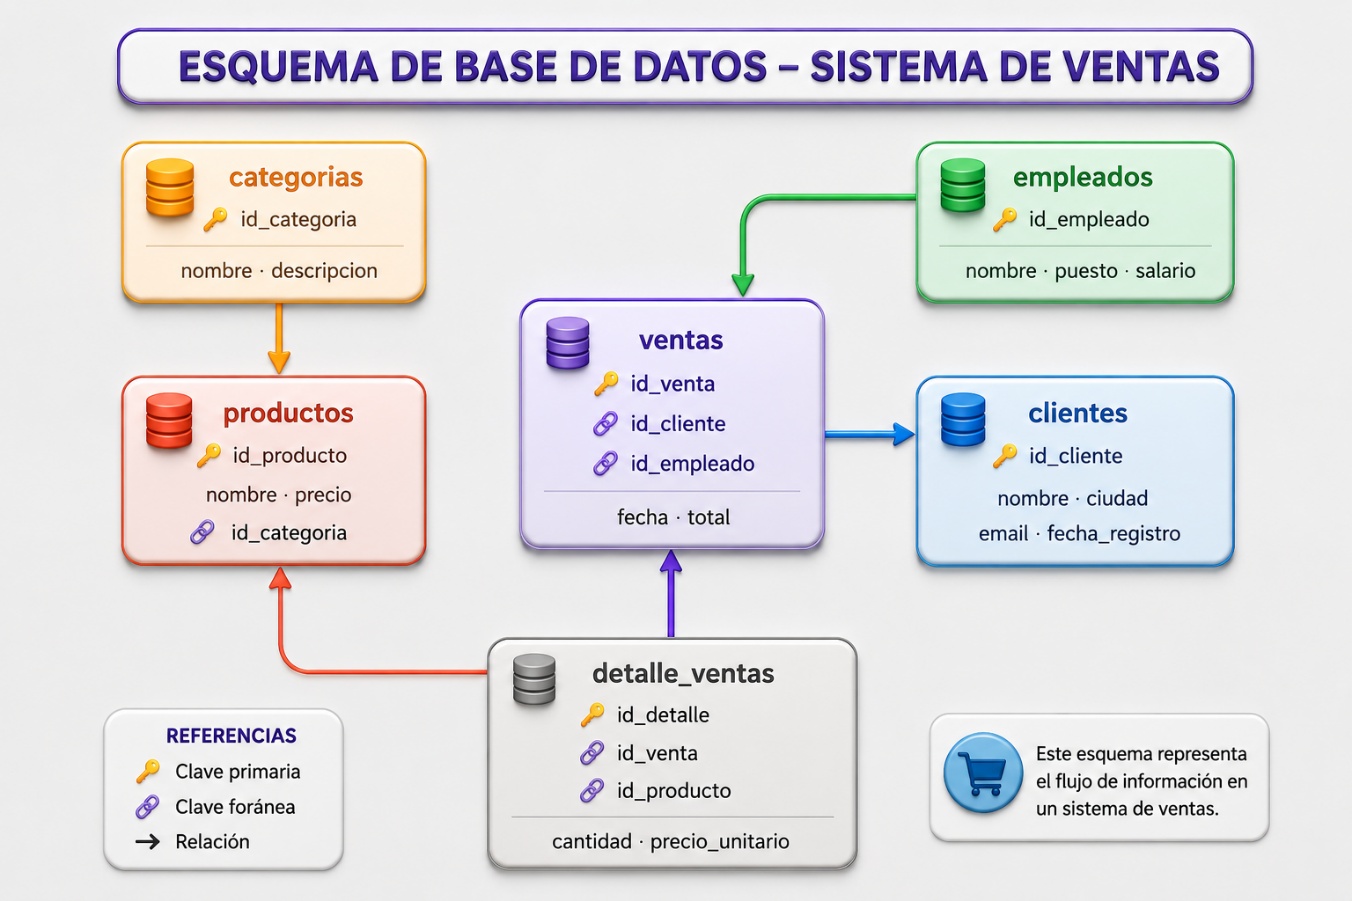
Tablas principales de TechStore
| Tabla | Descripción |
|---|---|
| clientes | Datos personales de los clientes |
| productos | Catálogo de productos electrónicos |
| categorias | Categorías de productos |
| ventas | Cabecera de cada venta |
| detalle_ventas | Líneas de cada venta (producto, cantidad, precio) |
| empleados | Vendedores y personal de la tienda |
Esquema CREATE TABLE — TechStore
-- Categorías de productos
CREATE TABLE categorias (
id_categoria INT PRIMARY KEY,
nombre VARCHAR(50) NOT NULL,
descripcion VARCHAR(200)
);
-- Clientes
CREATE TABLE clientes (
id_cliente INT PRIMARY KEY,
nombre VARCHAR(80) NOT NULL,
email VARCHAR(100) UNIQUE NOT NULL,
ciudad VARCHAR(60),
fecha_registro DATE NOT NULL
);
-- Productos
CREATE TABLE productos (
id_producto INT PRIMARY KEY,
nombre VARCHAR(100) NOT NULL,
id_categoria INT REFERENCES categorias(id_categoria),
precio NUMERIC(10,2) NOT NULL,
stock INT DEFAULT 0
);
-- Empleados
CREATE TABLE empleados (
id_empleado INT PRIMARY KEY,
nombre VARCHAR(80) NOT NULL,
puesto VARCHAR(50),
salario NUMERIC(10,2)
);
-- Ventas
CREATE TABLE ventas (
id_venta INT PRIMARY KEY,
id_cliente INT REFERENCES clientes(id_cliente),
id_empleado INT REFERENCES empleados(id_empleado),
fecha_venta DATE NOT NULL,
total NUMERIC(10,2)
);
-- Detalle de ventas
CREATE TABLE detalle_ventas (
id_detalle INT PRIMARY KEY,
id_venta INT REFERENCES ventas(id_venta),
id_producto INT REFERENCES productos(id_producto),
cantidad INT NOT NULL,
precio_unitario NUMERIC(10,2) NOT NULL
);
CARGA DE DATOS DE EJEMPLO — TechStore
A continuación, encontrarás los INSERT necesarios para poblar todas las tablas con datos reales y coherentes. Con estos 20 registros por tabla podrás practicar todas las consultas del manual con resultados significativos.
Ejecuta los INSERT en este orden para respetar las claves foráneas: categorías → empleados → clientes → productos → ventas → detalle_ventas.
1. Categorías (6 registros)
INSERT INTO categorias (id_categoria, nombre, descripcion)
VALUES
(1, 'Smartphones', 'Teléfonos inteligentes y accesorios'),
(2, 'Laptops', 'Computadoras portátiles y ultrabooks'),
(3, 'Audio', 'Auriculares, parlantes y equipos de sonido'),
(4, 'Tablets', 'Tablets y e-readers'),
(5, 'Accesorios', 'Cables, cargadores, fundas y periféricos'),
(6, 'Gaming', 'Consolas, joysticks y periféricos gamer');
2. Empleados (8 registros)
INSERT INTO empleados (id_empleado, nombre, puesto, salario)
VALUES
(1, 'Laura Méndez', 'Gerente de Ventas', 95000.00),
(2, 'Diego Fernández', 'Vendedor Senior', 72000.00),
(3, 'Sofía Ramírez', 'Vendedora Senior', 70000.00),
(4, 'Martín Torres', 'Vendedor Junior', 55000.00),
(5, 'Camila Vega', 'Vendedora Junior', 54000.00),
(6, 'Nicolás Herrera', 'Soporte Técnico', 58000.00),
(7, 'Valentina Cruz', 'Vendedora Senior', 71000.00),
(8, 'Rodrigo Sánchez', 'Vendedor Junior', 53000.00);
3. Clientes (20 registros)
INSERT INTO clientes (id_cliente, nombre, email, ciudad,
fecha_registro) VALUES
( 1, 'Ana García', 'ana.garcia@gmail.com', 'Buenos Aires',
'2023-03-15'),
( 2, 'Carlos López', 'carlos.lopez@outlook.com', 'Córdoba',
'2023-05-22'),
( 3, 'María Pérez', 'maria.perez@yahoo.com', 'Rosario',
'2023-07-10'),
( 4, 'Juan Rodríguez', 'juan.rod@gmail.com', 'Mendoza',
'2023-08-04'),
( 5, 'Lucía Martínez', 'lucia.mtz@gmail.com', 'Buenos Aires',
'2023-09-18'),
( 6, 'Pablo Gómez', 'pablo.gomez@hotmail.com', 'La Plata',
'2023-10-02'),
( 7, 'Florencia Díaz', 'flor.diaz@gmail.com', 'Córdoba',
'2023-11-14'),
( 8, 'Sebastián Ruiz', 'seba.ruiz@outlook.com', 'Tucumán',
'2024-01-08'),
( 9, 'Valentina Moreno', 'vale.moreno@gmail.com', 'Buenos Aires',
'2024-02-20'),
(10, 'Agustín Silva', 'agus.silva@gmail.com', 'Rosario',
'2024-03-05'),
(11, 'Natalia Romero', 'nati.romero@yahoo.com', 'Salta',
'2024-04-12'),
(12, 'Esteban Castro', 'este.castro@gmail.com', 'Buenos Aires',
'2024-05-03'),
(13, 'Micaela Ortiz', 'mica.ortiz@hotmail.com', 'Córdoba',
'2024-06-19'),
(14, 'Tomás Gutiérrez', 'tomas.gut@gmail.com', 'Mendoza',
'2024-07-07'),
(15, 'Camila Flores', 'cami.flores@gmail.com', 'Buenos Aires',
'2024-08-25'),
(16, 'Ignacio Molina', 'igna.molina@outlook.com', 'Neuquén',
'2024-09-14'),
(17, 'Daniela Vargas', 'dani.vargas@gmail.com', 'Rosario',
'2024-10-01'),
(18, 'Ramiro Espinoza', 'rami.espi@gmail.com', 'La Plata',
'2024-11-17'),
(19, 'Julieta Reyes', 'juli.reyes@yahoo.com', 'Tucumán',
'2024-12-09'),
(20, 'Maximiliano Ponce', 'maxi.ponce@gmail.com', 'Buenos Aires',
'2025-01-22');
4. Productos (20 registros)
INSERT INTO productos (id_producto, nombre, id_categoria, precio,
stock) VALUES
( 1, 'Samsung Galaxy S24', 1, 1299.99, 35),
( 2, 'iPhone 15 Pro', 1, 1799.99, 20),
( 3, 'Motorola Edge 40', 1, 699.99, 50),
( 4, 'Xiaomi Redmi Note 13', 1, 399.99, 80),
( 5, 'MacBook Air M3', 2, 2499.99, 15),
( 6, 'Dell XPS 15', 2, 1999.99, 18),
( 7, 'Lenovo ThinkPad E15', 2, 1199.99, 25),
( 8, 'ASUS VivoBook 15', 2, 849.99, 30),
( 9, 'Sony WH-1000XM5', 3, 449.99, 40),
(10, 'AirPods Pro 2', 3, 379.99, 45),
(11, 'JBL Charge 5', 3, 199.99, 60),
(12, 'Sennheiser HD 560S', 3, 249.99, 28),
(13, 'iPad Air M2', 4, 1099.99, 22),
(14, 'Samsung Galaxy Tab S9', 4, 899.99, 27),
(15, 'Kindle Paperwhite', 4, 199.99, 55),
(16, 'Cable USB-C 2m Anker', 5, 19.99, 200),
(17, 'Cargador 65W GaN', 5, 59.99, 90),
(18, 'Mouse Logitech MX Master 3', 5, 129.99, 48),
(19, 'Sony PlayStation 5', 6, 699.99, 12),
(20, 'Joystick DualSense Edge', 6, 249.99, 35);
5. Ventas (20 registros)
INSERT INTO ventas (id_venta, id_cliente, id_empleado,
fecha_venta, total) VALUES
( 1, 5, 2, '2024-01-10', 1299.99),
( 2, 3, 3, '2024-01-22', 2499.99),
( 3, 1, 2, '2024-02-05', 449.99),
( 4, 8, 4, '2024-02-18', 1799.99),
( 5, 2, 7, '2024-03-03', 699.99),
( 6, 12, 3, '2024-03-21', 1329.98),
( 7, 9, 2, '2024-04-07', 2499.99),
( 8, 6, 5, '2024-04-19', 379.99),
( 9, 15, 7, '2024-05-02', 1199.99),
(10, 4, 4, '2024-05-28', 899.99),
(11, 10, 2, '2024-06-11', 449.98),
(12, 13, 3, '2024-06-30', 1099.99),
(13, 7, 7, '2024-07-15', 699.99),
(14, 17, 5, '2024-07-29', 249.99),
(15, 1, 2, '2024-08-12', 2199.98),
(16, 20, 3, '2024-09-04', 199.99),
(17, 11, 7, '2024-09-23', 1799.99),
(18, 14, 4, '2024-10-08', 729.98),
(19, 16, 2, '2024-11-01', 1299.99),
(20, 9, 3, '2024-12-15', 949.98);
6. Detalle de ventas (20 registros)
INSERT INTO detalle_ventas (id_detalle, id_venta, id_producto,
cantidad, precio_unitario) VALUES
( 1, 1, 1, 1, 1299.99),
( 2, 2, 5, 1, 2499.99),
( 3, 3, 9, 1, 449.99),
( 4, 4, 2, 1, 1799.99),
( 5, 5, 3, 1, 699.99),
( 6, 6, 1, 1, 1299.99),
( 7, 6, 16, 2, 19.99),
( 8, 7, 5, 1, 2499.99),
( 9, 8, 10, 1, 379.99),
(10, 9, 7, 1, 1199.99),
(11, 10, 14, 1, 899.99),
(12, 11, 9, 1, 449.99),
(13, 11, 17, 1, 59.99),
(14, 12, 13, 1, 1099.99),
(15, 13, 3, 1, 699.99),
(16, 14, 20, 1, 249.99),
(17, 15, 6, 1, 1999.99),
(18, 15, 18, 1, 129.99),
(19, 16, 15, 1, 199.99),
(20, 17, 2, 1, 1799.99),
(21, 18, 4, 1, 399.99),
(22, 18, 17, 2, 59.99),
(23, 19, 1, 1, 1299.99),
(24, 20, 14, 1, 899.99),
(25, 20, 11, 1, 199.99);
Resumen del dataset
| Tabla | Registros | Notas |
|---|---|---|
| categorías | 6 | 6 categorías de productos electrónicos |
| empleados | 8 | Vendedores con distintos puestos y salarios |
| clientes | 20 | De 5 ciudades distintas, registrados entre 2023–2025 |
| productos | 20 | Precios de $19.99 a $2499.99, distribuidos en las 6 categorías |
| ventas | 20 | Ventas de 2024 completo, distintos vendedores y clientes |
| detalle_ventas | 25 | Algunas ventas tienen múltiples productos (líneas extra) |
Algunos clientes (como Ana García o Valentina Moreno) tienen múltiples compras, lo que permite practicar consultas de historial y totales acumulados. Cinco clientes no tienen ventas registradas, ideal para practicar LEFT JOIN.
1.3 DML — INSERT, UPDATE, DELETE
INSERT — Insertar datos
-- Insertar un registro
INSERT INTO clientes (id_cliente, nombre, email, ciudad, fecha_registro)
VALUES (1, 'Ana García', 'ana@email.com', 'Buenos Aires', '2024-01-15');
-- Insertar varios registros a la vez
INSERT INTO clientes (id_cliente, nombre, email, ciudad, fecha_registro)
VALUES
(2, 'Carlos López', 'carlos@email.com', 'Córdoba', '2024-02-20'),
(3, 'María Pérez', 'maria@email.com', 'Rosario', '2024-03-10'),
(4, 'Juan Rodríguez', 'juan@email.com', 'Mendoza', '2024-04-05');
UPDATE — Actualizar datos
-- Actualizar un campo específico
UPDATE clientes
SET ciudad = 'La Plata'
WHERE id_cliente = 1;
-- Actualizar múltiples campos
UPDATE productos
SET precio = 1199.99, stock = stock + 10
WHERE id_producto = 5;Siempre usá WHERE en UPDATE y DELETE. Sin WHERE, la operación afecta a TODOS los registros de la tabla.
DELETE — Eliminar datos
-- Eliminar un registro específico
DELETE FROM clientes WHERE id_cliente = 4;
-- Eliminar con condición
DELETE FROM productos WHERE stock = 0;
1.4 SELECT — Consultas básicas
SELECT es el comando más usado en SQL. Permite recuperar datos de una o varias tablas.
Sintaxis básica
SELECT columna1, columna2, ...
FROM tabla
WHERE condicion
ORDER BY columna [ASC | DESC]
LIMIT n;
Ejemplos con TechStore
-- Todos los clientes
SELECT * FROM clientes;
-- Solo nombre y ciudad
SELECT nombre, ciudad FROM clientes;
-- Clientes de Buenos Aires
SELECT nombre, email FROM clientes
WHERE ciudad = 'Buenos Aires';
-- Productos con precio mayor a 500
SELECT nombre, precio FROM productos
WHERE precio > 500
ORDER BY precio DESC;
-- Los 5 productos más caros
SELECT nombre, precio FROM productos
ORDER BY precio DESC
LIMIT 5;
1.5 Operadores y condiciones
| Operador | Descripción | Ejemplo |
|---|---|---|
| = | Igual | ciudad = ‘Córdoba’ |
| <> o != | Distinto | ciudad <> ‘Córdoba’ |
| > < >= <= | Comparación numérica | precio >= 1000 |
| BETWEEN | Entre dos valores (inclusivo) | precio BETWEEN 500 AND 1500 |
| IN (…) | En una lista de valores | ciudad IN (‘BA’, ‘Córdoba’) |
| LIKE | Coincidencia de texto | nombre LIKE ‘Mar%‘ |
| IS NULL | Valor nulo | telefono IS NULL |
| AND / OR / NOT | Lógica combinada | stock > 0 AND precio < 500 |
-- BETWEEN
SELECT nombre, precio FROM productos
WHERE precio BETWEEN 300 AND 800;
-- LIKE (% = cualquier cadena, _ = un carácter)
SELECT nombre FROM clientes WHERE nombre ILIKE 'Mar%';
-- IN
SELECT nombre, ciudad FROM clientes
WHERE ciudad IN ('Buenos Aires', 'Córdoba', 'Rosario');
-- IS NULL
SELECT nombre FROM clientes WHERE ciudad IS NULL;
1.6 Funciones de agregación
| Función | Descripción |
|---|---|
| COUNT(*) | Cuenta el número de filas |
| COUNT(columna) | Cuenta valores no nulos |
| SUM(columna) | Suma total |
| AVG(columna) | Promedio |
| MIN(columna) | Valor mínimo |
| MAX(columna) | Valor máximo |
-- Total de clientes
SELECT COUNT(*) AS total_clientes FROM clientes;
-- Precio promedio de productos
SELECT AVG(precio) AS precio_promedio FROM productos;
-- Precio mínimo y máximo
SELECT MIN(precio) AS mas_barato, MAX(precio) AS mas_caro FROM productos;
-- Total de ventas registradas
SELECT SUM(total) AS facturacion_total FROM ventas;
1.7 Ejercicios Prácticos — Principiante
Ejercicio 1: Mostrar todos los productos con stock mayor a 0, ordenados por nombre.
Solución SQL:
SELECT nombre, precio, stock
FROM productos
WHERE stock > 0
ORDER BY nombre ASC;
Resultado esperado:
Lista de productos disponibles ordenados alfabéticamente.
Ejercicio 2: Encontrar todos los clientes registrados después del 1 de enero de 2024. Solución SQL:
SELECT nombre, email, fecha_registro
FROM clientes
WHERE fecha_registro > '2024-01-01'
ORDER BY fecha_registro ASC;
Resultado esperado: Clientes registrados en 2024 o posterior.
Ejercicio 3: ¿Cuántos productos hay en cada rango de precio? Usar CASE para clasificarlos.
Solución SQL:
SELECT
CASE
WHEN precio < 500 THEN 'Económico'
WHEN precio < 1500 THEN 'Medio'
ELSE 'Premium'
END AS rango_precio,
COUNT(*) AS cantidad
FROM productos
GROUP BY rango_precio;
Resultado esperado:
Distribución de productos por rango de precio.
Ejercicio 4: Insertar un nuevo producto: ‘Auriculares Bluetooth Pro’, categoría 3, precio $299.99, stock 50.
Solución SQL:
INSERT INTO productos (id_producto, nombre, id_categoria, precio, stock)
VALUES (101, 'Auriculares Bluetooth Pro', 3, 299.99, 50);
Resultado esperado:
1 fila insertada correctamente.
Ejercicio 5: Actualizar el stock de todos los productos de la categoría 1 aumentándolo en 20 unidades.
Solución SQL:
UPDATE productos
SET stock = stock + 20
WHERE id_categoria = 1;
Resultado esperado:
Filas actualizadas según la cantidad de productos en categoría 1.
PARTE 2 — NIVEL INTERMEDIO
Ya dominas las bases. Ahora es momento de combinar tablas, agrupar datos, usar subconsultas y aprovechar vistas para simplificar consultas complejas.
2.1 GROUP BY y HAVING
GROUP BY agrupa filas que tienen el mismo valor en una columna. Se usa junto con funciones de agregación. HAVING filtra los grupos (es como un WHERE pero para grupos).
-- Ventas totales por ciudad
SELECT c.ciudad, COUNT(v.id_venta) AS total_ventas, SUM(v.total) AS monto_total
FROM clientes c
JOIN ventas v ON c.id_cliente = v.id_cliente
GROUP BY c.ciudad
ORDER BY monto_total DESC;
-- Categorías con más de 5 productos
SELECT cat.nombre AS categoria, COUNT(p.id_producto) AS cantidad
FROM categorias cat
JOIN productos p ON cat.id_categoria = p.id_categoria
GROUP BY cat.nombre
HAVING COUNT(p.id_producto) > 5;Diferencia clave: WHERE filtra FILAS antes de agrupar. HAVING filtra GRUPOS después de agrupar.
2.2 JOINs — Combinación de tablas
Los JOINs permiten combinar datos de dos o más tablas usando una condición de unión.
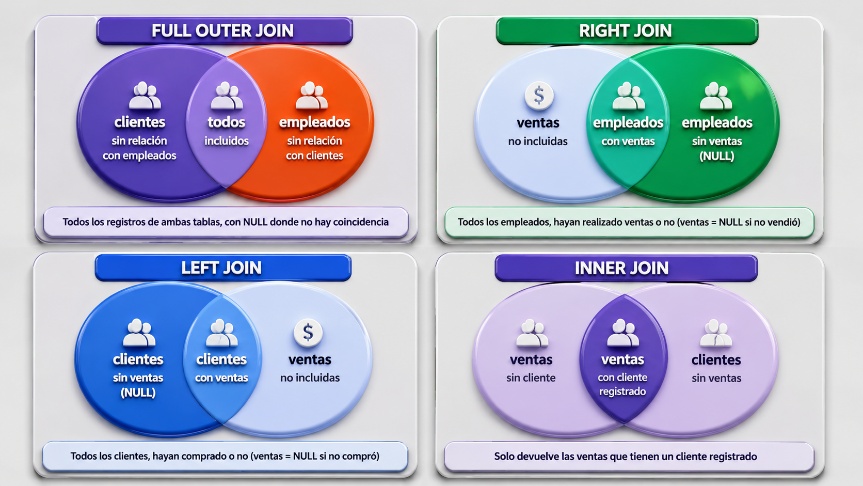
INNER JOIN — Solo registros que coinciden en ambas tablas
-- Ventas con nombre de cliente
SELECT v.id_venta, c.nombre AS cliente, v.fecha_venta, v.total
FROM ventas v
INNER JOIN clientes c ON v.id_cliente = c.id_cliente
ORDER BY v.fecha_venta DESC;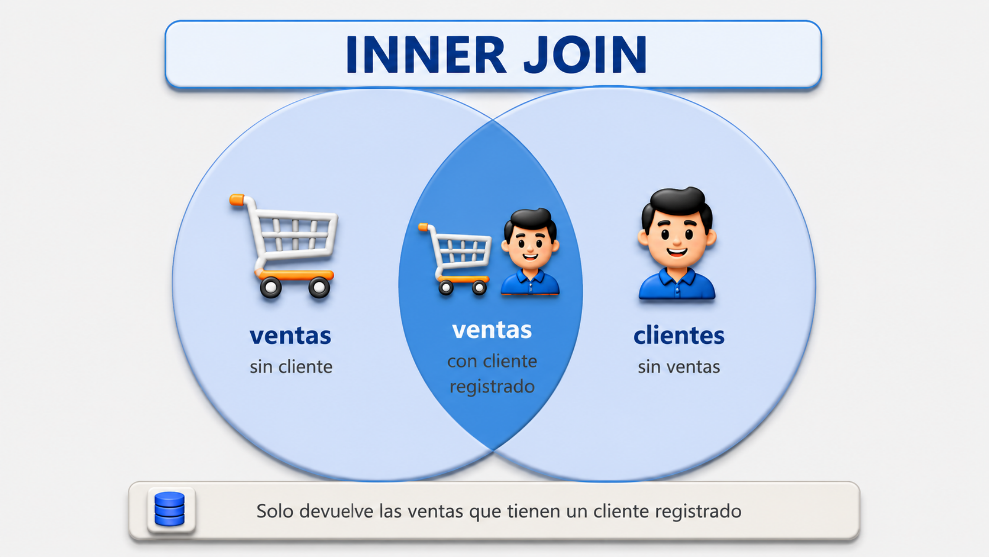
LEFT JOIN — Todos los registros de la tabla izquierda
-- Todos los clientes, hayan comprado o no
SELECT c.nombre, COUNT(v.id_venta) AS compras
FROM clientes c
LEFT JOIN ventas v ON c.id_cliente = v.id_cliente
GROUP BY c.nombre
ORDER BY compras DESC;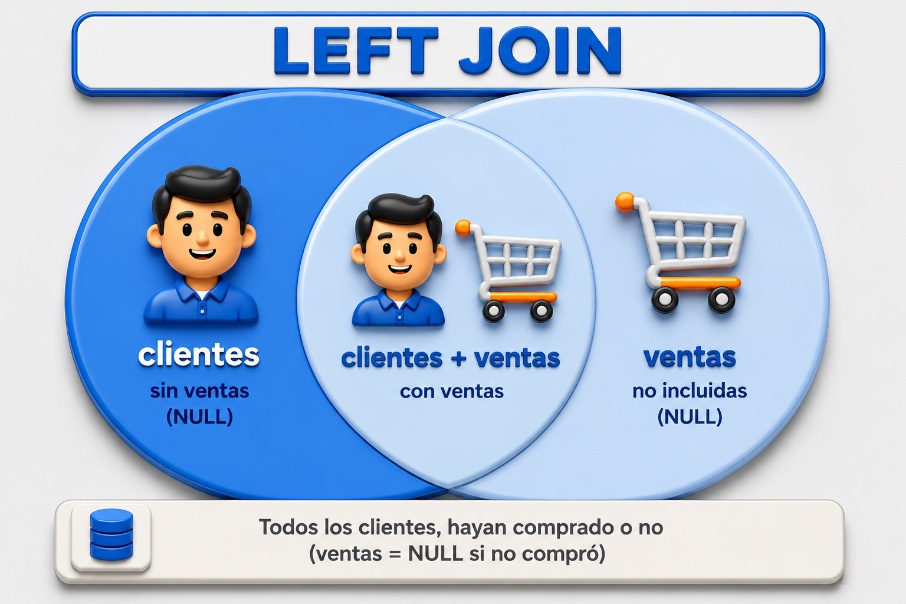
RIGHT JOIN — Todos los registros de la tabla derecha
-- Todos los empleados, hayan tenido ventas o no
SELECT e.nombre AS empleado, COUNT(v.id_venta) AS ventas_realizadas
FROM ventas v
RIGHT JOIN empleados e ON v.id_empleado = e.id_empleado
GROUP BY e.nombre;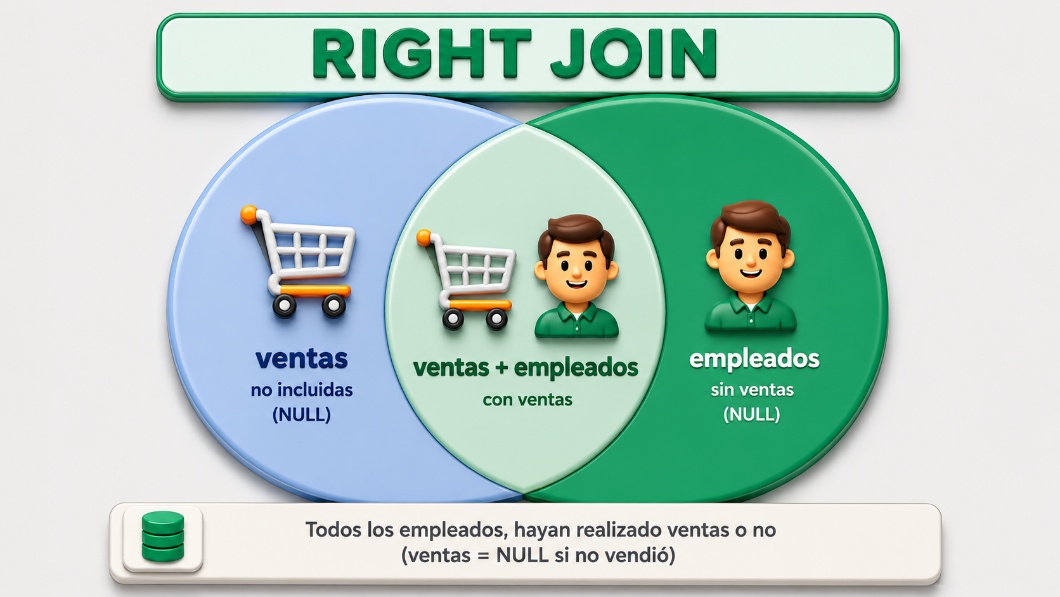
FULL OUTER JOIN — Todos los registros de ambas tablas
-- Clientes y empleados, aunque no tengan relación
SELECT c.nombre AS cliente, e.nombre AS empleado
FROM clientes c
FULL OUTER JOIN empleados e ON c.id_cliente = e.id_empleado;
-- PostgreSQL soporta FULL OUTER JOIN nativo.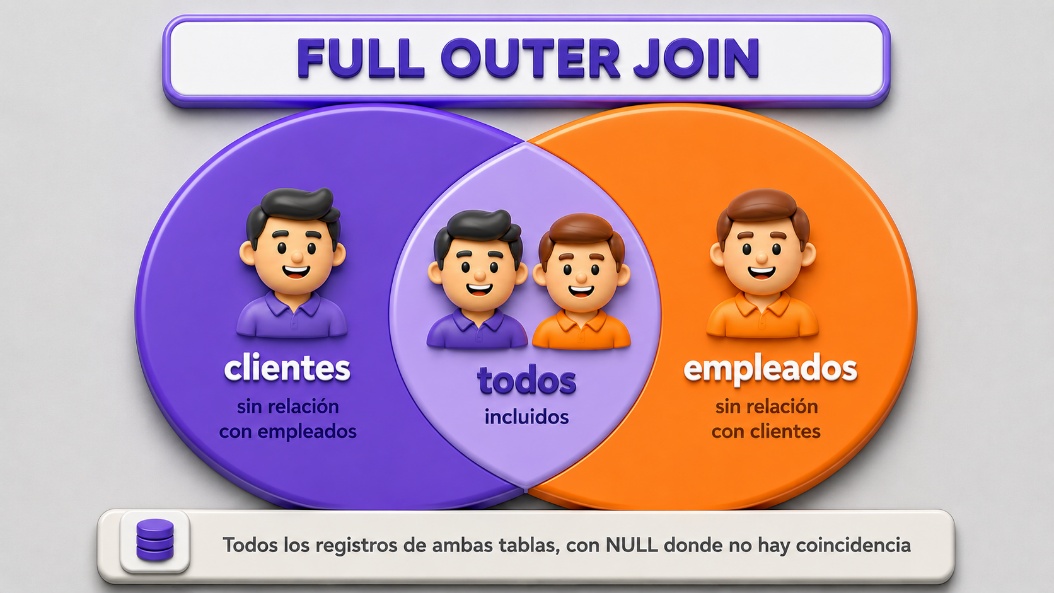
JOIN múltiple — Tres o más tablas
-- Detalle de ventas con nombre de cliente y producto
SELECT
c.nombre AS cliente,
p.nombre AS producto,
dv.cantidad,
dv.precio_unitario,
(dv.cantidad * dv.precio_unitario) AS subtotal
FROM detalle_ventas dv
INNER JOIN ventas v ON dv.id_venta = v.id_venta
INNER JOIN clientes c ON v.id_cliente = c.id_cliente
INNER JOIN productos p ON dv.id_producto = p.id_producto
ORDER BY c.nombre, v.fecha_venta;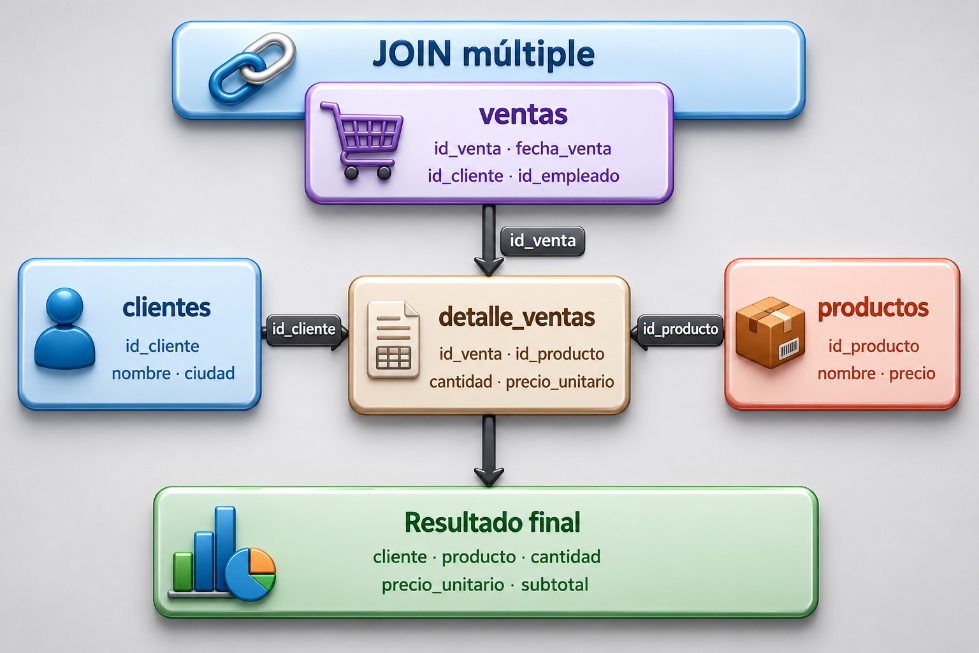
2.3 Subconsultas (Subqueries)
Una subconsulta es una consulta dentro de otra. Se usa en SELECT, FROM o WHERE.
Subconsulta en WHERE
-- Clientes que han realizado al menos una compra
SELECT nombre, ciudad FROM clientes
WHERE id_cliente IN (
SELECT DISTINCT id_cliente FROM ventas
);
-- Productos más caros que el promedio
SELECT nombre, precio FROM productos
WHERE precio > (SELECT AVG(precio) FROM productos);
Subconsulta en FROM (tabla derivada)
-- Promedio de ventas por cliente, luego filtrar los top
SELECT cliente, promedio_compra
FROM (
SELECT c.nombre AS cliente, AVG(v.total) AS promedio_compra
FROM clientes c
JOIN ventas v ON c.id_cliente = v.id_cliente
GROUP BY c.nombre
) AS resumen
WHERE promedio_compra > 1000
ORDER BY promedio_compra DESC;
Subconsulta correlacionada
-- Para cada producto, mostrar si tiene ventas registradas
SELECT
p.nombre,
p.precio,
CASE WHEN EXISTS (
SELECT 1 FROM detalle_ventas dv
WHERE dv.id_producto = p.id_producto
) THEN 'Con ventas' ELSE 'Sin ventas' END AS estado
FROM productos p;
2.4 Vistas (VIEWS)
Una vista es una consulta SQL guardada con un nombre, que se puede usar como si fuera una tabla. No almacena datos por sí misma: cada vez que la consultas, ejecuta la consulta original en ese momento.
¿Para qué sirven las vistas?
-
Simplificar consultas complejas que se repiten frecuentemente.
-
Ocultar la complejidad del modelo de datos a los usuarios finales.
-
Restringir el acceso a columnas sensibles (seguridad).
-
Crear una capa de abstracción entre la aplicación y las tablas reales.
Vista normal — CREATE VIEW
La vista normal es una consulta almacenada. No guarda datos: cada vez que la usás, re-ejecuta la consulta contra las tablas base. Si los datos cambian, la vista refleja esos cambios automáticamente.
-- Crear vista: resumen de ventas por cliente
CREATE VIEW v_resumen_ventas AS
SELECT
c.nombre AS cliente,
c.ciudad,
COUNT(v.id_venta) AS total_ventas,
SUM(v.total) AS monto_total,
ROUND(AVG(v.total),2) AS ticket_promedio
FROM clientes c
JOIN ventas v ON c.id_cliente = v.id_cliente
GROUP BY c.nombre, c.ciudad;
-- Usarla como si fuera una tabla
SELECT * FROM v_resumen_ventas;
-- Filtrar sobre la vista
SELECT * FROM v_resumen_ventas WHERE ciudad = 'Buenos Aires';
-- Ordenar sobre la vista
SELECT * FROM v_resumen_ventas ORDER BY monto_total DESC;
-- Eliminar la vista
DROP VIEW IF EXISTS v_resumen_ventas;
Vista Materializada — MATERIALIZED VIEW
Una vista materializada sí almacena físicamente los datos del resultado en disco, como si fuera una tabla real. No se actualiza automáticamente: hay que refrescarla manualmente o programar el refresco. A cambio, las consultas son mucho más rápidas porque no recalcula nada.
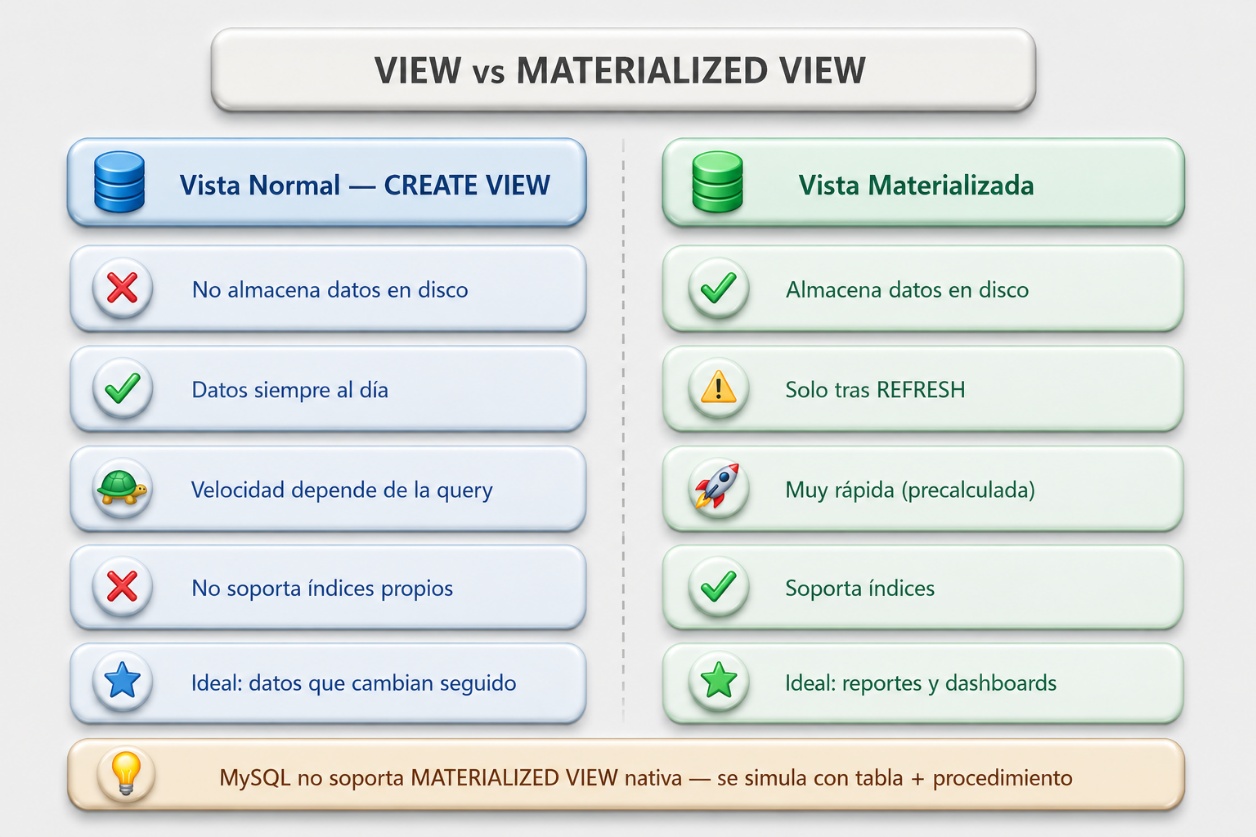
Las vistas materializadas son nativas en PostgreSQL, Oracle y SQL Server. En MySQL no existen de forma nativa: se simulan con una tabla + procedimiento + evento programado (ver ejemplo más abajo).
-- ── POSTGRESQL ────────────────────────────────────────────
-- Crear vista materializada
CREATE MATERIALIZED VIEW mv_resumen_ventas AS
SELECT
c.nombre AS cliente,
c.ciudad,
COUNT(v.id_venta) AS total_ventas,
SUM(v.total) AS monto_total,
ROUND(AVG(v.total),2) AS ticket_promedio
FROM clientes c
JOIN ventas v ON c.id_cliente = v.id_cliente
GROUP BY c.nombre, c.ciudad;
-- Consultar (lee datos guardados en disco, muy rápido)
SELECT * FROM mv_resumen_ventas ORDER BY monto_total DESC;
-- Refrescar manualmente (actualiza los datos guardados)
REFRESH MATERIALIZED VIEW mv_resumen_ventas;
-- Refrescar sin bloquear las lecturas (no bloquea la tabla)
REFRESH MATERIALIZED VIEW CONCURRENTLY mv_resumen_ventas;
-- Agregar índice sobre la vista materializada (igual que una tabla)
CREATE INDEX idx_mv_ciudad ON mv_resumen_ventas(ciudad);
-- Eliminar
DROP MATERIALIZED VIEW IF EXISTS mv_resumen_ventas;
Vista Materializada en PostgreSQL (soporte nativo)
PostgreSQL soporta MATERIALIZED VIEW de forma nativa. No se necesita ninguna simulación: se crea con una sola sentencia y se refresca con REFRESH.
-- ── MYSQL — Simulación con tabla + procedimiento + evento ──
-- 1. Crear la tabla que actúa como vista materializada
CREATE TABLE IF NOT EXISTS mv_resumen_ventas (
cliente VARCHAR(80),
ciudad VARCHAR(60),
total_ventas INT,
monto_total NUMERIC(10,2),
ticket_promedio NUMERIC(10,2),
actualizado_en DATETIME
);
-- 2. Procedimiento que recarga los datos
CREATE PROCEDURE refrescar_mv_resumen_ventas()
BEGIN
TRUNCATE TABLE mv_resumen_ventas;
INSERT INTO mv_resumen_ventas
(cliente, ciudad, total_ventas, monto_total, ticket_promedio, actualizado_en)
SELECT
c.nombre,
c.ciudad,
COUNT(v.id_venta),
SUM(v.total),
ROUND(AVG(v.total), 2),
NOW()
FROM clientes c
JOIN ventas v ON c.id_cliente = v.id_cliente
GROUP BY c.nombre, c.ciudad;
END;
$$;
-- 3. Ejecutar el procedimiento para cargar datos por primera vez
CALL refrescar_mv_resumen_ventas();
-- 4. Programar refresco automático cada hora (requiere EVENT SCHEDULER activo)
-- 5. Consultar (igual que una tabla, muy rápido)
SELECT * FROM mv_resumen_ventas ORDER BY monto_total DESC;
Comparativa: Vista Normal vs Vista Materializada
| Característica | Vista Normal | Vista Materializada |
|---|---|---|
| ¿Almacena datos? | ❌ No — re-ejecuta siempre | ✅ Sí — guarda en disco |
| ¿Datos siempre al día? | ✅ Sí — refleja cambios al instante | ⚠️ Solo tras REFRESH |
| Velocidad de consulta | Depende de la query base | Muy rápida (datos precalculados) |
| ¿Soporta índices? | ❌ No | ✅ Sí |
| ¿Ocupa espacio en disco? | ❌ No | ✅ Sí |
| Ideal para… | Datos que cambian frecuentemente | Reportes y dashboards pesados |
| PostgreSQL nativo | ✅ Sí | ✅ Sí |
| PostgreSQL nativo | ✅ Sí | ✅ Sí |
| Comando para crear | CREATE VIEW | CREATE MATERIALIZED VIEW |
| Comando para actualizar | Automático | REFRESH MATERIALIZED VIEW |
¿Cuándo usar cada una?
-
Vista normal: cuando los datos cambian seguido y necesitas siempre el valor más reciente (stock en tiempo real, saldo de cuenta, estado de pedido).
-
Vista materializada: cuando la consulta base es costosa (muchos JOINs, GROUP BY, millones de filas) y los datos no necesitan ser exactos al segundo (reportes diarios, dashboards de ventas, estadísticas históricas).
-
Regla práctica: si el reporte tarda más de 2 segundos en generarse y se consulta muchas veces por día, es candidato a vista materializada.
En Neon.tech (PostgreSQL) podés probar MATERIALIZED VIEW directamente. Creá la vista, insertá una venta nueva, consultá la vista (no se actualiza) y luego ejecutá REFRESH para ver la diferencia.
2.5 UNION y UNION ALL
UNION combina los resultados de dos o más SELECT en un solo resultado. Las columnas deben ser compatibles en cantidad y tipo.
-- UNION elimina duplicados
SELECT nombre, 'cliente' AS tipo FROM clientes
UNION
SELECT nombre, 'empleado' AS tipo FROM empleados;
-- UNION ALL mantiene duplicados (más rápido)
SELECT ciudad FROM clientes
UNION ALL
SELECT ciudad FROM empleados;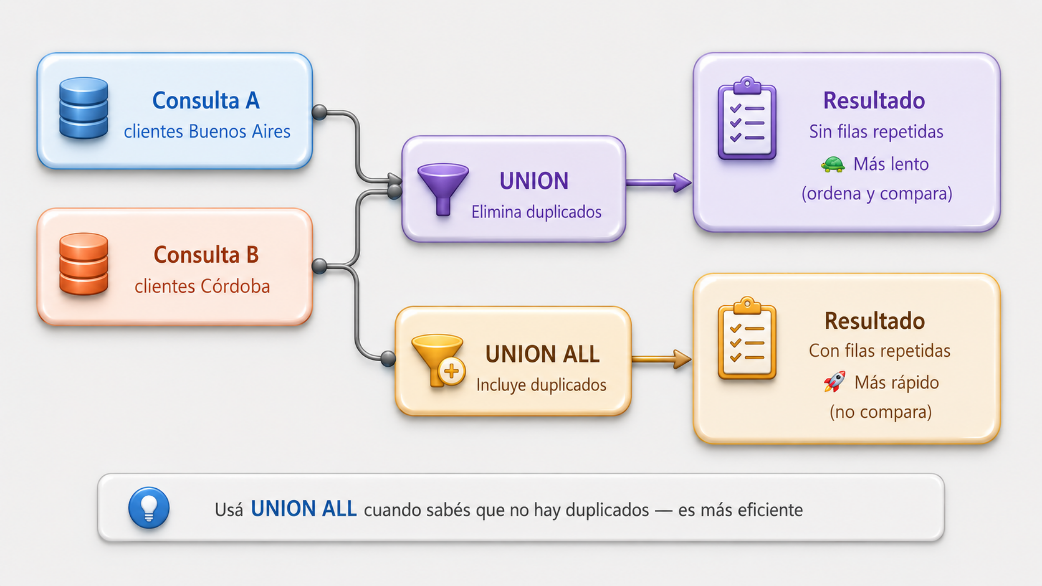
2.6 Funciones de texto y fecha
| Función | Descripción | Ejemplo |
|---|---|---|
| UPPER(s) | Texto en mayúsculas | UPPER(‘hola’) → ‘HOLA’ |
| LOWER(s) | Texto en minúsculas | LOWER(‘HOLA’) → ‘hola’ |
| LENGTH(s) | Longitud de cadena | LENGTH(‘SQL’) → 3 |
| SUBSTRING(s,i,n) | Extrae subcadena | SUBSTRING(‘Hola’,1,2) → ‘Ho’ |
| CONCAT(a,b) | Concatena cadenas | CONCAT(‘Ho’,‘la’) → ‘Hola’ |
| TRIM(s) | Elimina espacios | TRIM(’ hola ’) → ‘hola’ |
| NOW() | Fecha y hora actual | NOW() |
| EXTRACT(YEAR FROM d) | Extrae año | EXTRACT(YEAR FROM ‘2025-06-01’::DATE) → 2025 |
| EXTRACT(MONTH FROM d) | Extrae mes | EXTRACT(MONTH FROM ‘2025-06-01’::DATE) → 6 |
| (a::DATE - b::DATE) | Diferencia en días | DATEDIFF(NOW(),‘2024-01-01’) |
-- Nombre completo en mayúsculas
SELECT UPPER(nombre) AS nombre_up, email FROM clientes;
-- Año de registro
SELECT nombre, EXTRACT(YEAR FROM fecha_registro) AS anio FROM clientes;
-- Días desde la última venta
SELECT id_venta, (CURRENT_DATE - fecha_venta) AS dias_desde_venta
FROM ventas ORDER BY dias_desde_venta;
2.7 Ejercicios Prácticos — Intermedio
Ejercicio 6: Listar los 5 productos más vendidos (por cantidad total vendida).
Solución SQL:
SELECT p.nombre, SUM(dv.cantidad) AS total_vendido
FROM detalle_ventas dv
INNER JOIN productos p ON dv.id_producto = p.id_producto
GROUP BY p.nombre
ORDER BY total_vendido DESC
LIMIT 5;
Resultado esperado:
Top 5 productos con mayor cantidad de unidades vendidas.
Ejercicio 7: Mostrar clientes que NO han realizado ninguna compra.
Solución SQL:
SELECT c.nombre, c.email, c.ciudad
FROM clientes c
LEFT JOIN ventas v ON c.id_cliente = v.id_cliente
WHERE v.id_venta IS NULL;
Resultado esperado:
Clientes sin compras registradas en el sistema.
Ejercicio 8: Crear una vista que muestre el ranking de empleados por total facturado.
Solución SQL:
CREATE VIEW v_ranking_empleados AS
SELECT
e.nombre AS empleado,
e.puesto,
COUNT(v.id_venta) AS ventas_realizadas,
SUM(v.total) AS total_facturado
FROM empleados e
LEFT JOIN ventas v ON e.id_empleado = v.id_empleado
GROUP BY e.nombre, e.puesto
ORDER BY total_facturado DESC;
-- Consultar la vista
SELECT * FROM v_ranking_empleados;
Resultado esperado:
Vista creada con el ranking de empleados por performance de ventas.
Ejercicio 9: Mostrar el producto más caro de cada categoría.
Solución SQL:
SELECT cat.nombre AS categoria,
p.nombre AS producto,
p.precio
FROM productos p
INNER JOIN categorias cat ON p.id_categoria = cat.id_categoria
WHERE p.precio = (
SELECT MAX(p2.precio)
FROM productos p2
WHERE p2.id_categoria = p.id_categoria
);
Resultado esperado:
El producto más caro de cada categoría del catálogo.
Ejercicio 10: Calcular la facturación mensual del año 2024.
Solución SQL:
SELECT
EXTRACT(YEAR FROM fecha_venta) AS anio,
EXTRACT(MONTH FROM fecha_venta) AS mes,
COUNT(*) AS cantidad_ventas,
SUM(total) AS facturacion
FROM ventas
WHERE EXTRACT(YEAR FROM fecha_venta) = 2024
GROUP BY EXTRACT(YEAR FROM fecha_venta), EXTRACT(MONTH FROM fecha_venta)
ORDER BY mes;
Resultado esperado:
Facturación mensual desglosada para el año 2024.
PARTE 3 — NIVEL AVANZADO
En esta sección abordamos técnicas avanzadas: CTEs, funciones de ventana, índices, procedimientos almacenados, transacciones y estrategias de optimización de consultas.
3.1 CTEs — Common Table Expressions (WITH)
Las CTEs son consultas temporales nombradas que se definen al inicio de una sentencia. Hacen el código más legible y permiten reutilizar resultados intermedios.
CTE simple
WITH clientes_activos AS (
SELECT DISTINCT id_cliente FROM ventas
WHERE fecha_venta >= '2024-01-01'
)
SELECT c.nombre, c.ciudad, c.email
FROM clientes c
WHERE c.id_cliente IN (SELECT id_cliente FROM
clientes_activos);
CTEs encadenadas
WITH
-- CTE 1: Total de ventas por cliente
ventas_cliente AS (
SELECT id_cliente, SUM(total) AS monto_total
FROM ventas
GROUP BY id_cliente
),
-- CTE 2: Clasificar clientes por volumen
segmento AS (
SELECT
c.nombre,
vc.monto_total,
CASE
WHEN vc.monto_total > 10000 THEN 'VIP'
WHEN vc.monto_total > 5000 THEN 'Frecuente'
ELSE 'Ocasional'
END AS segmento
FROM clientes c
JOIN ventas_cliente vc ON c.id_cliente = vc.id_cliente
)
SELECT segmento, COUNT(*) AS total_clientes
FROM segmento
GROUP BY segmento;
CTE recursiva — Jerarquías
-- Ejemplo: estructura de empleados con jerarquía
-- (requiere columna id_jefe en empleados)
WITH RECURSIVE jerarquia AS (
-- Caso base: empleados sin jefe
SELECT id_empleado, nombre, id_jefe, 0 AS nivel
FROM empleados WHERE id_jefe IS NULL
UNION ALL
-- Recursión: empleados subordinados
SELECT e.id_empleado, e.nombre, e.id_jefe, j.nivel + 1
FROM empleados e
JOIN jerarquia j ON e.id_jefe = j.id_empleado
)
SELECT nivel, nombre FROM jerarquia ORDER BY nivel, nombre;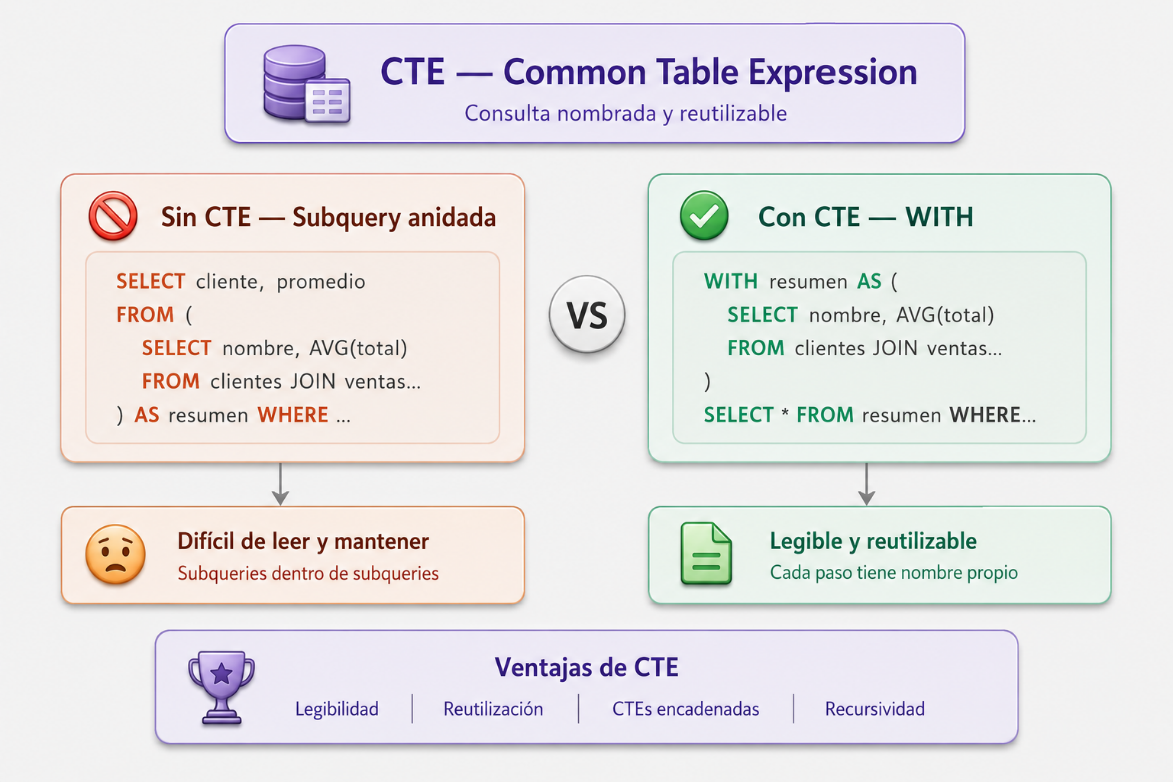
3.2 Funciones de Ventana (Window Functions)
Las funciones de ventana realizan cálculos sobre un conjunto de filas relacionadas con la fila actual, sin colapsar el resultado como hace GROUP BY.
Sintaxis general
función_ventana() OVER (
PARTITION BY columna_agrupacion
ORDER BY columna_orden
ROWS BETWEEN ... AND ...
)| Función | Descripción |
|---|---|
| ROW_NUMBER() | Número de fila único dentro de la partición |
| RANK() | Rango con saltos (1, 2, 2, 4) |
| DENSE_RANK() | Rango sin saltos (1, 2, 2, 3) |
| LEAD(col, n) | Valor de n filas hacia adelante |
| LAG(col, n) | Valor de n filas hacia atrás |
| SUM() OVER | Suma acumulada o por partición |
| AVG() OVER | Promedio por partición |
| FIRST_VALUE(col) | Primer valor de la partición |
| LAST_VALUE(col) | Último valor de la partición |
| NTILE(n) | Divide en n grupos iguales |
ROW_NUMBER y RANK
-- Ranking de productos por precio dentro de cada categoría
SELECT
cat.nombre AS categoria,
p.nombre AS producto,
p.precio,
ROW_NUMBER() OVER (
PARTITION BY p.id_categoria
ORDER BY p.precio DESC
) AS posicion,
DENSE_RANK() OVER (
PARTITION BY p.id_categoria
ORDER BY p.precio DESC
) AS ranking
FROM productos p
JOIN categorias cat ON p.id_categoria = cat.id_categoria;
LAG y LEAD — Comparar con filas anteriores/siguientes
WITH mensual AS (
SELECT
TO_CHAR(fecha_venta, 'YYYY-MM') AS mes,
SUM(total) AS total_mes
FROM ventas
GROUP BY TO_CHAR(fecha_venta, 'YYYY-MM')
)
SELECT
mes,
total_mes,
LAG(total_mes) OVER (ORDER BY mes) AS mes_anterior,
total_mes - LAG(total_mes) OVER (ORDER BY mes) AS variacion
FROM mensual
Suma acumulada (Running Total)
SELECT
fecha_venta,
total,
SUM(total) OVER (
ORDER BY fecha_venta
ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
) AS acumulado
FROM ventas
ORDER BY fecha_venta;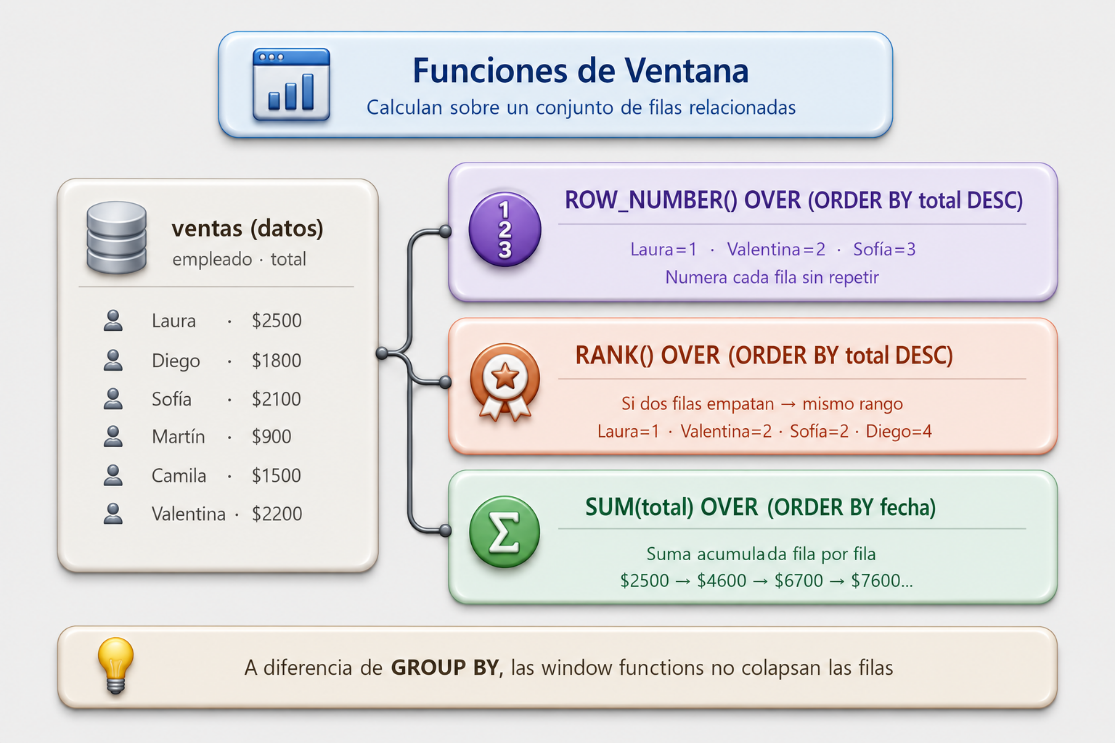
3.3 Índices — Optimización de consultas
Los índices aceleran las búsquedas en tablas grandes. Son estructuras de datos adicionales que el motor usa para encontrar filas rápidamente.
Tipos de índices
| Tipo | Descripción |
|---|---|
| PRIMARY KEY | Índice único automático en la clave primaria |
| UNIQUE | Garantiza valores únicos en la columna |
| INDEX / KEY | Índice estándar no único, acelera búsquedas |
| COMPOSITE | Índice sobre múltiples columnas |
| FULLTEXT | Para búsquedas de texto completo |
-- Crear índice en columna de búsqueda frecuente
CREATE INDEX idx_ciudad ON clientes(ciudad);
-- Índice compuesto (para consultas con WHERE a+b)
CREATE INDEX idx_venta_fecha ON ventas(id_cliente, fecha_venta);
-- Índice único
CREATE UNIQUE INDEX idx_email_unico ON clientes(email);
-- Ver índices de una tabla
SELECT indexname, indexdef FROM pg_indexes WHERE tablename = 'clientes';
-- Eliminar un índice
DROP INDEX idx_ciudad ON clientes;Los índices aceleran las lecturas pero ralentizan las escrituras (INSERT/UPDATE/DELETE). Indexar columnas usadas frecuentemente en WHERE, JOIN y ORDER BY.
EXPLAIN — Analizar el plan de ejecución
-- Ver cómo MySQL ejecuta la consulta
EXPLAIN SELECT c.nombre, SUM(v.total)
FROM clientes c
JOIN ventas v ON c.id_cliente = v.id_cliente
WHERE c.ciudad = 'Córdoba'
GROUP BY c.nombre;
-- Columnas clave en EXPLAIN:
-- type: 'ALL' = full scan (malo), 'ref'/'eq_ref' = usa índice (bueno)
-- key: índice que se usa
-- rows: estimación de filas a leer
3.4 Transacciones
Una transacción es un conjunto de operaciones que se ejecutan como una unidad. O todas se completan (COMMIT) o ninguna (ROLLBACK). Garantizan la integridad de los datos (propiedades ACID).
| Propiedad ACID | Descripción |
|---|---|
| Atomicidad | Todas las operaciones se ejecutan o ninguna |
| Consistencia | La BD pasa de un estado válido a otro válido |
| Aislamiento | Transacciones concurrentes no interfieren entre sí |
| Durabilidad | Los cambios confirmados persisten ante fallos |
-- Iniciar transacción
BEGIN;
-- Operaciones dentro de la transacción
INSERT INTO ventas (id_venta, id_cliente, id_empleado, fecha_venta, total)
VALUES (1001, 5, 2, NOW(), 1499.98);
INSERT INTO detalle_ventas (id_detalle, id_venta, id_producto, cantidad, precio_unitario)
VALUES (2001, 1001, 15, 2, 749.99);
UPDATE productos SET stock = stock - 2 WHERE id_producto = 15;
-- Si todo salió bien, confirmar
COMMIT;
-- Si algo falló, revertir todo
-- ROLLBACK;
SAVEPOINT — Puntos de guardado
BEGIN;
INSERT INTO clientes ... ;
SAVEPOINT sp1;
INSERT INTO ventas ... ;
-- Si esta falla, volver solo a sp1
ROLLBACK TO SAVEPOINT sp1;
-- Continuar desde sp1...
COMMIT;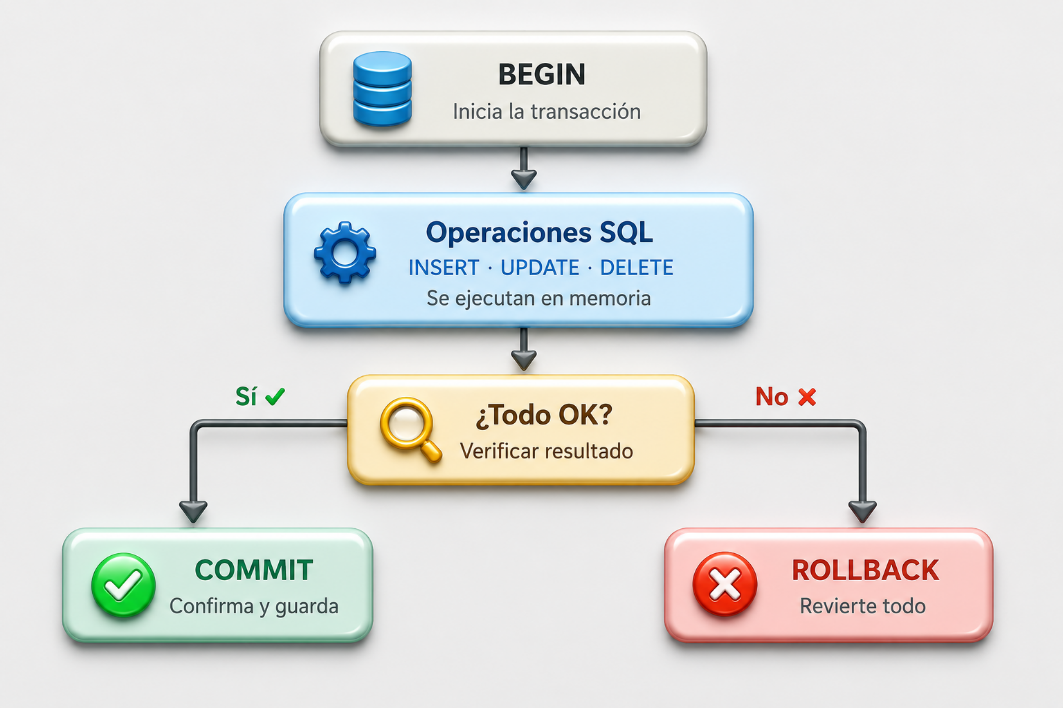
3.5 Procedimientos Almacenados y Funciones
Los procedimientos almacenados son bloques de código SQL que se guardan en la base de datos y se pueden ejecutar cuando se necesitan. Las funciones devuelven un valor.
Procedimiento almacenado
CREATE PROCEDURE registrar_venta(
IN p_id_cliente INT,
IN p_id_empleado INT,
IN p_id_producto INT,
IN p_cantidad INT
)
BEGIN
DECLARE v_precio NUMERIC(10,2);
DECLARE v_id_venta INT;
DECLARE v_total NUMERIC(10,2);
-- Obtener precio del producto
SELECT precio INTO v_precio
FROM productos WHERE id_producto = p_id_producto;
SET v_total = v_precio * p_cantidad;
SET v_id_venta = (SELECT COALESCE(MAX(id_venta),0)+1 FROM ventas);
-- Insertar venta
INSERT INTO ventas (id_venta, id_cliente, id_empleado, fecha_venta, total)
VALUES (v_id_venta, p_id_cliente, p_id_empleado, NOW(), v_total);
-- Insertar detalle
INSERT INTO detalle_ventas
(id_detalle, id_venta, id_producto, cantidad, precio_unitario)
VALUES
((SELECT COALESCE(MAX(id_detalle),0)+1 FROM detalle_ventas), v_id_venta, p_id_producto, p_cantidad, v_precio);
-- Actualizar stock
UPDATE productos SET stock = stock - p_cantidad
WHERE id_producto = p_id_producto;
SELECT CONCAT('Venta ', v_id_venta, ' registrada por $', v_total) AS resultado;
END;
$$;

-- Ejecutar el procedimiento
CALL registrar_venta(3, 1, 10, 2);
Función almacenada
CREATE FUNCTION calcular_descuento(precio NUMERIC(10,2), pct INT)
RETURNS NUMERIC(10,2)
DETERMINISTIC
BEGIN
RETURN precio - (precio * pct / 100);
END;
$$;
-- Usar la función
SELECT nombre, precio,
calcular_descuento(precio, 15) AS precio_con_15pct_dto
FROM productos WHERE stock > 0;
3.6 Estrategias de Optimización
Escribir SQL que funcione es el primer paso. Escribir SQL eficiente es lo que marca la diferencia en producción.
| Práctica | Recomendación |
|---|---|
| Selección de columnas | Evitar SELECT *; listar solo las columnas necesarias |
| Filtros tempranos | Aplicar WHERE lo antes posible para reducir filas |
| Índices en JOINs | Indexar las columnas usadas en ON |
| Evitar funciones en WHERE | WHERE EXTRACT(YEAR FROM fecha) = 2024 no usa índices; usar BETWEEN |
| Limitar resultados | Usar LIMIT cuando no se necesitan todos los registros |
| CTEs vs subqueries | CTEs son más legibles; subqueries correlacionadas suelen ser lentas |
| EXISTS vs IN | EXISTS suele ser más rápido que IN en subqueries grandes |
-- ❌ Lento: función en WHERE no usa índice
SELECT * FROM ventas WHERE EXTRACT(YEAR FROM fecha_venta) = 2024;
-- ✅ Rápido: rango de fechas usa índice
SELECT * FROM ventas
WHERE fecha_venta BETWEEN '2024-01-01' AND '2024-12-31';
-- ❌ Lento: SELECT *
SELECT * FROM clientes JOIN ventas ON ...;
-- ✅ Rápido: solo columnas necesarias
SELECT c.nombre, v.total, v.fecha_venta
FROM clientes c JOIN ventas v ON c.id_cliente = v.id_cliente;
-- ❌ Subconsulta correlacionada (ejecuta N veces)
SELECT nombre FROM productos p
WHERE precio > (SELECT AVG(precio) FROM productos p2
WHERE p2.id_categoria = p.id_categoria);
-- ✅ CTE ejecuta una sola vez
WITH avg_cat AS (
SELECT id_categoria, AVG(precio) AS avg_precio
FROM productos GROUP BY id_categoria
)
SELECT p.nombre FROM productos p
JOIN avg_cat a ON p.id_categoria = a.id_categoria
WHERE p.precio > a.avg_precio;
3.7 Ejercicios Prácticos — Avanzado
Ejercicio 11: Crear un reporte de ventas con ranking por empleado dentro de cada mes, usando funciones de ventana.
Solución SQL:
WITH ventas_empleado AS (
SELECT
e.nombre AS empleado,
TO_CHAR(v.fecha_venta, 'YYYY-MM') AS mes,
SUM(v.total) AS total_mes
FROM ventas v
JOIN empleados e ON v.id_empleado = e.id_empleado
GROUP BY e.nombre, TO_CHAR(v.fecha_venta, 'YYYY-MM')
)
SELECT
mes,
empleado,
total_mes,
RANK() OVER (PARTITION BY mes ORDER BY total_mes DESC) AS ranking
FROM ventas_empleado
ORDER BY mes, ranking;
Resultado esperado:
Ranking de empleados por ventas mensuales usando RANK() OVER PARTITION BY.
Ejercicio 12: Calcular la variación porcentual de ventas mes a mes usando LAG.
Solución SQL:
WITH mensual AS (
SELECT
TO_CHAR(fecha_venta, 'YYYY-MM') AS mes,
SUM(total) AS total
FROM ventas
GROUP BY mes
)
SELECT
mes,
total,
LAG(total) OVER (ORDER BY mes) AS mes_ant,
ROUND(
(total - LAG(total) OVER (ORDER BY mes))
/ LAG(total) OVER (ORDER BY mes) * 100, 2 ) AS variacion_pct
FROM mensual
ORDER BY mes;
Resultado esperado:
Variación porcentual mensual de ventas. Filas con NULL en la primera fila es esperado.
Ejercicio 13: Usando una CTE recursiva, calcular el factorial de 10 (ejemplo de recursión en SQL).
Solución SQL:
WITH RECURSIVE factorial AS (
SELECT 1 AS n, 1 AS resultado
UNION ALL
SELECT n + 1, resultado * (n + 1)
FROM factorial
WHERE n < 10
)
SELECT n, resultado FROM factorial;
Resultado esperado:
Tabla con n=1 a 10 y su factorial calculado recursivamente.
Ejercicio 14: Segmentar clientes en 4 cuartiles según su gasto total con NTILE.
Solución SQL:
WITH gasto AS (
SELECT id_cliente, SUM(total) AS gasto_total
FROM ventas
GROUP BY id_cliente
)
SELECT
c.nombre,
g.gasto_total,
NTILE(4) OVER (ORDER BY g.gasto_total DESC) AS cuartil
FROM clientes c
JOIN gasto g ON c.id_cliente = g.id_cliente
ORDER BY cuartil, g.gasto_total DESC;
Resultado esperado:
Clientes distribuidos en 4 cuartiles: 1=top 25%, 4=bottom 25%.
Ejercicio 15: Crear un procedimiento que dado un id_cliente devuelva su historial de compras completo con totales.
Solución SQL:
CREATE PROCEDURE historial_cliente(IN p_id INT)
BEGIN
SELECT
v.id_venta,
v.fecha_venta,
p.nombre AS producto,
dv.cantidad,
dv.precio_unitario,
dv.cantidad * dv.precio_unitario AS subtotal
FROM ventas v
JOIN detalle_ventas dv ON v.id_venta = dv.id_venta
JOIN productos p ON dv.id_producto = p.id_producto
WHERE v.id_cliente = p_id
ORDER BY v.fecha_venta DESC;
END;
$$;
CALL historial_cliente(3);
Resultado esperado:
Historial completo del cliente especificado con todos sus productos comprados.
PARTE 4 — TEMAS ADICIONALES
Esta sección cubre cuatro temas de alto valor: triggers para automatizar lógica en la base de datos, particionado para manejar tablas enormes, una guía práctica para empezar con PostgreSQL en la nube, y una comparativa detallada entre MySQL y PostgreSQL.
4.1 Triggers (Disparadores)
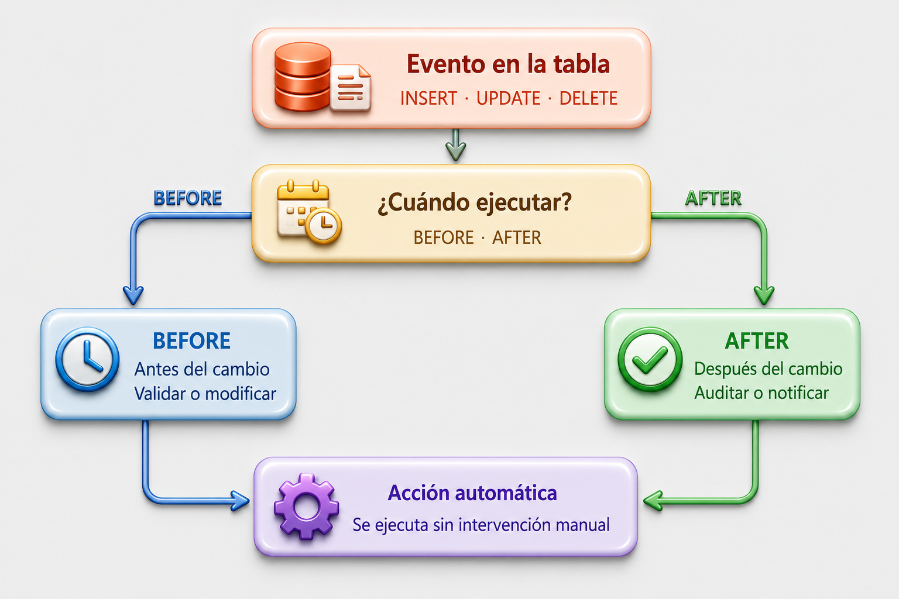
Un trigger es un bloque de código SQL que se ejecuta automáticamente cuando ocurre un evento (INSERT, UPDATE o DELETE) en una tabla. Son ideales para auditorías, validaciones y sincronización de datos.
Cuándo usar un trigger
-
Registrar quién modificó un registro y cuándo (auditoría).
-
Validar datos antes de insertarlos (más allá de constraints).
-
Actualizar automáticamente tablas relacionadas.
-
Calcular campos derivados al insertar o actualizar.
Tipos de triggers
| Tipo | Cuándo se ejecuta |
|---|---|
| BEFORE INSERT | Antes de insertar un nuevo registro |
| AFTER INSERT | Después de insertar un nuevo registro |
| BEFORE UPDATE | Antes de actualizar un registro existente |
| AFTER UPDATE | Después de actualizar un registro existente |
| BEFORE DELETE | Antes de eliminar un registro |
| AFTER DELETE | Después de eliminar un registro |
Variables especiales: NEW y OLD
Dentro de un trigger podés acceder a los valores del registro afectado:
-
NEW.columna — valor nuevo (disponible en INSERT y UPDATE).
-
OLD.columna — valor anterior (disponible en UPDATE y DELETE).
Ejemplo 1 — Auditoría de cambios de precio
-- Tabla de auditoría
CREATE TABLE auditoria_precios (
id SERIAL PRIMARY KEY,
id_producto INT,
precio_antes NUMERIC(10,2),
precio_despues NUMERIC(10,2),
usuario VARCHAR(80),
fecha_cambio DATETIME
);
-- Trigger AFTER UPDATE en productos
CREATE TRIGGER trg_auditoria_precio
AFTER UPDATE ON productos
FOR EACH ROW
BEGIN
IF OLD.precio <> NEW.precio THEN
INSERT INTO auditoria_precios
(id_producto, precio_antes, precio_despues, usuario, fecha_cambio)
VALUES
(NEW.id_producto, OLD.precio, NEW.precio, USER(), NOW());
END IF;
END;
$$;
-- Probar el trigger
UPDATE productos SET precio = 1599.99 WHERE id_producto = 5;
-- Ver el registro de auditoría
SELECT * FROM auditoria_precios;
Ejemplo 2 — Validar stock antes de una venta
CREATE TRIGGER trg_validar_stock
BEFORE INSERT ON detalle_ventas
FOR EACH ROW
BEGIN
DECLARE v_stock INT;
SELECT stock INTO v_stock FROM productos
WHERE id_producto = NEW.id_producto;
IF v_stock < NEW.cantidad THEN
SIGNAL SQLSTATE '45000'
SET MESSAGE_TEXT = 'Stock insuficiente para este producto';
END IF;
END;
$$;
Ejemplo 3 — Recalcular total de venta automáticamente
CREATE TRIGGER trg_actualizar_total
AFTER INSERT ON detalle_ventas
FOR EACH ROW
BEGIN
UPDATE ventas
SET total = (
SELECT SUM(cantidad * precio_unitario)
FROM detalle_ventas
WHERE id_venta = NEW.id_venta
)
WHERE id_venta = NEW.id_venta;
END;
$$;
Gestión de triggers
-- Ver todos los triggers de la base de datos
SELECT trigger_name, event_manipulation, event_object_table
FROM information_schema.triggers WHERE trigger_schema = 'public';
-- Ver triggers de una tabla específica
SELECT trigger_name, event_manipulation FROM information_schema.triggers
WHERE trigger_schema = 'public' AND event_object_table = 'productos';
-- Eliminar un trigger
DROP TRIGGER IF EXISTS trg_auditoria_precio;En PostgreSQL los triggers usan una sintaxis diferente: se define una función con RETURNS TRIGGER y luego se vincula con CREATE TRIGGER. Ver sección 4.3 para ejemplos en PostgreSQL.
4.1 Ejercicios — Triggers
Ejercicio 16: Crear un trigger que registre en una tabla ‘log_eliminaciones’ cada vez que se borre un cliente.
Solución SQL:
CREATE TABLE log_eliminaciones (
id SERIAL PRIMARY KEY,
tabla VARCHAR(50),
id_registro INT,
descripcion VARCHAR(200),
fecha DATETIME
);
CREATE TRIGGER trg_log_borrar_cliente
BEFORE DELETE ON clientes
FOR EACH ROW
BEGIN
INSERT INTO log_eliminaciones (tabla, id_registro, descripcion, fecha)
VALUES ('clientes', OLD.id_cliente, CONCAT('Cliente: ', OLD.nombre, ' | Email: ', OLD.email), NOW());
END;
$$;
Resultado esperado:
Cada DELETE en clientes genera automáticamente un registro en el log.
Ejercicio 17: Trigger AFTER INSERT en ventas que actualice un campo ‘ultima_compra’ en la tabla clientes.
Solución SQL:
-- Primero agregar la columna si no existe
ALTER TABLE clientes ADD COLUMN ultima_compra DATE;
CREATE TRIGGER trg_ultima_compra
AFTER INSERT ON ventas
FOR EACH ROW
BEGIN
UPDATE clientes
SET ultima_compra = NEW.fecha_venta
WHERE id_cliente = NEW.id_cliente;
END;
$$;
Resultado esperado:
Cada nueva venta actualiza automáticamente la fecha de última compra del cliente.
4.2 Particionado de Tablas
El particionado divide una tabla grande en partes más pequeñas (particiones) que se almacenan y gestionan de forma independiente, pero que se consultan como una sola tabla. Es clave cuando las tablas superan millones de registros.
¿Cuándo usar particionado?
-
Tablas con más de 10–50 millones de filas.
-
Consultas frecuentes que filtran por rango de fechas.
-
Necesidad de archivar o eliminar datos históricos rápidamente.
-
Mejora de rendimiento en tablas de logs, ventas o transacciones.
Tipos de particionado
| Tipo | Descripción | Cuándo usarlo |
|---|---|---|
| RANGE | Divide por rangos de valores (ej: fechas) | Datos con dimensión temporal |
| LIST | Divide por listas de valores discretos | Regiones, estados, categorías |
| HASH | Divide en N partes por hash de una columna | Distribución uniforme sin patrón |
| KEY | Similar a HASH pero usa función interna del motor | Claves primarias o únicas |
| COLUMNS | Variante de RANGE/LIST con múltiples columnas | Partición compuesta |
RANGE — Particionado por rango de fechas (más común)
-- Tabla de ventas particionada por año
CREATE TABLE ventas_historico (
id_venta INT NOT NULL,
id_cliente INT NOT NULL,
fecha_venta DATE NOT NULL,
total NUMERIC(10,2)
)
PARTITION BY RANGE (EXTRACT(YEAR FROM fecha_venta)) (
PARTITION p2021 VALUES LESS THAN (2022),
PARTITION p2022 VALUES LESS THAN (2023),
PARTITION p2023 VALUES LESS THAN (2024),
PARTITION p2024 VALUES LESS THAN (2025),
PARTITION p2025 VALUES LESS THAN (2026),
PARTITION p_futuro VALUES LESS THAN MAXVALUE
);
LIST — Particionado por lista de valores
-- Tabla de clientes particionada por región
CREATE TABLE clientes_regional (
id_cliente INT NOT NULL,
nombre VARCHAR(80) NOT NULL,
region VARCHAR(20) NOT NULL
)
PARTITION BY LIST COLUMNS (region) (
PARTITION p_norte VALUES IN ('Jujuy','Salta','Tucumán','Santiago del Estero'),
PARTITION p_centro VALUES IN ('Córdoba','Santa Fe','Entre Ríos'),
PARTITION p_sur VALUES IN ('Neuquén','Río Negro','Chubut','Santa Cruz'),
PARTITION p_ba VALUES IN ('Buenos Aires','La Plata','CABA')
);
HASH — Distribución uniforme
-- Dividir productos en 4 particiones por hash del id
CREATE TABLE productos_distribuido (
id_producto INT NOT NULL,
nombre VARCHAR(100) NOT NULL,
precio NUMERIC(10,2)
)
PARTITION BY HASH (id_producto)
PARTITIONS 4;
Gestión de particiones
-- Ver las particiones de una tabla
SELECT PARTITION_NAME, TABLE_ROWS, DATA_LENGTH
FROM information_schema.PARTITIONS
WHERE TABLE_NAME = 'ventas_historico';
-- Agregar una nueva partición
ALTER TABLE ventas_historico
REORGANIZE PARTITION p_futuro INTO (
PARTITION p2026 VALUES LESS THAN (2027),
PARTITION p_futuro VALUES LESS THAN MAXVALUE
);
-- Eliminar una partición (borra los datos de ese rango)
ALTER TABLE ventas_historico DROP PARTITION p2021;
-- Truncar una partición (vaciarla sin eliminar la estructura)
ALTER TABLE ventas_historico TRUNCATE PARTITION p2022;
Partition Pruning — Cómo el motor optimiza
Cuando una consulta incluye la columna de particionado en el WHERE, el motor solo lee las particiones relevantes, ignorando el resto. Esto se llama partition pruning.
-- Esta consulta solo lee la partición p2024
SELECT * FROM ventas_historico
WHERE fecha_venta BETWEEN '2024-01-01' AND '2024-12-31';
-- Verificar con EXPLAIN PARTITIONS
EXPLAIN SELECT * FROM ventas_historico
WHERE fecha_venta BETWEEN '2024-01-01' AND '2024-12-31';
-- La columna 'partitions' muestra qué particiones se leenEn MySQL, la columna de particionado debe estar incluida en la clave primaria o en un índice único. En PostgreSQL el particionado se declara con PARTITION BY en la tabla padre y tablas hijas con ATTACH PARTITION.
Particionado en PostgreSQL
-- Tabla padre (no almacena datos directamente)
CREATE TABLE ventas_pg (
id_venta INT NOT NULL,
fecha_venta DATE NOT NULL,
total NUMERIC(10,2)
) PARTITION BY RANGE (fecha_venta);
-- Particiones hijas
CREATE TABLE ventas_2024
PARTITION OF ventas_pg
FOR VALUES FROM ('2024-01-01') TO ('2025-01-01');
CREATE TABLE ventas_2025
PARTITION OF ventas_pg
FOR VALUES FROM ('2025-01-01') TO ('2026-01-01');
-- Las consultas a ventas_pg se dirigen automáticamente
SELECT * FROM ventas_pg WHERE fecha_venta >='2024-06-01';
4.3 Guía de Inicio: PostgreSQL con Neon.tech
Neon.tech es una plataforma de PostgreSQL serverless en la nube. No requiere instalar nada: creas una cuenta, levantas una base de datos en segundos y empezás a escribir SQL desde el navegador. Ideal para aprender y para proyectos personales.
Paso 1 — Crear cuenta y base de datos
-
Ir a https://neon.tech y hacer clic en ‘Sign Up’ (gratuito).
-
Elegir ‘Create a project’, asignarle un nombre (ej: techstore).
-
Neon crea automáticamente una base de datos y te muestra la connection string.
-
Guardar el connection string — lo necesitarás para conectarte desde código.
Paso 2 — Usar el SQL Editor en el navegador
-
Desde el dashboard de Neon, ir a la sección ‘SQL Editor’.
-
Podes escribir y ejecutar cualquier sentencia SQL directamente.
-
El editor tiene autocompletado, historial y visualización de resultados en tabla.
Paso 3 — Crear el esquema TechStore en Neon
-- PostgreSQL usa SERIAL o GENERATED ALWAYS AS IDENTITY
-- en lugar de AUTO_INCREMENT de MySQL
CREATE TABLE categorias (
id_categoria SERIAL PRIMARY KEY,
nombre VARCHAR(50) NOT NULL,
descripcion VARCHAR(200)
);
CREATE TABLE clientes (
id_cliente SERIAL PRIMARY KEY,
nombre VARCHAR(80) NOT NULL,
email VARCHAR(100) UNIQUE NOT NULL,
ciudad VARCHAR(60),
fecha_registro DATE NOT NULL DEFAULT CURRENT_DATE
);
CREATE TABLE productos (
id_producto SERIAL PRIMARY KEY,
nombre VARCHAR(100) NOT NULL,
id_categoria INT REFERENCES categorias(id_categoria),
precio NUMERIC(10,2) NOT NULL,
stock INT DEFAULT 0
);
CREATE TABLE ventas (
id_venta SERIAL PRIMARY KEY,
id_cliente INT REFERENCES clientes(id_cliente),
fecha_venta DATE NOT NULL DEFAULT CURRENT_DATE,
total NUMERIC(10,2)
);
Paso 4 — Trigger en PostgreSQL (sintaxis diferente)
En PostgreSQL, los triggers requieren primero crear una función que retorne TRIGGER, y luego vincularla con CREATE TRIGGER.
-- 1. Crear la función del trigger
CREATE OR REPLACE FUNCTION fn_auditoria_precio()
RETURNS TRIGGER AS $$
BEGIN
IF OLD.precio IS DISTINCT FROM NEW.precio THEN
INSERT INTO auditoria_precios
(id_producto, precio_antes, precio_despues, fecha_cambio)
VALUES
(NEW.id_producto, OLD.precio, NEW.precio, NOW());
END IF;
RETURN NEW;
END;
$$ LANGUAGE plpgsql;

-- 2. Crear el trigger y vincularlo a la función
CREATE TRIGGER trg_auditoria_precio
AFTER UPDATE ON productos
FOR EACH ROW
EXECUTE FUNCTION fn_auditoria_precio();
Paso 5 — Conectar desde Python (psycopg2)
# Instalar: pip install psycopg2-binary
import psycopg2
conn = psycopg2.connect(
host = 'ep-xxx.us-east-2.aws.neon.tech',
database = 'techstore',
user = 'tu_usuario',
password = 'tu_password',
sslmode = 'require' # Neon requiere SSL
)
cur = conn.cursor()
cur.execute('SELECT nombre, precio FROM productos WHERE stock >0')
rows = cur.fetchall()
for row in rows:
print(row)
conn.close()
Paso 6 — Conectar desde Node.js
// npm install @neondatabase/serverless
import { neon } from '@neondatabase/serverless';
const sql = neon(process.env.DATABASE_URL);
const productos = await sql`
SELECT nombre, precio FROM productos
WHERE stock > 0
ORDER BY precio DESC`;
console.log(productos);El plan gratuito de Neon incluye 0.5 GB de almacenamiento, 190 horas de compute por mes y branching (podés crear ramas de tu BD como con Git). Es más que suficiente para aprender y proyectos personales.
4.4 Referencia: diferencias de sintaxis con MySQL
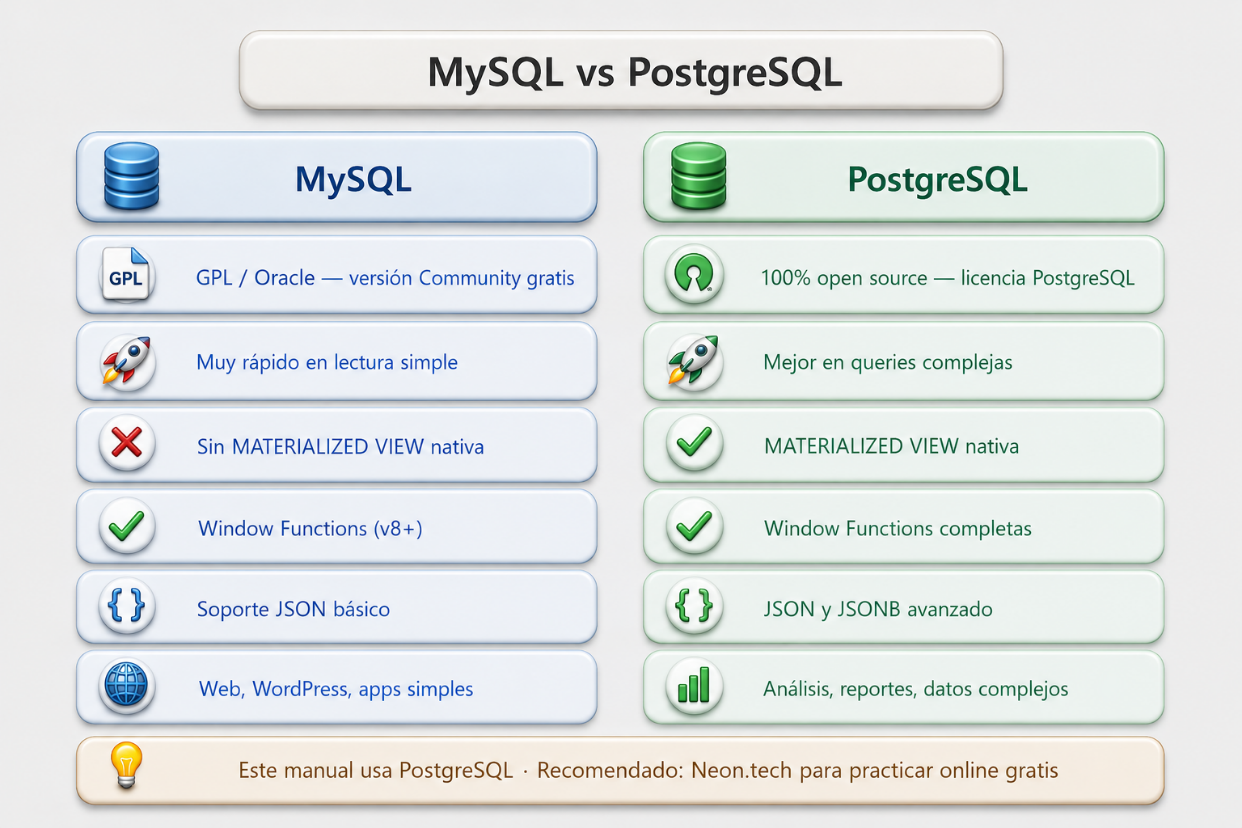
Ambos son excelentes bases de datos relacionales open source. La elección depende del caso de uso. Acá vas a ver las diferencias más importantes para tomar una decisión informada.
Comparativa general
| Característica | MySQL | PostgreSQL |
|---|---|---|
| Licencia | GPL (Community) / Comercial | PostgreSQL License (muy permisiva) |
| Creador/Mantenedor | Oracle | PostgreSQL Global Dev Group |
| Año de creación | 1995 | 1996 |
| Cumplimiento SQL estándar | Parcial | Alto (más cercano al estándar) |
| ACID completo | Sí (InnoDB) | Sí (siempre) |
| Rendimiento en lectura | Muy alto (simple queries) | Alto (consultas complejas) |
| Rendimiento en escritura | Muy alto | Alto |
| Extensibilidad | Limitada | Muy alta (tipos, funciones, extensiones) |
| JSON nativo | Básico (JSON type) | Avanzado (JSONB con índices) |
| Full Text Search | Básico | Avanzado |
| Particionado | Sí (limitado) | Sí (robusto desde v10) |
| CTEs recursivas | Desde 8.0 | Sí (desde hace tiempo) |
| Window Functions | Desde 8.0 | Completo |
| Popularidad web | #1 en apps web/PHP | #1 en apps empresariales |
Diferencias de sintaxis más importantes
| Concepto | MySQL | PostgreSQL |
|---|---|---|
| Auto-incremento | AUTO_INCREMENT | SERIAL o GENERATED ALWAYS AS IDENTITY |
| Límite de filas | LIMIT n | LIMIT n (igual) |
| Fecha actual | NOW() / CURRENT_DATE | NOW() / CURRENT_DATE |
| Concatenar texto | CONCAT(a,b) | CONCAT(a,b) o a || b |
| Formato de fecha | TO_CHAR(d, ‘YYYY-MM’) | TO_CHAR(d, ‘YYYY-MM’) |
| Diferencia de fechas | (a::DATE - b::DATE) | AGE(a,b) o a - b |
| Extraer parte de fecha | EXTRACT(YEAR FROM d), EXTRACT(MONTH FROM d) | EXTRACT(YEAR FROM d) |
| Longitud de cadena | LENGTH(s) | LENGTH(s) o CHAR_LENGTH(s) |
| Ignorar mayúsculas en LIKE | LIKE (no distingue por defecto) | ILIKE |
| Texto ilimitado | TEXT o LONGTEXT | TEXT |
| Triggers | CREATE TRIGGER + BEGIN…END | Función RETURNS TRIGGER + CREATE TRIGGER |
| Upsert | INSERT … ON DUPLICATE KEY UPDATE | INSERT … ON CONFLICT DO UPDATE |
| Comillas para identificadores | Backticks `tabla` | Comillas dobles “tabla” |
Ejemplos de sintaxis comparada
-- ── AUTO-INCREMENTO ────────────────────────────────────
CREATE TABLE items (id SERIAL PRIMARY KEY, ...);
-- O moderno:
CREATE TABLE items (id INT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,...);
-- ── FORMATO DE FECHA ────────────────────────────────────
SELECT TO_CHAR(fecha_venta, 'YYYY-MM') AS mes FROM ventas;
-- ── UPSERT ──────────────────────────────────────────────
INSERT INTO productos (id_producto, nombre, precio)
VALUES (1, 'Tablet', 599.99)
ON CONFLICT (id_producto) DO UPDATE SET precio = EXCLUDED.precio;
-- ── BÚSQUEDA SIN DISTINCIÓN DE MAYÚSCULAS ───────────────
-- MySQL (no distingue por defecto en collation ci)
SELECT * FROM clientes WHERE nombre LIKE '%maria%';
-- PostgreSQL (usa ILIKE para ignorar mayúsculas)
SELECT * FROM clientes WHERE nombre ILIKE '%maria%';
JSONB en PostgreSQL — Una ventaja importante
PostgreSQL ofrece JSONB (JSON binario) que permite almacenar y consultar documentos JSON con índices, algo que MySQL no hace tan bien.
-- Crear tabla con columna JSONB
CREATE TABLE productos_extra (
id_producto INT PRIMARY KEY,
nombre VARCHAR(100),
atributos JSONB -- especificaciones técnicas variables
);
-- Insertar datos JSON
INSERT INTO productos_extra VALUES
(1, 'Laptop Pro', '{"ram": 16, "ssd": 512, "pantalla": "15.6"}'),
(2, 'Tablet Air', '{"ram": 8, "ssd": 256, "pantalla": "10.9"}');
-- Consultar campo JSON con operador ->
SELECT nombre, atributos->>'ram' AS ram_gb
FROM productos_extra
WHERE (atributos->>'ram')::INT >= 16;
-- Índice sobre campo JSON
CREATE INDEX idx_ram ON productos_extra ((atributos->>'ram'));
4.4 Ejercicios — PostgreSQL
Ejercicio 18: Reescribir esta consulta MySQL a sintaxis PostgreSQL: obtener ventas por mes con formato ‘Enero 2024’.
Solución SQL:
-- MySQL (original)
-- SELECT DATE_FORMAT(fecha_venta,'%M %Y') AS mes, SUM(total)
-- FROM ventas GROUP BY DATE_FORMAT(fecha_venta,'%M %Y');
-- PostgreSQL (solución)
SELECT
TO_CHAR(fecha_venta, 'TMMonth YYYY') AS mes,
SUM(total) AS facturacion
FROM ventas
GROUP BY TO_CHAR(fecha_venta, 'TMMonth YYYY'),
DATE_TRUNC('month', fecha_venta)
ORDER BY DATE_TRUNC('month', fecha_venta);
Resultado esperado:
TO_CHAR con ‘TM’ usa el nombre del mes en el idioma del locale del servidor.
Ejercicio 19: En PostgreSQL, crear una tabla de logs con JSONB para almacenar datos variables de eventos de sistema.
Solución SQL:
CREATE TABLE sistema_logs (
id SERIAL PRIMARY KEY,
evento VARCHAR(50) NOT NULL,
datos JSONB,
created_at TIMESTAMPTZ DEFAULT NOW()
);
-- Insertar eventos con estructura variable
INSERT INTO sistema_logs (evento, datos) VALUES
('login', '{"usuario": "ana", "ip": "192.168.1.10", "exito":true}'),
('compra', '{"id_venta": 1001, "total": 1499.99, "productos":3}'),
('error', '{"codigo": 500, "msg": "Timeout", "endpoint":"/api/ventas"}');
-- Consultar logs de compras con total > 1000
SELECT evento, datos->>'id_venta' AS venta,
(datos->>'total')::NUMERIC AS total
FROM sistema_logs
WHERE evento = 'compra'
AND (datos->>'total')::NUMERIC > 1000;
Resultado esperado:
Tabla flexible con JSONB que permite estructuras de datos distintas por tipo de evento.
Ejercicio 20: Crear un trigger en PostgreSQL que actualice ‘ultima_compra’ en clientes al insertar una venta.
Solución SQL:
-- 1. Agregar columna
ALTER TABLE clientes ADD COLUMN ultima_compra DATE;
-- 2. Crear la función
CREATE OR REPLACE FUNCTION fn_actualizar_ultima_compra()
RETURNS TRIGGER AS $$
BEGIN
UPDATE clientes
SET ultima_compra = NEW.fecha_venta
WHERE id_cliente = NEW.id_cliente
AND (ultima_compra IS NULL OR ultima_compra < NEW.fecha_venta);
RETURN NEW;
END;
$$ LANGUAGE plpgsql;
-- 3. Vincular el trigger
CREATE TRIGGER trg_ultima_compra
AFTER INSERT ON ventas
FOR EACH ROW
EXECUTE FUNCTION fn_actualizar_ultima_compra();
Resultado esperado:
El trigger solo actualiza si la nueva fecha es más reciente que la almacenada.
GLOSARIO DE TÉRMINOS SQL
| Término | Definición |
|---|---|
| DDL | Data Definition Language. Comandos para definir estructuras (CREATE, ALTER, DROP). |
| DML | Data Manipulation Language. Comandos para manipular datos (INSERT, UPDATE, DELETE). |
| DQL | Data Query Language. Comando de consulta (SELECT). |
| Clave primaria (PK) | Columna que identifica de forma única cada fila de una tabla. |
| Clave foránea (FK) | Columna que referencia la PK de otra tabla, estableciendo una relación. |
| JOIN | Operación que combina filas de dos tablas basándose en una condición de unión. |
| Índice | Estructura que acelera las búsquedas en tablas a costa de espacio adicional. |
| Vista (VIEW) | Consulta almacenada que se comporta como una tabla virtual. |
| CTE | Common Table Expression. Subconsulta nombrada definida con WITH. |
| Función de ventana | Función que opera sobre un conjunto de filas relacionadas sin colapsar el resultado. |
| Transacción | Unidad de trabajo que se confirma o revierte de forma atómica. |
| ACID | Propiedades de las transacciones: Atomicidad, Consistencia, Aislamiento, Durabilidad. |
| Subquery | Consulta anidada dentro de otra consulta SQL. |
| Cardinalidad | Número de valores únicos en una columna. Alta cardinalidad = mejor candidato a índice. |
| NULL | Valor especial que representa ausencia de dato (distinto de 0 o cadena vacía). |
| EXPLAIN | Comando para ver el plan de ejecución de una consulta y analizar su rendimiento. |
| Procedimiento almacenado | Bloque de código SQL guardado en la BD y ejecutable con CALL. |
| PARTITION BY | Cláusula de funciones de ventana que divide los datos en grupos para el cálculo. |
| ROLLBACK | Revertir todos los cambios de una transacción no confirmada. |
| COMMIT | Confirmar y guardar permanentemente todos los cambios de una transacción. |
REFERENCIA RÁPIDA — COMANDOS SQL
-- ═══════════════════════════════════════════════════════
-- DDL
CREATE TABLE t (col1 tipo, col2 tipo, PRIMARY KEY(col1));
ALTER TABLE t ADD COLUMN nueva tipo;
ALTER TABLE t DROP COLUMN vieja;
DROP TABLE IF EXISTS t;
TRUNCATE TABLE t;
-- ═══════════════════════════════════════════════════════
-- DML
INSERT INTO t (c1,c2) VALUES (v1,v2);
UPDATE t SET c1=v1 WHERE condicion;
DELETE FROM t WHERE condicion;
-- ═══════════════════════════════════════════════════════
-- SELECT
SELECT c1, c2 FROM t WHERE cond GROUP BY c1 HAVING cond2 ORDER BY c1
LIMIT n;
-- ═══════════════════════════════════════════════════════
-- JOINS
SELECT ... FROM a INNER JOIN b ON a.id = b.id;
SELECT ... FROM a LEFT JOIN b ON a.id = b.id;
SELECT ... FROM a RIGHT JOIN b ON a.id = b.id;
-- ═══════════════════════════════════════════════════════
-- FUNCIONES DE VENTANA
ROW_NUMBER() OVER (PARTITION BY col ORDER BY col2)
RANK() OVER (PARTITION BY col ORDER BY col2)
LAG(col, 1) OVER (ORDER BY col2)
LEAD(col, 1) OVER (ORDER BY col2)
SUM(col) OVER (ORDER BY col2 ROWS UNBOUNDED PRECEDING)
-- ═══════════════════════════════════════════════════════
-- CTEs
WITH nombre_cte AS (SELECT ...) SELECT * FROM nombre_cte;
-- ═══════════════════════════════════════════════════════
-- TRANSACCIONES
BEGIN; ... COMMIT; -- o ROLLBACK;
BIBLIOGRAFÍA Y REFERENCIAS
Las siguientes fuentes fueron consultadas directamente durante la elaboración de este manual. El contenido teórico, los ejemplos y las referencias sintácticas se basan en estos documentos.
Libros de referencia teórica
Silberschatz, A., Korth, H. F. y Sudarshan, S. (2010). Database System Concepts (6.ª ed.). McGraw-Hill.
Consultado online para los conceptos de transacciones (ACID), propiedades de aislamiento, tipos de índices y optimización de consultas. Base teórica de las secciones 3.3, 3.4 y 3.6.
Silberschatz, A., Korth, H. F. y Sudarshan, S. (2006). Fundamentos de Bases de Datos (4.ª ed.). McGraw-Hill. ISBN: 978-84-481-4644-1.
Edición en castellano del libro anterior. El PDF fue utilizado directamente como fuente de referencia para los capítulos de normalización, diseño relacional e integridad referencial presentes en la serie completa de manuales.
Documentación oficial de motores SQL
Oracle Corporation. (2024). MySQL 8.0 Reference Manual. Recuperado de https://dev.mysql.com/doc/refman/8.0/en/
Fuente principal para la sintaxis de MySQL: DDL, DML, triggers, particionado (RANGE, LIST, HASH), procedimientos almacenados, DELIMITER, funciones de fecha y EVENT SCHEDULER. Secciones 1.2, 1.3, 3.5, 4.1 y 4.2.
The PostgreSQL Global Development Group. (2024). PostgreSQL 16 Documentation. Recuperado de https://www.postgresql.org/docs/16/
Fuente para la sintaxis específica de PostgreSQL: CREATE MATERIALIZED VIEW, REFRESH MATERIALIZED VIEW CONCURRENTLY, JSONB con operadores ->>, ILIKE, ON CONFLICT DO UPDATE (UPSERT), funciones RETURNS TRIGGER y particionado con PARTITION OF. Secciones 2.4, 4.3 y 4.4.
Neon Technologies Inc. (2024). Neon Documentation — Serverless PostgreSQL. Recuperado de https://neon.tech/docs
Utilizada para la guía práctica de inicio en la nube: creación de proyectos, SQL Editor online, connection strings, plan gratuito y branching. Sección 4.3.
Nota: las URLs de documentación oficial fueron verificadas y se encontraban activas al momento de la elaboración de este manual (2026). El contenido de Silberschatz fue consultado tanto en versión online (6.ª ed.) como en el PDF en castellano de la 4.ª edición provisto por el autor del manual.
Archivos de práctica
Los scripts y recursos de este manual, para descargar y practicar en tu propio entorno.